


引言
人工智能和深度学习领域正面临一个关键节点,传统电子处理器难以跟上计算需求的指数级增长。随着摩尔定律放缓和数字处理器能耗要求持续上升,研究人员正转向利用光的独特特性进行计算的创新解决方案。在这些新兴技术中,光电子集成芯片代表了加速矩阵向量乘法运算的最具潜力的平台之一,而矩阵向量乘法正是现代神经网络的计算基础[1]。
传统光子方法面临的挑战
使用光电子技术的矩阵向量乘法处理器传统上主要依赖两种方法:波长复用和模式复用。在波长复用方案中,不同颜色的光承载独立的信息片段,然后将这些信息组合起来执行计算。然而,这种方法面临显著的可扩展性挑战。对于N×N矩阵,至少需要N个不同的波长,这为大规模实现带来了巨大的技术障碍。对多个相干光源或复杂光谱整形的需求使片上集成变得极其困难,而高插入损耗和波长串扰等问题进一步限制了此类系统的实际规模。
模式复用提供了另一种选择,即在同一波导内利用光的不同空间模式承载信息。虽然消除了对多个波长的需求,但引入了自身的问题集合。使用多模干涉耦合器的光束合成方法产生的本征损耗随输入数量急剧增加,严重限制了可实现的最大系统规模。
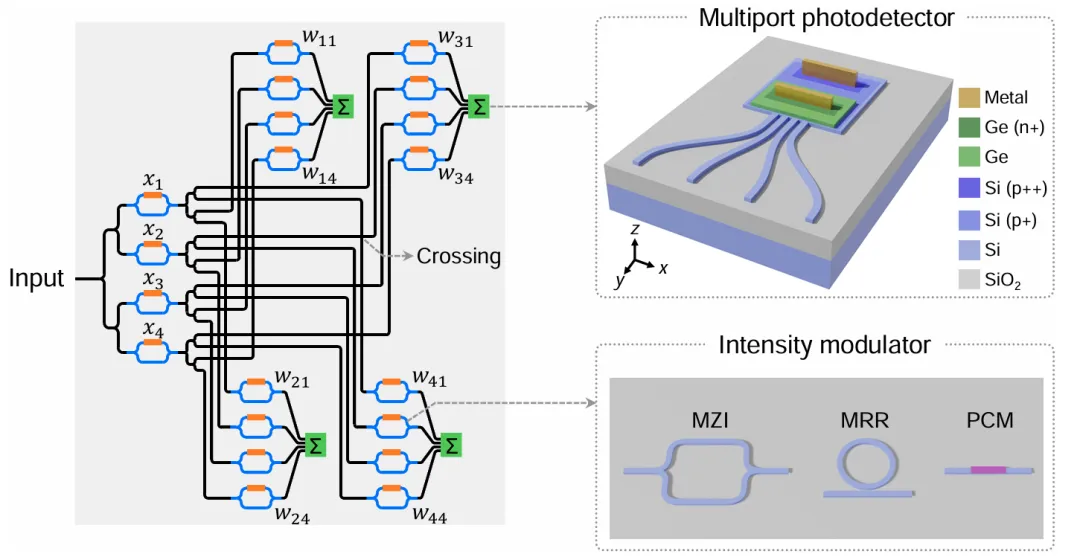
图1:使用单波导层平台的4×4波导复用线路示意图,显示强度调制器(MZI、MRR或PCM吸收器)和使用Ge-on-Si垂直p-i-n结构实现的多端口光电探测器。
波导复用技术介绍
本研究提出的创新方法以波导复用概念为核心,从根本上改变了光信号组合进行计算的方式。这种方法不依赖多个波长或模式,而是使用多端口光电探测器直接对来自多个独立波导的光强度进行求和。这一优雅的解决方案消除了困扰以往光子计算架构的许多可扩展性瓶颈。
系统使用单一波长的光工作,首先通过强度调制器阵列进行分束和调制以生成输入向量。然后将此向量进一步分割并路由到实现计算矩阵每一行的附加调制器阵列。关键创新在于如何组合这些调制信号:不是在检测前光学组合,而是每个多端口光电探测器直接接收多个光信号并产生与总功率成比例的光电流。
多端口光电探测器技术
这种方法的核心在于多端口光电探测器,这是一种能够同时从多个输入端口吸收光并产生单一电输出的精密器件。研究展示了使用硅上垂直p-i-n结构制造的16端口锗光电探测器,实现了令人印象深刻的性能指标,包括在-3V偏置电压下11.8 GHz的3 dB带宽和0.82 A/W的响应度。
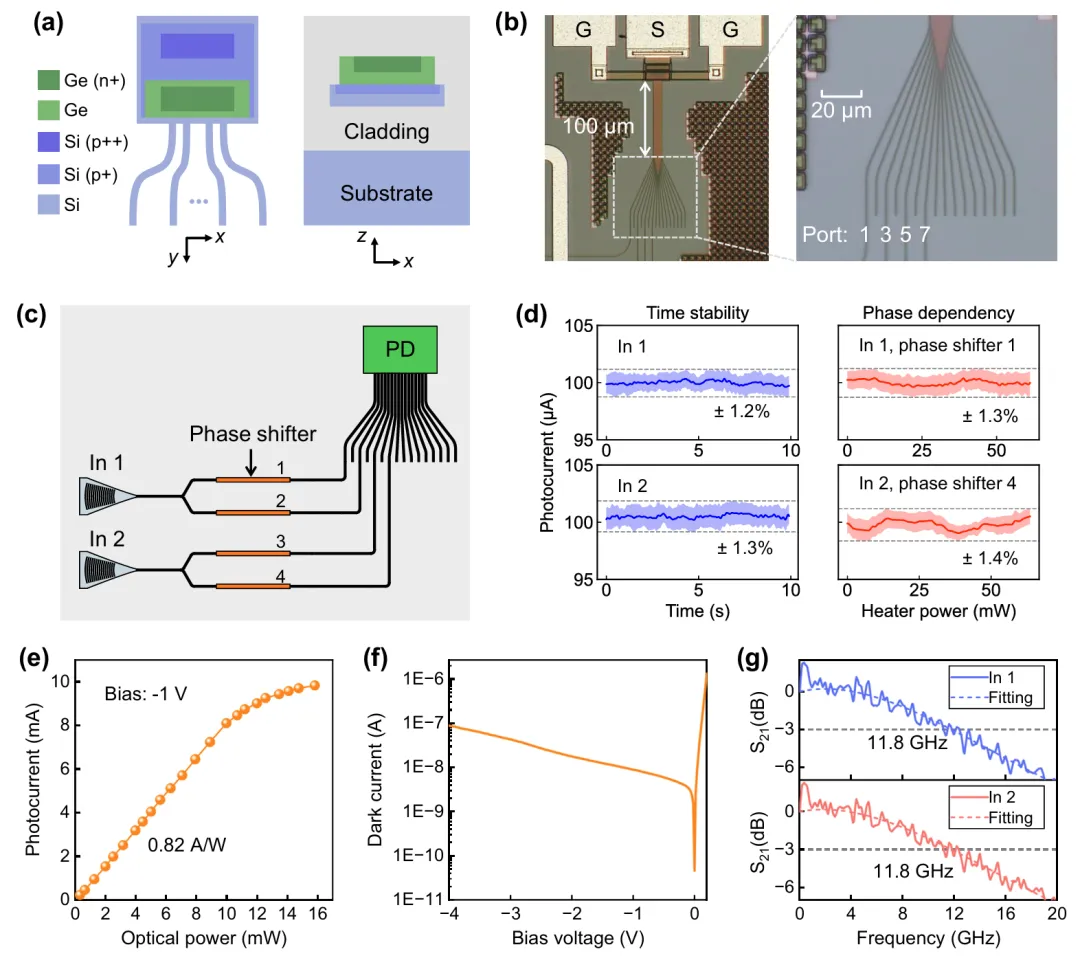
图2:多端口光电探测器的全面表征,包括(a)示意截面图,(b)制造的16端口器件,(c)实验装置,(d)时间稳定性测量,(e)线性度表征,(f)暗电流分析,以及(g)频率响应测量。
多端口光电探测器设计涉及带宽、暗电流和响应度之间的精心工程权衡。该器件具有35×13 μm²的锗吸收区域和220 nm厚的硅台面,设计用于高效捕获来自16个输入波导的光,波导宽度为440 nm,间距为300 nm。研究表明,这种技术可以扩展到支持大约250个输入端口,同时保持6.1 GHz的工作带宽,显示出大规模实现的优秀可扩展性潜力。
实验演示和性能
通过在绝缘体上硅平台上制造和测试4×4线路,验证了这种方法的实际能力。该演示系统包括20个可调谐马赫-曾德干涉仪作为强度调制器和四个4端口光电探测器,总芯片面积为2.8×3.1 mm²。
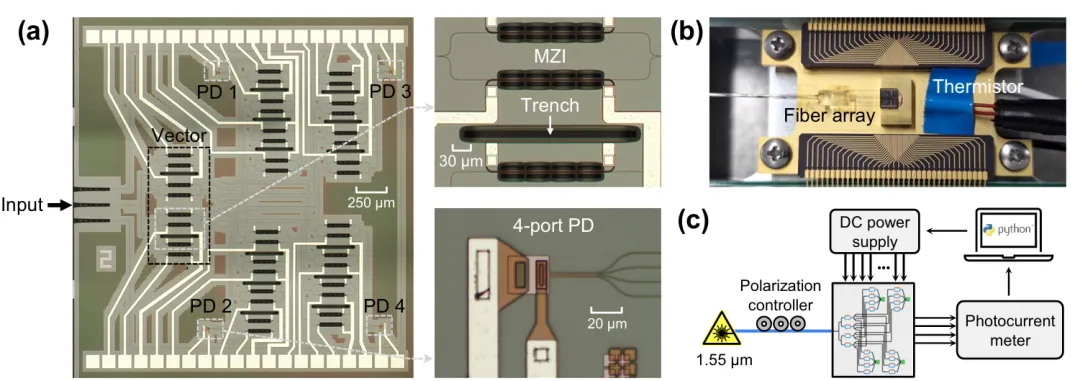
图3:物理实现显示(a)制造的4×4线路以及MZI和光电探测器组件的详细视图,(b)带光纤阵列耦合的封装器件,以及(c)完整的实验测量设置。
实验验证涉及对500个随机生成的矩阵向量运算进行线路性能的全面表征。结果显示了显著的保真度,决定系数(R²)为0.991,表明测量输出与理论预期密切匹配。计算得出的位精度为6.2位,对许多实际机器学习应用来说代表了足够的精度。
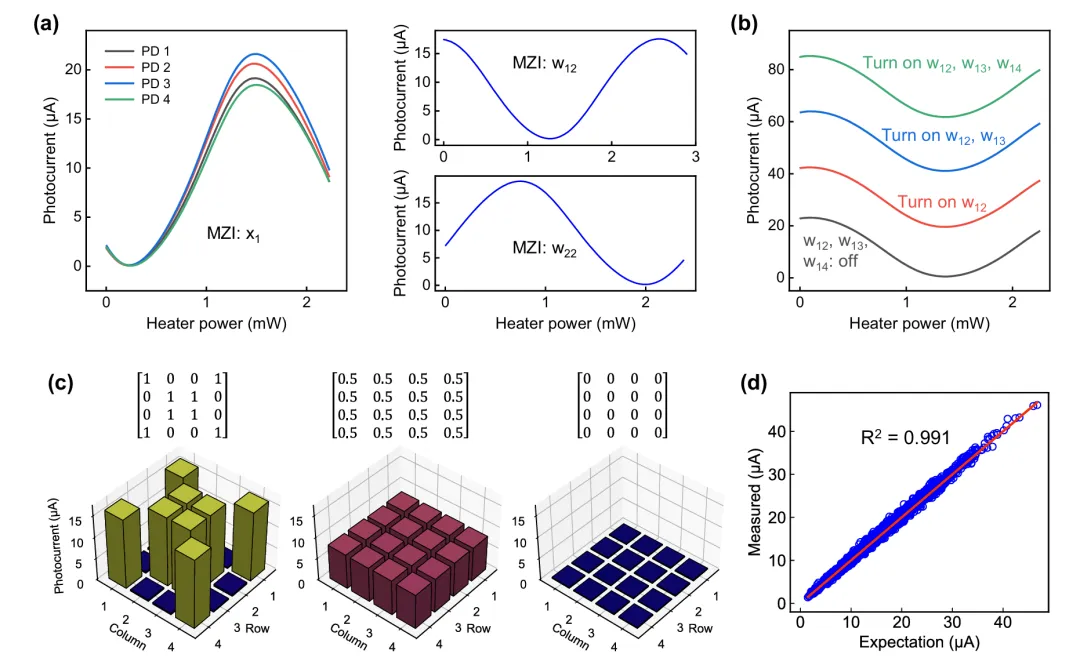
图4:详细性能表征,包括(a)单个调制器响应,(b)各种条件下的多端口光电探测器行为,(c)实现的测试矩阵,以及(d)500次随机运算中预期结果与测量结果的相关性。
真实应用测试
为了展示实际效用,研究人员实现了用于鸢尾花分类的三层神经网络,这是机器学习中的标准基准问题。该网络处理四个输入特征(萼片和花瓣尺寸)以将花朵分类为三个物种。使用4×4光子线路执行矩阵向量乘法,同时以计算方式处理其他运算,系统达到了93.3%的分类准确率,相比之下完全在计算机上执行时为95%。
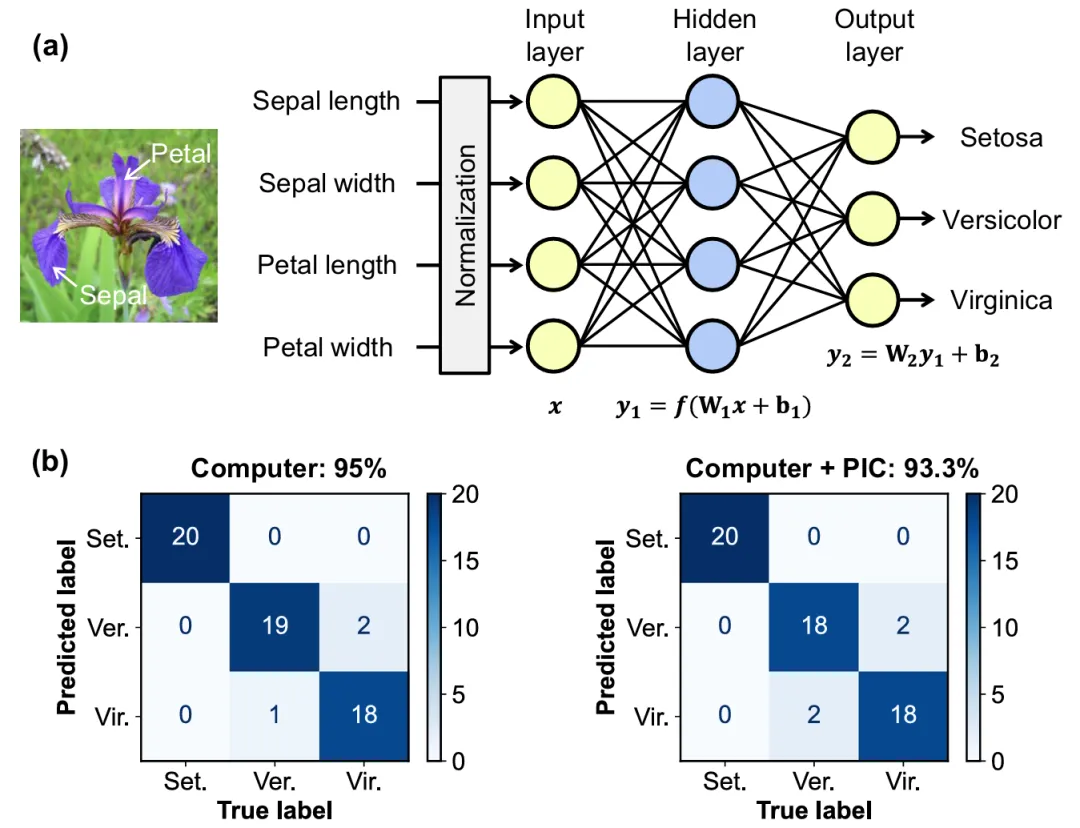
图5:神经网络实现显示(a)用于鸢尾花分类的三层架构和(b)纯计算机处理(95%准确率)与混合光子-电子处理(93.3%准确率)的比较结果。
准确率的轻微降低可归因于各种硬件缺陷,包括调制器中的有限消光比、光电流的时间波动以及波导交叉的串扰。尽管存在这些限制,结果表明光子矩阵处理器可以达到适合实际机器学习任务的性能水平。
可扩展性分析和未来潜力
也许最重要的是,研究包括了大规模实现的综合仿真。团队建模了能够处理Fashion-MNIST卷积神经网络计算要求的线路性能,这是一个更具挑战性的图像分类数据集。这些仿真假设了现实的硬件参数,包括30 dB消光比、1.5%光电流波动和8位控制分辨率。
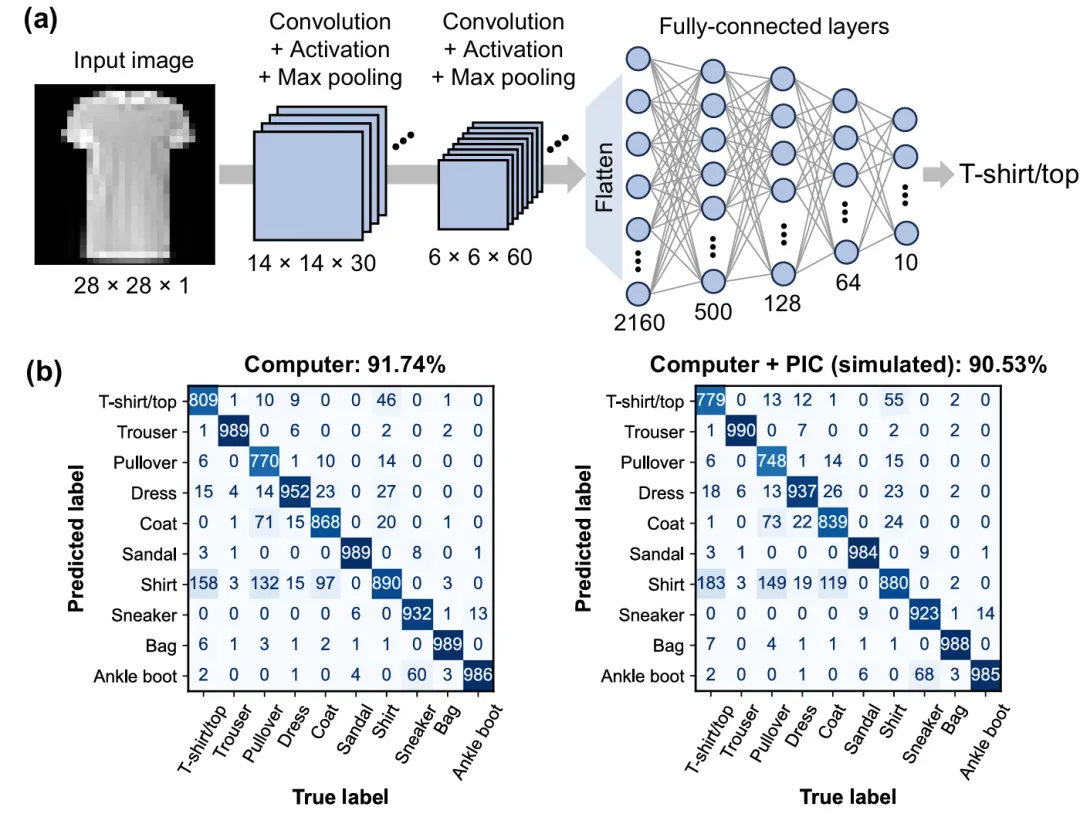
图6:大规模应用演示,包括(a)用于Fashion-MNIST分类的卷积神经网络架构和(b)性能比较,显示使用仿真大规模光子线路时准确率降低最小(从91.74%降至90.53%)。
结果非常鼓舞人心,显示分类准确率保持在90.53%的高水平,相比之下纯计算机处理为91.74%。这种最小的降级表明,波导复用方法即使在扩展到处理现实深度学习工作负载时也能保持优秀的性能。
可扩展性分析表明,当使用相变材料调制器时,这种方法理论上可以支持高达210×210的矩阵尺寸,主要受信噪比考虑而非基本架构约束的限制。与以往的光子计算方法相比,这代表了实质性改进,为实际大规模光神经网络实现开辟了通道。
波导复用方法代表了光子计算的重要进步,为节能、高速神经网络加速提供了路径,可以补充或最终在特定机器学习应用中替代传统电子处理器。
参考文献
[1] R. Tang, M. Okano, C. Zhang, K. Toprasertpong, S. Takagi, and M. Takenaka, "Waveguide-multiplexed photonic matrix–vector multiplication processor using multiport photodetectors," Optica, vol. 12, no. 6, pp. 812-820, Jun. 2025.
END
 微信公众号
 bilibili
 微信视频号