


光电子集成芯片的基础概念与设计挑战
光计算技术正在改变传统计算架构的基础逻辑。光电子集成芯片代表了这一转变的核心技术,通过使用光波而非电信号来执行计算操作。这些器件能够在大约150飞秒内完成运算,比传统电子计算机的单个时钟周期快约2500倍。
设计这些复杂的光学器件面临着重大技术挑战。传统方法主要依赖基于梯度的优化技术,虽然数学上较为成熟,但存在一个关键缺陷:经常陷入局部最小值,无法发现真正的最优设计。当需要处理光电子器件所需的复杂、反直觉几何结构时,这个局限性变得特别突出[1]。
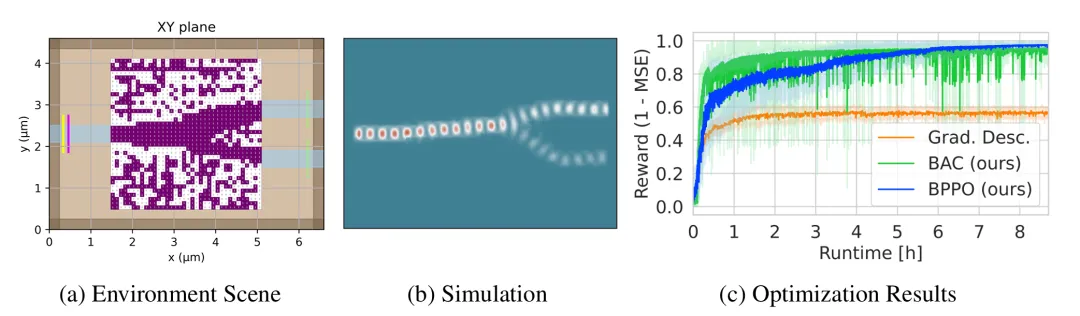
图1:光电子集成芯片上线性运算的设计任务,包括(a)环境场景显示波导布局,(b)电磁仿真结果,(c)优化结果对比,其中梯度下降陷入局部最小值,而本文提出的BPPO和BAC算法表现出更好的探索行为。
Multi-Agent强化学习的核心创新
本研究的突破性方法将光电子设计转换为离散优化问题,通过将每个设计元素视为Multi-Agent强化学习系统中的独立代理来实现。这种范式转换代表了与传统连续优化方法的根本性区别,为解决复杂设计挑战提供了全新视角。
核心创新在于将设计空间离散化为网格,其中每个体素可以包含材料(通常是硅或聚合物)或空气。这种二元决策过程分布在数千个独立代理中,每个代理负责三维设计空间中的单个体素。通过将庞大的优化问题分解为众多较小的、可管理的决策,系统能够比传统基于梯度的方法更有效地探索设计空间。
研究引入了两种专门针对这一挑战环境的新算法:Bandit Actor-Critic(BAC)和Bandit Proximal Policy Optimization(BPPO)。这些算法专门设计用于处理光电子设计优化的独特特征,其中电磁仿真计算成本高昂,限制了优化过程中可以执行的设计评估次数。
三个核心设计挑战的深入分析
该框架解决了构建完整光计算系统所需的三个基础组件,每个组件都呈现出独特的设计挑战,展示了多智能体方法的多样性。
第一个挑战涉及设计耦合元件,有效地将光从光纤传输到片上波导中。这种耦合过程对于光计算系统中的数据输入和输出极为重要。目标是最大化从自由空间成功传输到波导导模中的光的比例,这项任务需要精确的几何优化来匹配不同介质之间的光学模式。
第二个设计挑战专注于创建高效的波导弯曲,能够在没有显著损耗的情况下使光绕过尖锐拐角。虽然直波导表现出最小的传输损耗,但实际的光学线路需要复杂的路由模式,不可避免地包含急转弯。传统的弯曲设计遭受大量损耗,使弯曲几何形状的优化成为可扩展光计算系统的关键组件。
第三个也是最复杂的挑战涉及设计能够执行标量-向量乘法的计算元件,这是光计算中线性代数运算的基本构建块。这些组件必须根据预定权重在多个输出波导之间分配输入光,有效实现神经网络计算和其他线性代数任务所需的乘法运算。
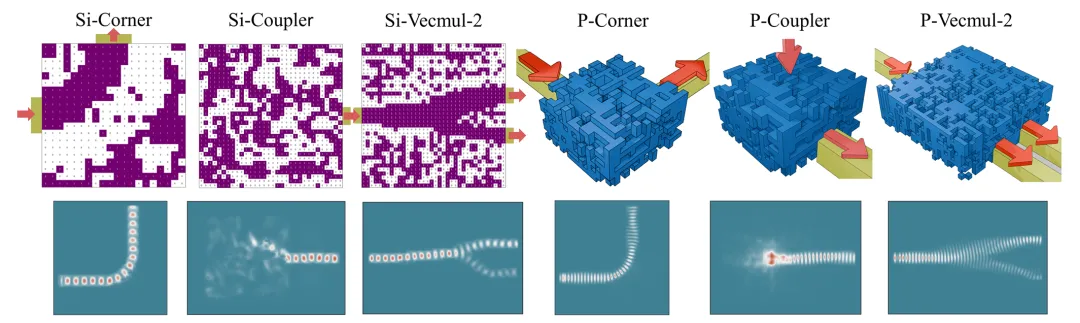
图2:三种不同环境的优化设计,使用2D硅(紫色显示)和3D聚合物设计(蓝色显示)。输入和输出波导用绿色标记并带有方向箭头,底部行显示了电磁仿真结果,演示了光在这些优化结构中的传播。
样本高效学习的技术优势
这种方法最显著的特点之一是其卓越的样本效率。传统强化学习应用通常需要数百万个训练样本才能达到合格性能,使得在每次评估都计算昂贵的问题上应用变得不切实际。光电子设计问题正是呈现了这一挑战,因为每次设计评估都需要完整的电磁仿真,可能需要大量的计算时间。
Multi-Agent方法通过仅用几千个环境样本就能实现有效优化,巧妙地解决了这一限制。样本效率的显著提升源于问题空间的智能分解以及通过神经网络架构在所有代理之间共享学习参数。每个代理都从数千个其他代理的集体学习经验中受益,加速了整体优化过程。
算法通过几种创新机制实现这种效率。Bandit Actor-Critic算法采用集中式评论员,预测联合动作的预期性能,允许代理从整个集体的经验中学习。同时,Bandit Proximal Policy Optimization算法将成功的PPO框架适应于光电子设计问题的独特约束,在有效探索广阔设计空间的同时保持稳定的学习动态。
实验验证与性能比较分析
研究在多个设计场景中提供了全面的实验验证,将提出的算法与传统优化方法进行比较,包括梯度下降、进化算法和其他强化学习方法。结果始终表明Multi-Agent强化学习方法在2D硅设计和3D聚合物结构中的优越性。
在使用减法工艺制造的硅基设计中,这些工艺将结构限制为平面几何形状,Multi-Agent算法在拐角设计中实现了超过90%的传输效率,并在耦合和计算元件中表现出卓越性能。基于梯度的优化虽然能够为某些2D问题找到合理解决方案,但始终达不到强化学习方法发现的最优设计。
在允许复杂几何形状(包括悬垂和内部结构)的3D聚合物设计中,优势变得更加明显。传统基于梯度的方法在这些3D问题上遇到重大困难,原因在于连续优化变量与物理可实现结构之间的映射。Multi-Agent方法通过直接在离散设计空间中操作,自然地处理这些约束,避免了与连续到离散映射相关的复杂性。
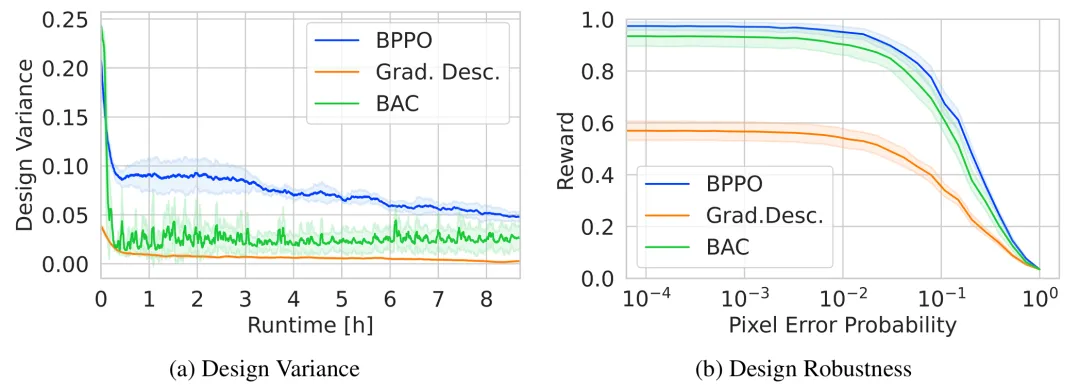
图3:比较了BPPO、BAC和梯度下降方法的学习行为,显示(a)优化期间的设计方差和(b)设计对制造误差的鲁棒性。方差分析显示梯度下降快速收敛到有限探索,而强化学习方法在整个优化过程中保持更好的探索。
对未来光计算系统的技术影响
这种多智能体强化学习方法的成功为未来光计算系统设计带来了新的技术可能性。通过实现高性能光电子组件的自动发现,这种方法论可以加速实用光计算硬件的开发,满足现代应用日益增长的计算需求,特别是在人工智能和机器学习领域。
优化设计的鲁棒性代表了另一个显著优势。与产生确定性设计且容易受制造缺陷影响的基于梯度的优化不同,强化学习算法的随机性质本身就优化了即使在制造变异影响下仍能保持功能的设计。这种鲁棒性对于光计算系统的实际部署来说非常重要,因为制造公差可能显著影响性能。
此外,仿真环境和优化算法的开源实现有望促进该领域更广泛的研究和发展。通过为研究人员提供探索光电子设计优化的便利工具,这项工作为光计算技术的持续创新建立了基础。
能够使用仅几千次评估优化具有数千个二进制变量的设计的能力表明,这种方法可以扩展到更大更复杂的光电子系统。随着制造技术的不断进步,实现更精细的特征尺寸和更复杂的3D结构,多智能体强化学习框架为能够跟上这些技术能力的自动设计优化提供了有效方法。
这种方法的成功也为其他具有昂贵评估函数的工程优化问题提供了借鉴。通过将庞大的优化挑战转换为数千个协作决策过程,每个过程都从集体经验中学习同时为整体设计目标做出贡献,该方法论展示了强化学习如何适应样本极其有限但动作空间庞大的场景。这种组合在材料科学、机械工程等领域的许多工程优化问题中都会出现。
研究结果表明,相比传统方法需要数百万次评估,仅需几千次评估就能获得成功,这为将这些技术应用于其他计算昂贵的设计挑战提供了新的技术路径。光电子线路设计中展示的原理和方法可以推广到需要在复杂约束条件下进行多维优化的其他工程领域。
参考文献
[1] Y. Mahlau, M. Schier, C. Reinders, F. Schubert, M. Bügling, and B. Rosenhahn, "Multi-Agent Reinforcement Learning for Inverse Design in Photonic Integrated Circuits," arXiv preprint arXiv:2506.18627, Jun. 2025.
END
 微信公众号
 bilibili
 微信视频号