


引言
人工智能系统的快速发展对计算能力和数据传输能力提出了极高的要求。随着AI模型变得越来越复杂,需要数万甚至数十万个GPU进行训练和推理,处理单元之间的互连基础设施已成为关键瓶颈。本文探讨了光子互连技术如何解决这些挑战,以支持下一代AI系统的发展[1]。
AI革命及其网络需求
在计算历史的关键时刻,AI与加速计算的交叉正在从根本上重塑技术格局。成功的AI系统需要大型数据集、先进算法和高效计算资源。然而,现代AI系统的规模带来了独特挑战——模型参数在十年内增长了70,000倍,最先进的生成式AI模型需要在数据、流水线、张量和专家等多个维度上实现并行化。
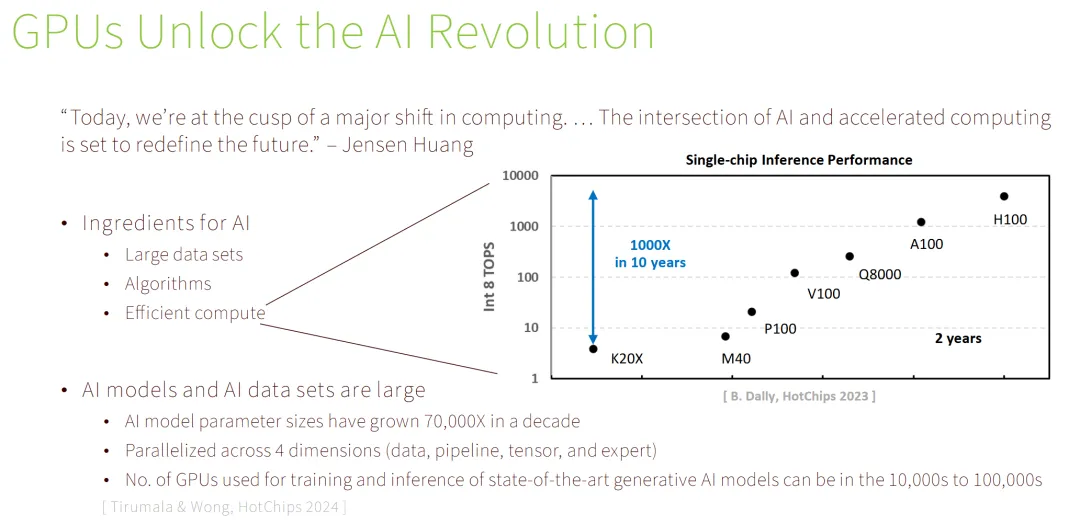
图1:十年内单芯片推理性能提升1000倍的图表,从K20X到H100 GPU的演进说明了计算能力的指数级增长。
NVIDIA设想的现代AI工厂代表着大规模计算基础设施。一个拥有32,000个GPU的完整数据中心可提供645 exaFLOPS的AI性能,配备13 PB的快速内存和58 PB/s的NVLink聚合带宽。这些系统还集成了16.4 petaFLOPs的网内计算能力,强调了互连技术的关键作用。
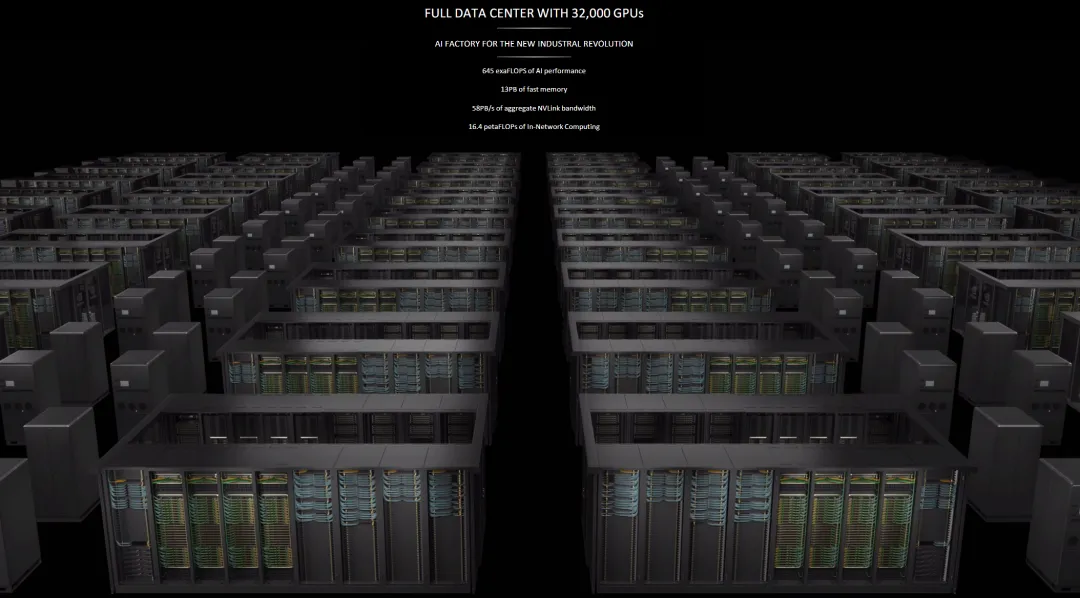
图2:32,000个GPU的完整数据中心可视化,呈现现代AI基础设施的规模和复杂性。
带宽扩展挑战
AI系统面临的根本挑战是实现成本效益和能源效率的带宽扩展。这一挑战体现在多个领域:横向扩展和纵向扩展网络、交换机和GPU输入/输出接口、交换机和线缆,以及电气和光学技术。这些领域都需要创新解决方案来跟上AI不断增长的需求。
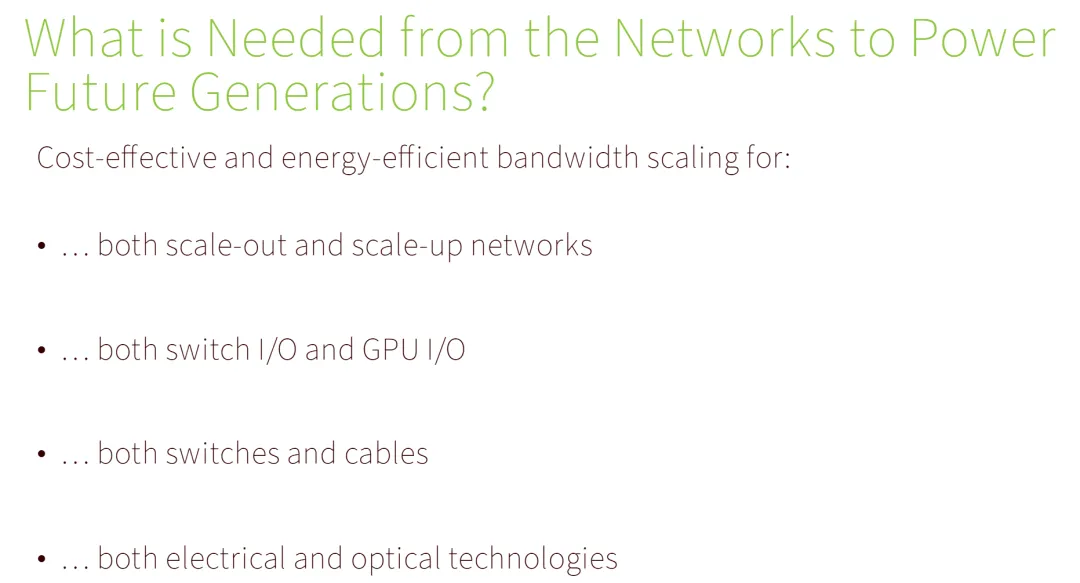
图3:不同网络组件和技术的带宽扩展需求。
对过去二十年商用交换机ASIC的分析显示,带宽每两年持续翻倍。然而,这种增长伴随着巨大挑战。虽然由于CMOS缩放,单位比特能耗有所下降,但这种降低并不足以防止整体功耗增加。随着CMOS缩放放缓,这一问题预计会恶化。特别令人担忧的是,I/O功率与核心功耗相比不成比例地扩展,凸显了对适用于交换机和GPU的低功耗I/O解决方案的迫切需求。
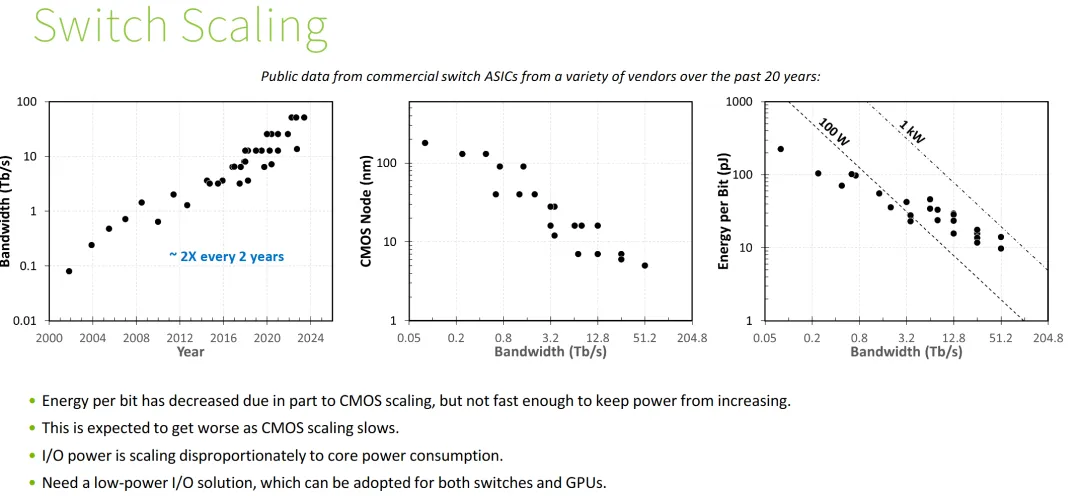
图4:交换机带宽演变(每两年翻倍)、CMOS节点缩放和单位比特能耗随时间的变化趋势。
GPU I/O带宽遵循类似轨迹,虽然落后于交换机带宽约10倍,但在密度和能效方面实现了可比性能。以NVIDIA Blackwell GPU为代表的中介层GPU内存带宽的引入,展示了解决这些扩展挑战的一种方法。
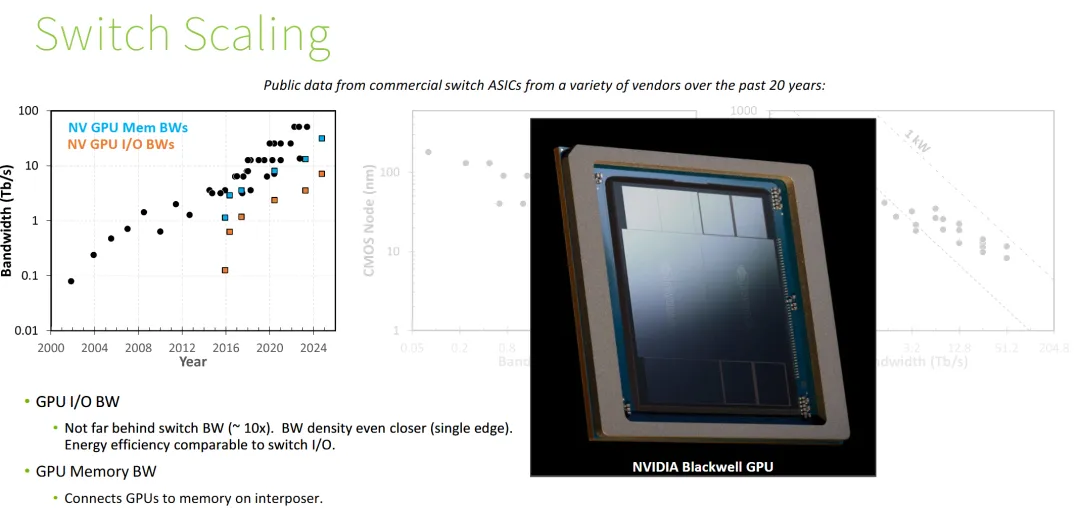
图5:GPU I/O带宽、GPU内存带宽和交换机扩展趋势的比较,展示了NVIDIA Blackwell GPU架构。
当前光学解决方案:可插拔光学器件
传统上,光学互连以可插拔模块的形式实现,位于卡边缘或板上。这些解决方案在印刷电路板(PCB)上使用长距离接口,由于引脚密度限制,每条走线需要100-200 Gb/s。已发布的性能指标显示,在超过0.5米的距离上,112 Gb/s传输的能耗为4.5-6.5 pJ/b,最新进展在40 dB插入损耗信道上实现了224 Gb/s的3 pJ/b(仅模拟)。
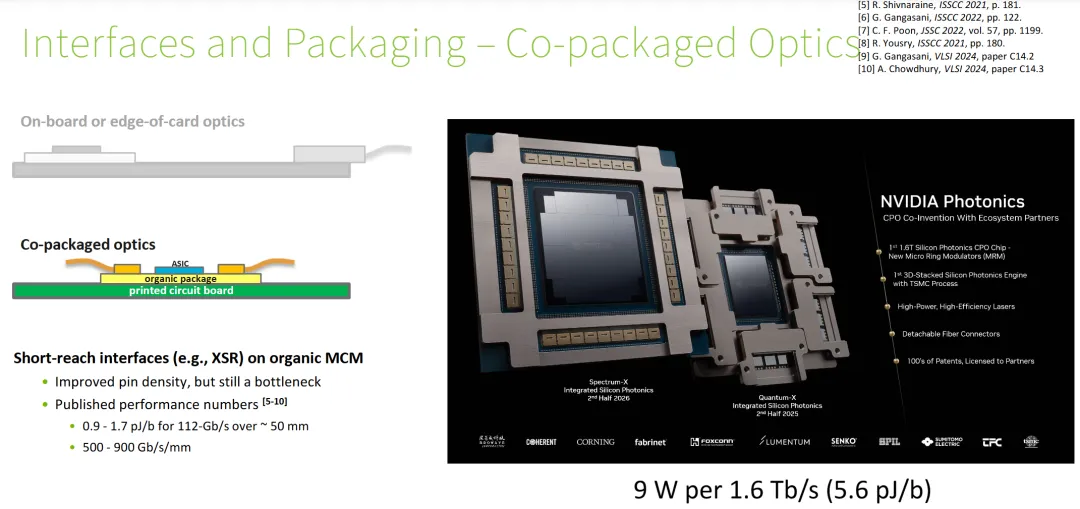
图6:可插拔光学架构图示,显示ASIC、有机封装和光学模块之间的关系,以及1.6T OSFP模块示例。
目前最先进的实现包括支持双DR4配置的1.6T OSFP模块,配备MPO连接器,以200 Gb/s信号速率运行。这些模块在面板上排列成两行时,实现约0.1 Tb/s/mm的密度,功耗约30W(19 pJ/b)。虽然这项技术代表了成熟且灵活的解决方案,具有既定标准和多供应商支持,但在能效和带宽密度方面面临扩展挑战。
光电共封装的前景
光电共封装(CPO)代表了光学互连设计的重要演进,将光学组件直接放置在与ASIC相同的有机多芯片模块(MCM)上。这种方法使用短距离接口,改善了引脚密度,同时仍面临一些瓶颈。已发布的性能数据显示,在约50mm走线上,112 Gb/s传输的能耗为0.9-1.7 pJ/b,带宽密度范围为500-900 Gb/s/mm。
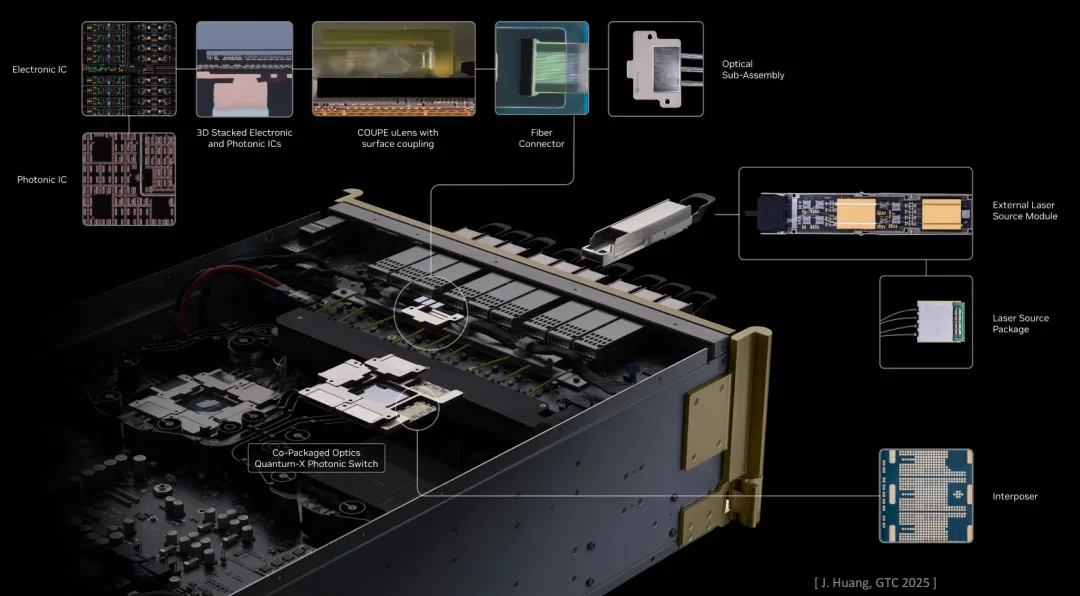
图7:可插拔和共封装光学器件的架构比较,显示光学组件与ASIC在MCM上的集成。
NVIDIA光子CPO系统展示了这种方法,与生态系统合作伙伴集成硅基光电子芯片,实现每1.6 Tb/s 9W(5.6 pJ/b)的性能。这种实现展示了将光学器件靠近ASIC如何显著降低整体功耗,同时保持高带宽能力。
先进集成:2.5D光学器件
光学集成的最先进方法涉及2.5D封装,其中光学组件与ASIC一起集成在硅中介层上。这种架构实现了慢而宽的接口,通过更高密度和更低数据速率实现优越的效率。已发布的结果显示,在1-2mm距离上,25-50 Gb/s传输实现0.2-0.4 pJ/b,带宽密度从2到超过10 Tb/s/mm不等。
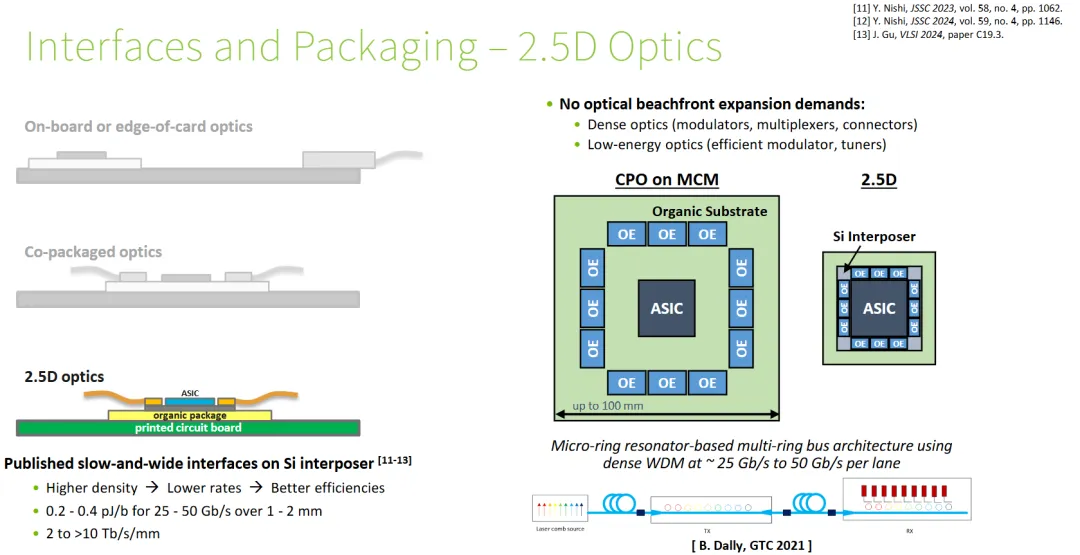
图8:MCM上CPO与2.5D集成的架构比较,以及基于微环谐振器的多环总线架构图。
这种方法利用基于微环谐振器的多环总线架构,在每通道25-50 Gb/s速率下进行密集波分复用(WDM)。关键优势是通过密集集成调制器、复用器和连接器避免光学边缘扩展需求,结合低能耗光学组件,包括高效调制器和调谐器。
功率和性能分析
为了理解这些不同方法的影响,考虑一个假设的200 Tb/s交换机实现。使用带长距离接口的电缆,仅接口就需要约1000W,总I/O功率达到4800W。相比之下,光电共封装将接口功率降至250W,总I/O功率降至1350W。理想的2.5D光学方法可以进一步将这些数字分别降至50W和700W。
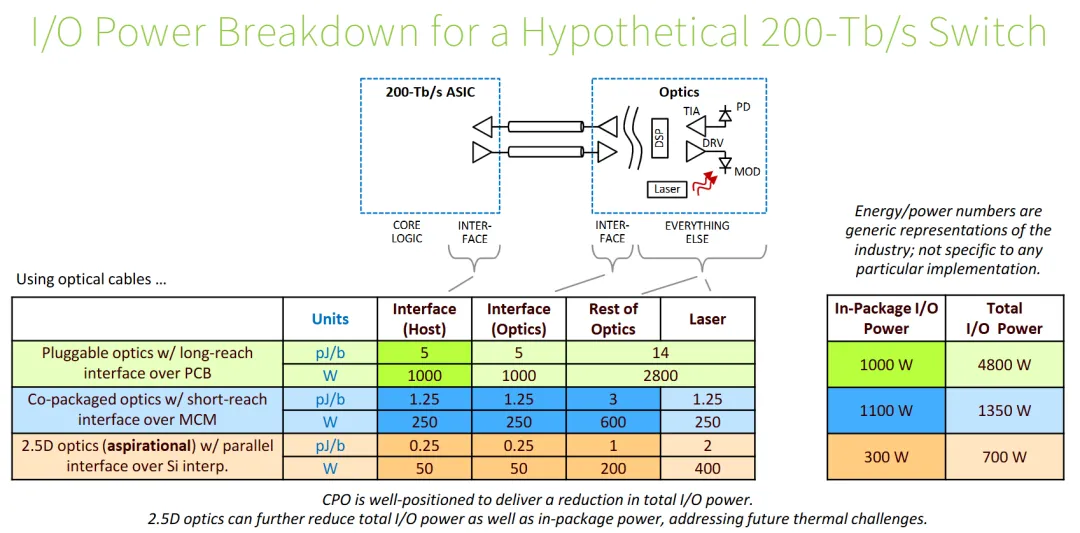
图9:200 Tb/s交换机中不同光学集成方法的详细功率分解比较,包括接口、光学和激光功率组件。
这些能效改进对未来AI系统具有深远影响。光电共封装能够提供总I/O功率的显著降低,而2.5D光学还可以解决封装内功耗问题,有助于管理日益密集的计算系统中的未来热挑战。
光路交换的机遇
除了点对点光链路外,光路交换(OCS)为数据中心和AI网络的进一步功耗降低提供了机会。在典型的两级胖树横向扩展网络中,实施OCS可以将端到端能耗从可插拔光学器件的83 pJ/b降至50 pJ/b,或从光电共封装的48 pJ/b降至31 pJ/b。
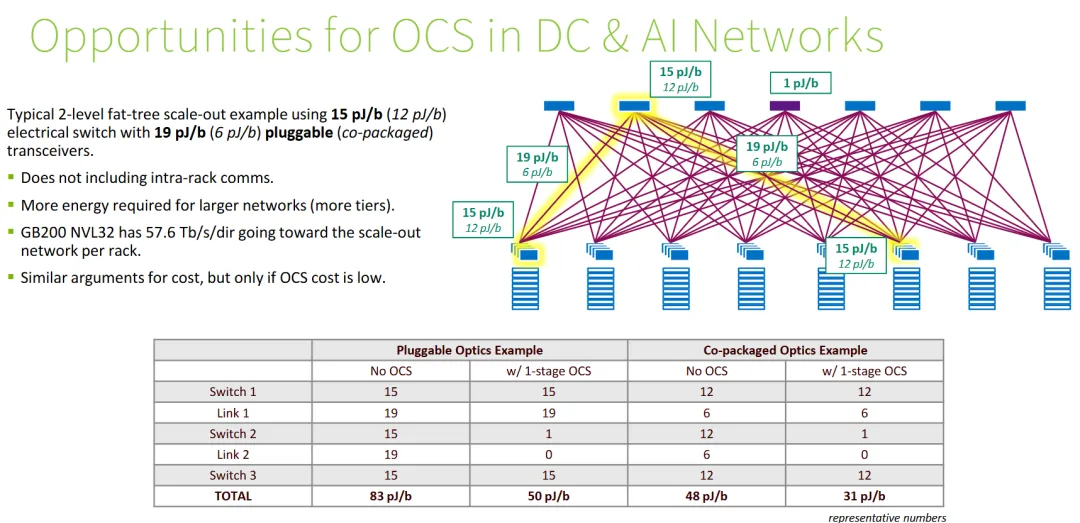
图10:胖树网络拓扑中光路交换的可视化,显示不同光学集成方法的能源节省。
在具有更多层级的更大网络中,能源节省变得特别显著,像GB200 NVL32这样的系统(每机架需要57.6 Tb/s双向带宽用于横向扩展网络)可以从OCS实现中显著受益。
未来方向:硅基光电子交换机
展望未来,基于硅基光电子集成线路的交换机代表了光学互连技术的另一个前沿。最近的演示展示了完全在光域中实现的日益复杂的交换结构,可能提供更高的能效和带宽扩展能力。

图11:来自不同研究组的硅基光电子集成线路交换机示例,显示光学交换技术的演进。
结论
AI系统的发展需要互连技术的创新方法。从传统可插拔光学器件向光电共封装,最终向2.5D集成光学器件的转变,为满足下一代AI基础设施的带宽和能效要求提供了清晰路径。网络对AI系统的未来发展具有重要性,在交换机和GPU层面扩展I/O带宽都代表着关键挑战。
通过将光学器件逐步靠近ASIC,可以实现总I/O功耗的大幅降低。光电共封装提供即时优势,而2.5D集成有望解决总功率和模块级热挑战,尽管对光学组件本身有更严格的限制。这些技术与光路交换的结合,将在AI系统的持续扩展中发挥作用。
从电气到光学互连的转变不仅仅是技术转型——是对人工智能时代数据传输方式的重新思考。在这个技术十字路口,互连架构的选择将影响未来AI发展的轨迹。
参考文献
[1] B. Lee, "Photonic Interconnect for Next-Generation AI Systems," presented at OCP EMEA Summit 2025, Dublin, Ireland, Apr. 29-30, 2025.
END
 微信公众号
 bilibili
 微信视频号