


引言
近年来,GPU人工智能运算的发展速度已经远超传统摩尔定律的扩展速度。在传统芯片遇到多重扩展挑战的同时,GPU人工智能计算性能展现出显著增长,在过去十年中提升了约1000倍。这种显著的进步源于技术、芯片设计、系统架构和算法等多个领域的系统性优化。
让我们首先观察图1和图2,这两张图展示了扩展趋势的显著对比。
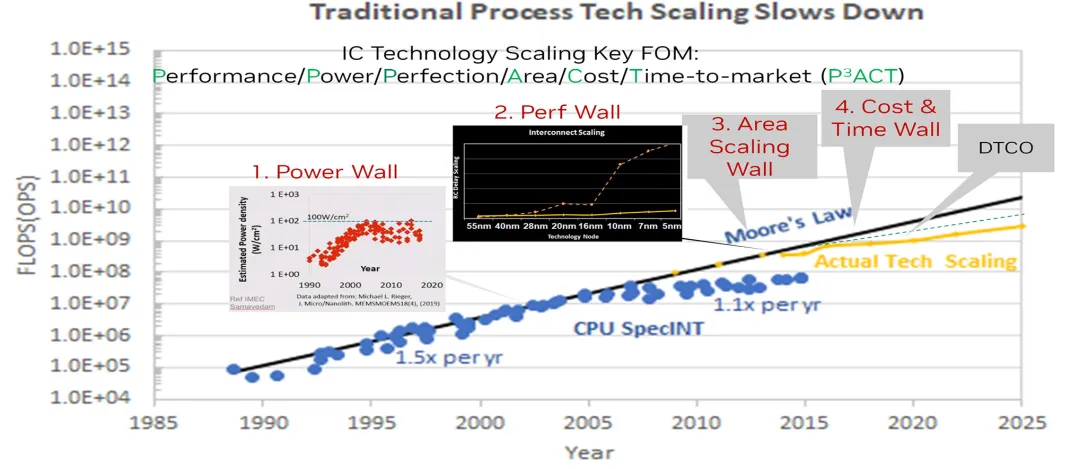
图1:传统CPU扩展速度放缓
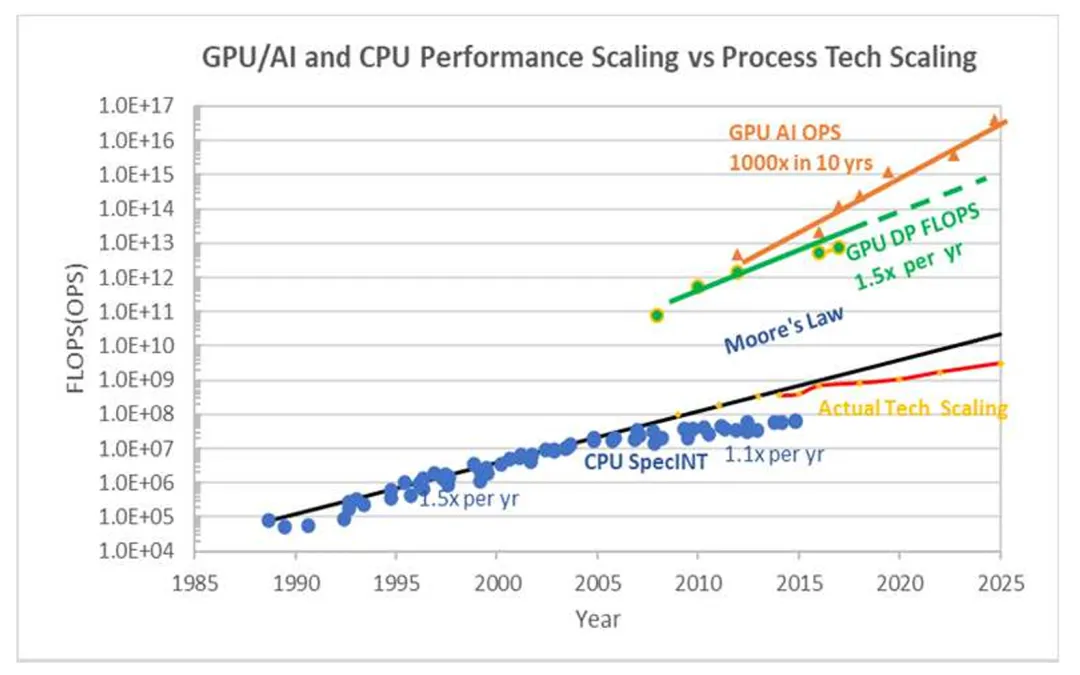
图2:CPU与GPU人工智能性能快速增长的对比,突出显示了GPU技术通过全面优化策略超越了摩尔定律的扩展速度。
GPU架构与性能的演进
B200是目前世界上最大和性能最强的GPU高性能计算和人工智能芯片,代表了GPU技术的最新进展。这款技术产品由两个并排放置在硅中介层上的GPU芯片组成,通过金属互连实现连接。每个GPU die采用台积电定制的4NP技术制造,面积达790.5平方毫米,包含2080亿个晶体管。
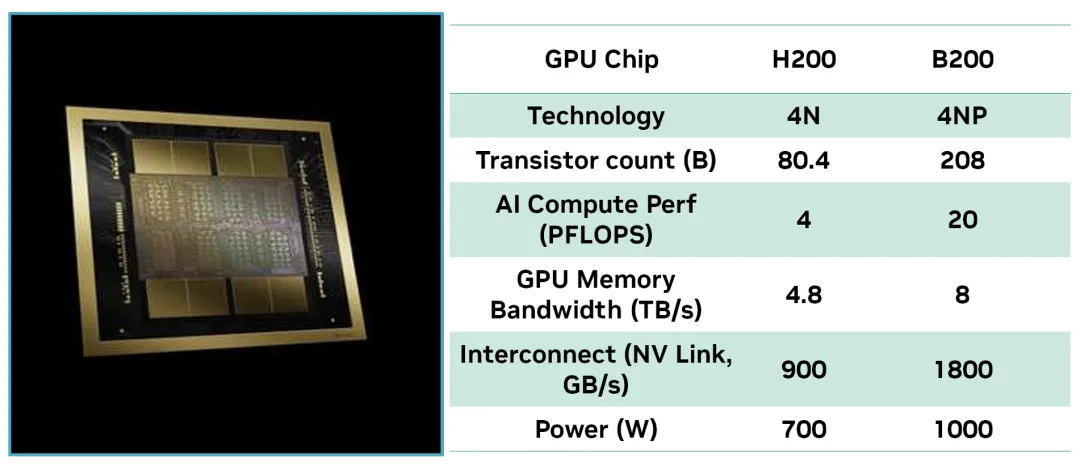
图3展示了B200 GPU高性能计算/人工智能芯片,并与其前代产品H200进行了详细对比,显示了多个性能指标的显著提升。
B200的架构包含多项创新特性,包括能够处理低至FP4精度格式的第二代转换器核心。与192GB HBM3E内存的集成实现了8TB/s的带宽,在1000W功耗下提供20PFlop FP4稀疏张量性能。
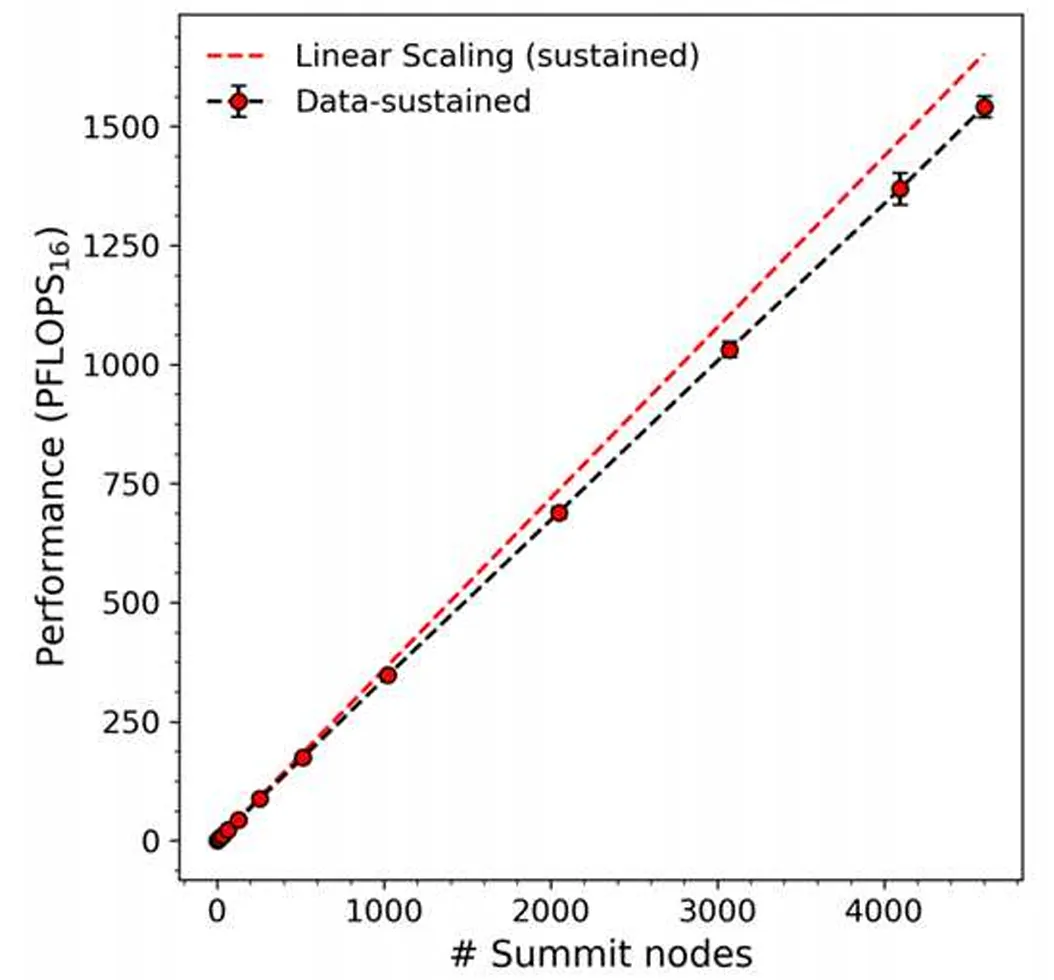
图4展示了GPU集群的线性扩展能力
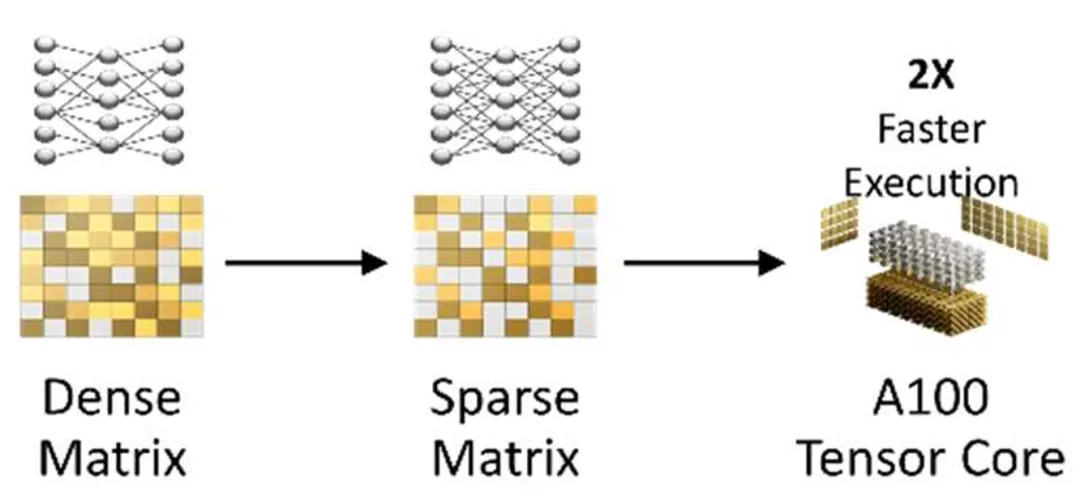
图5说明了稀疏矩阵计算如何实现2倍速度提升,展示了现代GPU架构的效率。
能源效率与计算优化
能源效率是现代GPU设计中的核心考虑因素。各种优化技术的实施带来了功耗和计算效率的显著提升。
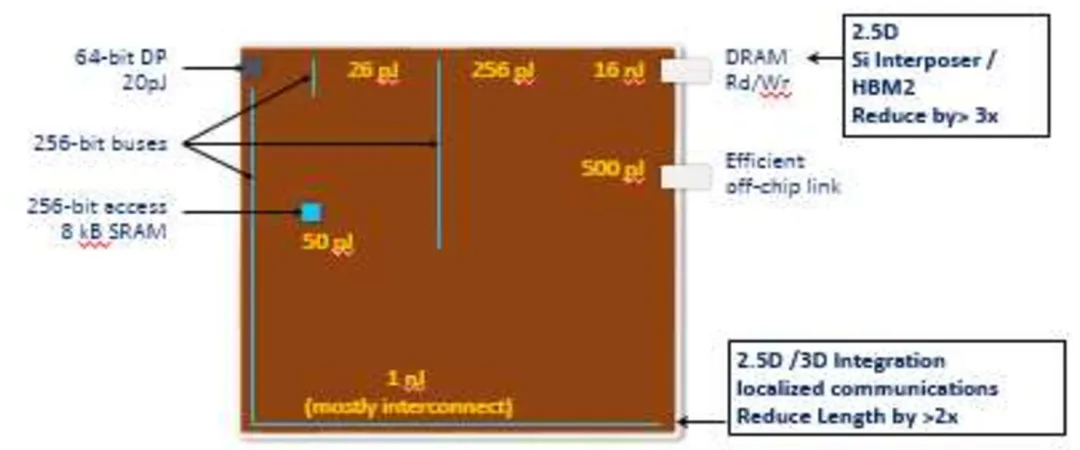
图6详细说明了各种计算功能的能源消耗
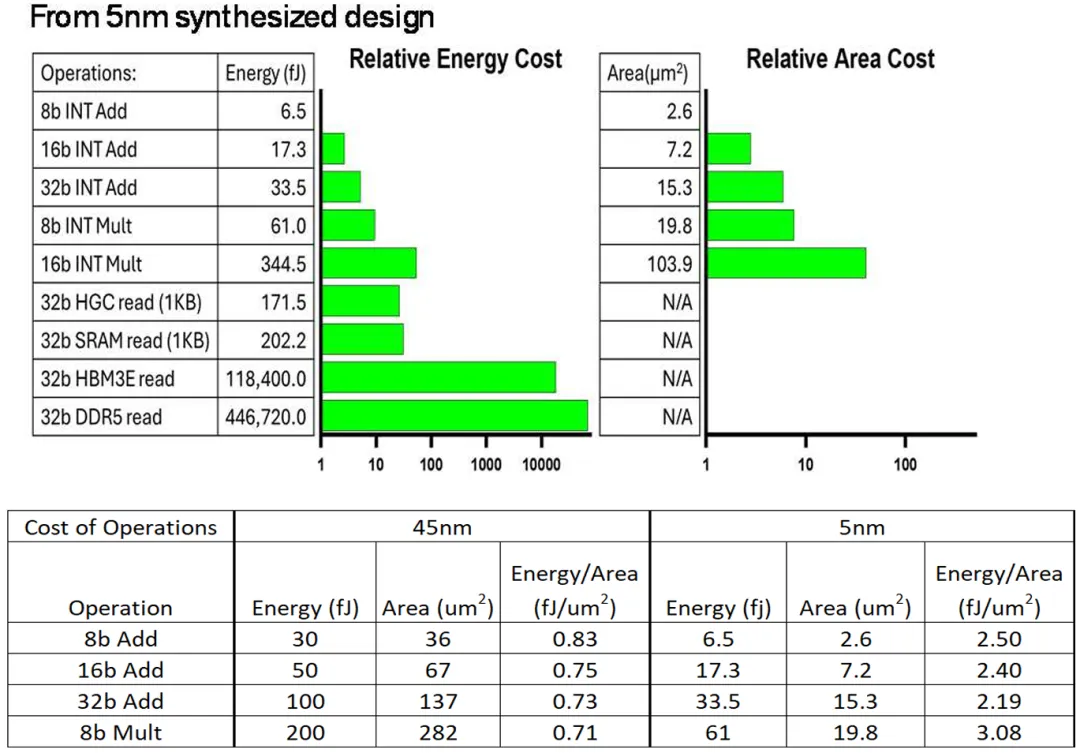
图7全面对比了从45nm到5nm技术节点的运算成本,包括功耗和芯片面积。
张量核心的引入彻底改变了计算效率,与普通运算相比提供了1.5-4倍的功率效率。在使用混合精度计算时,这种提升更为显著。
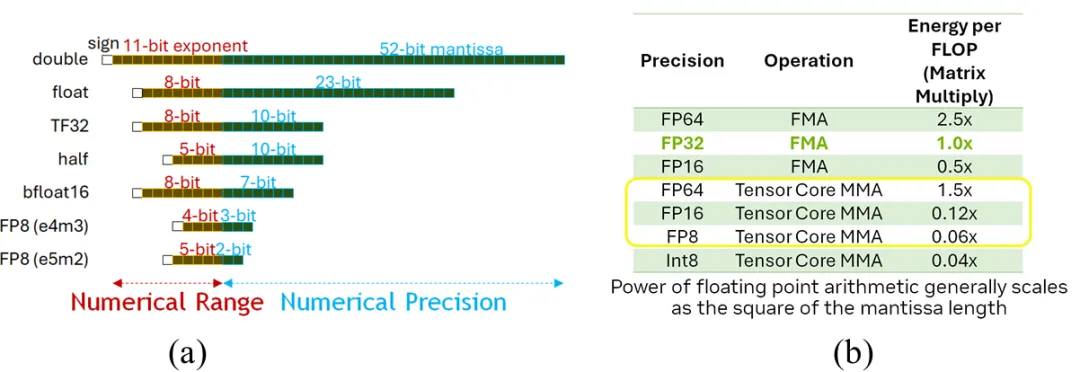
图8显示了张量核心如何实现优于普通运算的功率效率
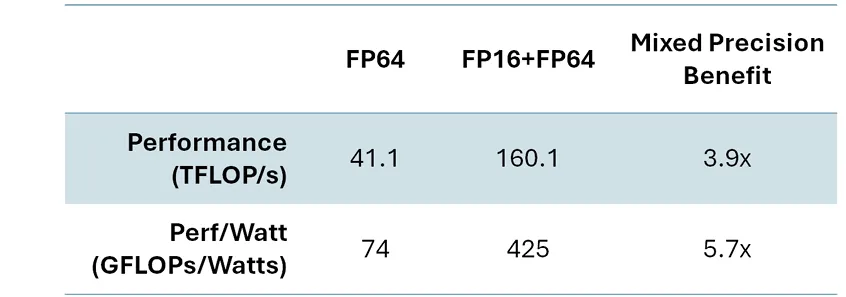
图9展示了使用FP16张量核心配合迭代优化方法时在性能和每瓦性能方面的显著提升。
内存与系统集成的进展
随着人工智能加速发展,内存容量在人工智能计算中变得越来越重要,GPU内存容量也随之大幅增长。这种增长对支持大型语言模型和其他复杂人工智能应用非常重要。
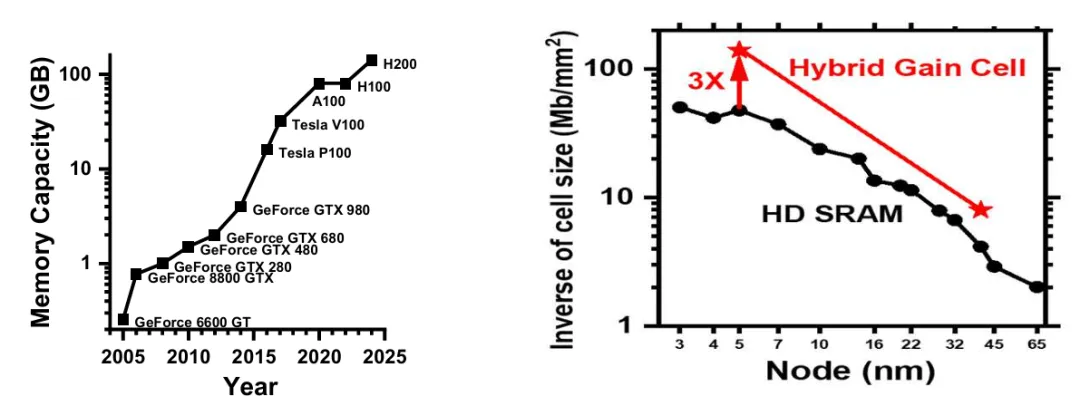
图10描绘了GPU内存容量随时间呈指数增长的趋势。
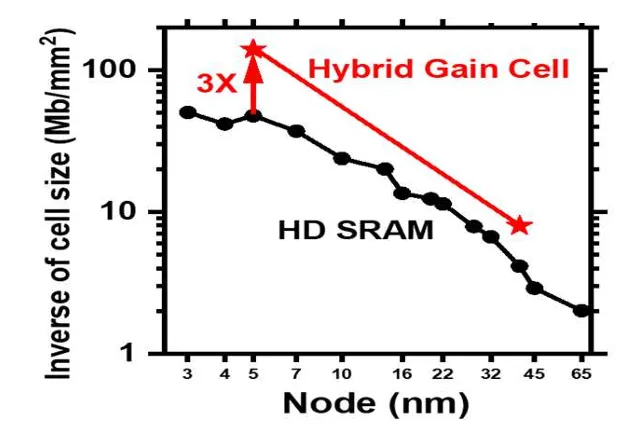
图11展示了混合增益单元技术如何在保持相近速度的同时实现比HD SRAM高3倍的密度。
新兴技术与发展方向
业界持续探索提升GPU性能和效率的创新解决方案。先进封装技术和新型互连解决方案正在成为未来性能扩展的关键推动力。
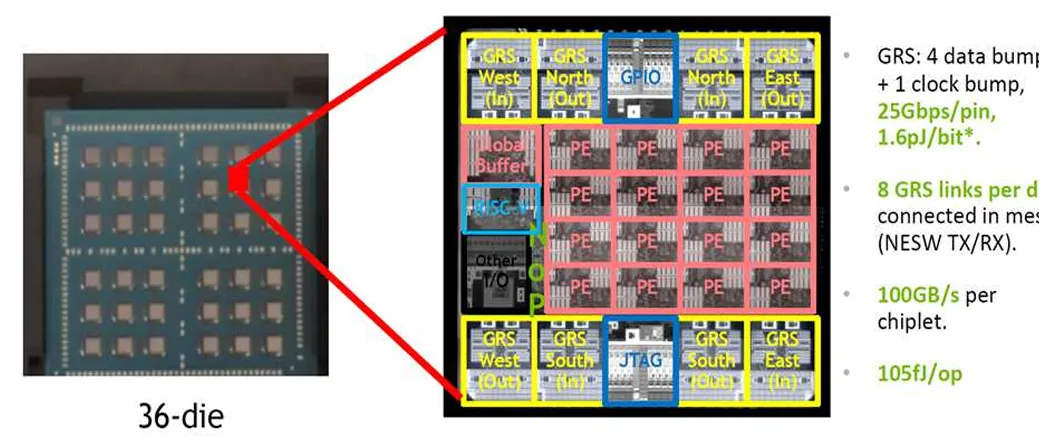
图12展示了具有36芯片MCM设计的RC18加速器。
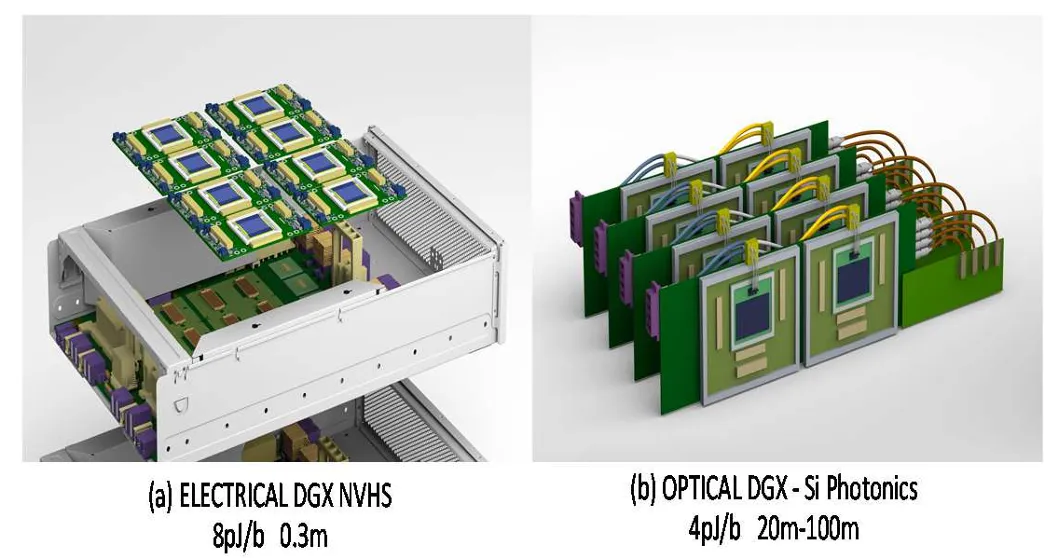
图13展示了用于远程信号传输的光电共封装。
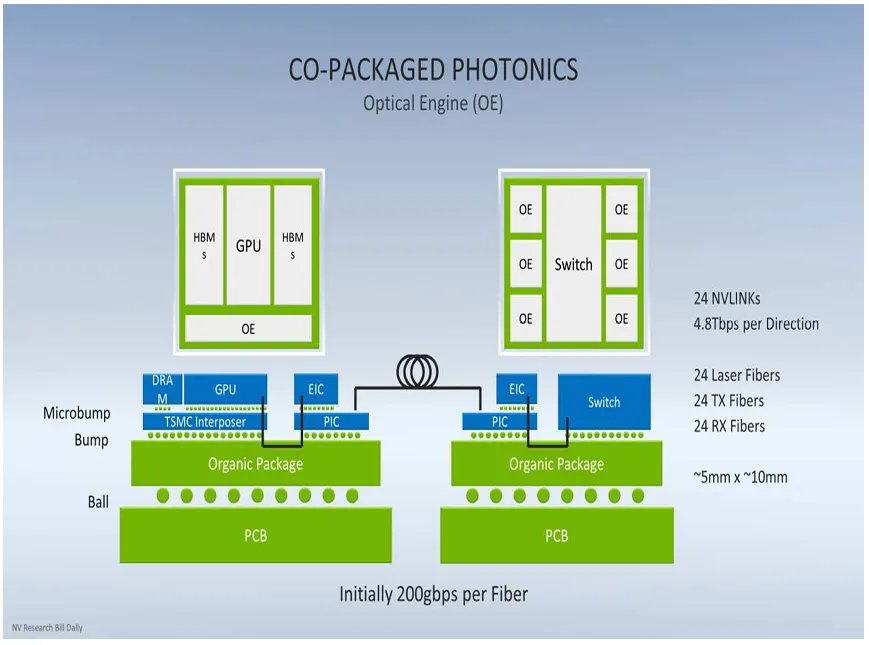
图14说明了下一代互连的光电子引擎架构。
通过这种从基础技术开发到系统级集成和算法改进的全面优化方法,GPU人工智能计算继续保持快速发展。这些创新的结合实现了黄氏定律,在保持功率效率和可靠性的同时,每年实现性能翻倍。
随着内存、互连和封装解决方案等新技术的不断发展,GPU人工智能计算将继续提升性能水平。跨多个领域的全面优化原则将持续推动这种显著的增长。
参考文献
[1] J. R. Hu et al., "Co-Optimization of GPU AI Chip From Technology, Design, System and Algorithms," in 2024 IEEE International Electron Devices Meeting (IEDM), San Francisco, CA, USA, 2024.
END
 微信公众号
 bilibili
 微信视频号