


引言
在当今快速发展的人工智能领域,计算能力需求持续呈指数级增长。传统的加速器之间的电气互连由于体积庞大和功耗高而面临显著限制。一个有效的解决方案出现在光子互连形式中,这种技术利用波长分割多路复用(WDM)满足多加速器服务器内的加速器间通信密度需求。
计算资源碎片化的挑战
多租户机器学习环境中的一个关键挑战是计算资源碎片化。当现有租户的资源分配使得无法为新租户分配剩余资源的直连拓扑时,就会发生这种现象。仅仅重新配置网络组件(如光学开关或收发器)通常无法解决这个基本问题。
集体通信原语(如ALLREDUCE)是机器学习训练和推理的关键路径。虽然光学可重构数据中心结构能够分配直连拓扑以实现无争用的集体通信,但它们仍然容易受到计算资源碎片化问题的影响。
LUMORPH:创新解决方案
研究人员开发了LUMORPH,一种光学可重构数据中心机架,有效解决了多租户ML集群中的资源碎片化问题。这种架构通过名为LIGHTPATH的光学切换芯片间光子结构连接多GPU服务器内的GPU。
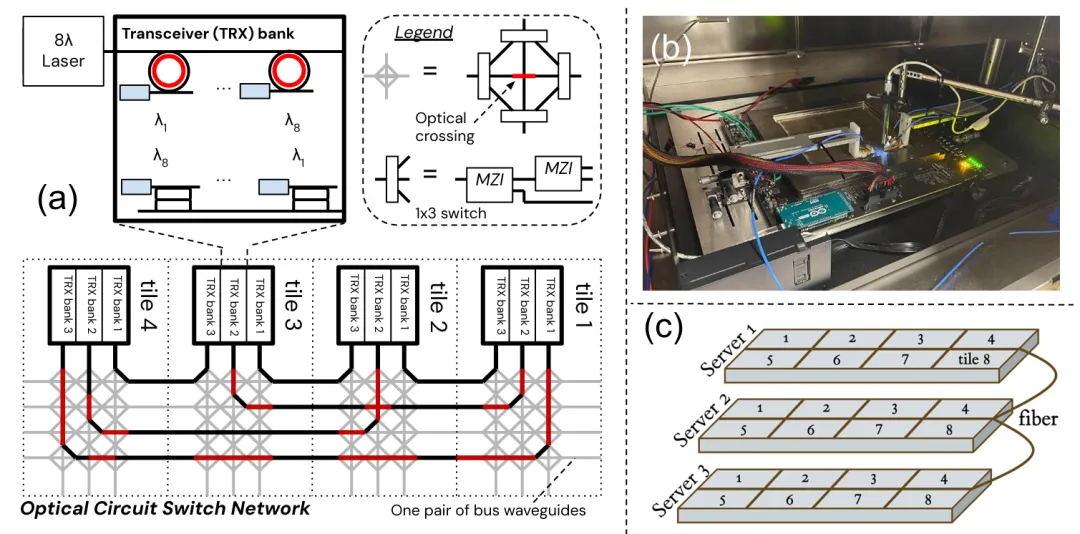
图1:服务器规模光子结构,展示了LIGHTPATH架构及其光学组件和tile之间的连接。
LIGHTPATH在混合互补金属氧化物半导体(CMOS)光子工艺中实现。一个LIGHTPATH晶圆最多可包含32个tile,这些tile作为3D堆叠计算芯片(如GPU和CPU)的占位符。每个tile配备多个发射器和接收器(TRX)组,发射器使用微环谐振器(MRR)调制光。
接收器组件对光的波长进行解复用,使用光电探测器将调制波长转换回电子数据,并将其发送到串行器/解串器(SerDes)模块。每个LIGHTPATH tile支持最多16个波长复用激光器,波导在tile之间传输波长。
LIGHTPATH的一个关键创新是基于马赫-曾德干涉仪(MZI)的1×3度光学开关,这些开关支持可编程的切换行为,在服务器上实现加速器之间的线路。这种可配置的架构实现了位于不同tile上的加速器之间的全连接。
性能与实现
研究团队在GlobalFoundries中制造了测试平台,展示了LIGHTPATH上光学器件的性能。他们进行了传输回环实验,PRBS-7信号从FPGA的28Gbps SerDes发送到光调制器。信号穿过四个LIGHTPATH tile,每个tile有四个独立的线路切换网络,然后被锗光电探测器检测。
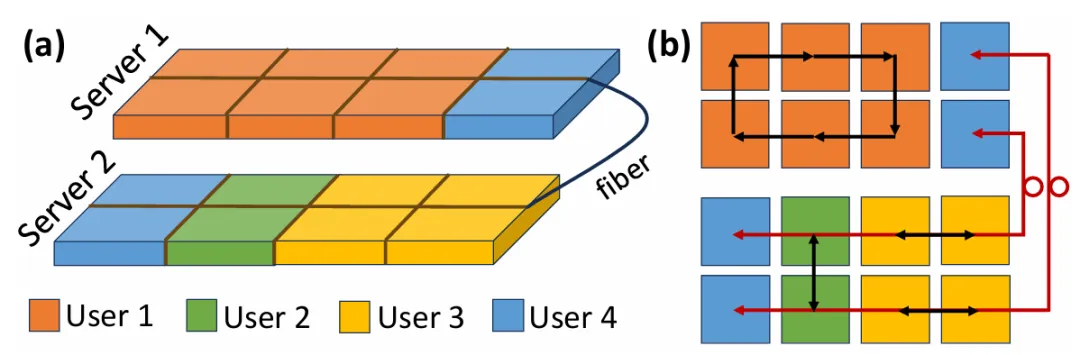
图2:多租户环境中的示例分配,显示计算资源碎片化以及每个租户分配中ALLREDUCE的线路设置。
在10 Gbps、15 Gbps和20 Gbps的数据速率下,他们观察到非常低的位错误率,分别为6.96×10^-13、6.62×10^-13和5.60×10^-14。这个实验证明了LIGHTPATH系统的可靠性和性能能力。
LUMORPH的最显著优势之一是其防止多租户机架中计算资源碎片化的能力。由于波导的小间距,在LIGHTPATH的tile之间蚀刻数千个波导是可行的。该系统实现了服务器中任意一对芯片之间的无拥塞访问,并且可以使用现有光纤连接到其他服务器上的空闲芯片。
与现有的只能以固定和有限大小为租户提供计算切片分配的线路切换架构不同,LUMORPH高效利用数据中心机架为多个租户服务,同时不牺牲每个租户的最佳通信。
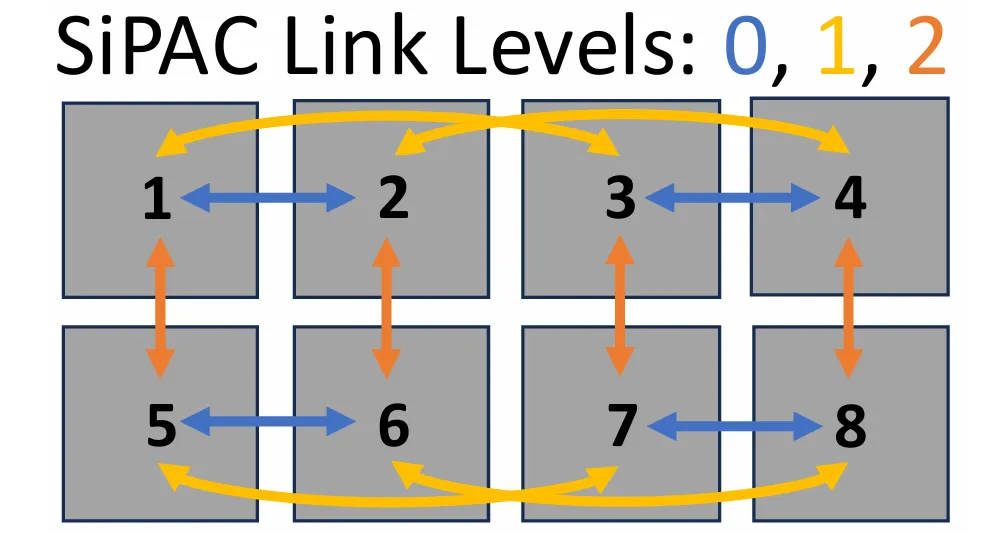
图3:使用LUMORPH的8个GPU的示例配置,等同于SiPAC(2,3),显示了链接级别0、1和2。
优化集体通信
LUMORPH为每个租户提供了配置最佳ALLREDUCE操作拓扑的灵活性。研究团队改进了已知能够实现α-β成本下限的已有算法,如递归倍增/减半。LIGHTPATH不是总是使用预先存在的链接,而是建立按需线路传输数据。
LUMORPH的一个重要创新是其能够通过在多个波长切换线路中分配GPU的总出口带宽,将递归倍增/减半推广为四倍/四分之一。这引入了一个重要的权衡:在多个连接之间分配带宽会降低延迟成本(α)但提高带宽成本(β)。
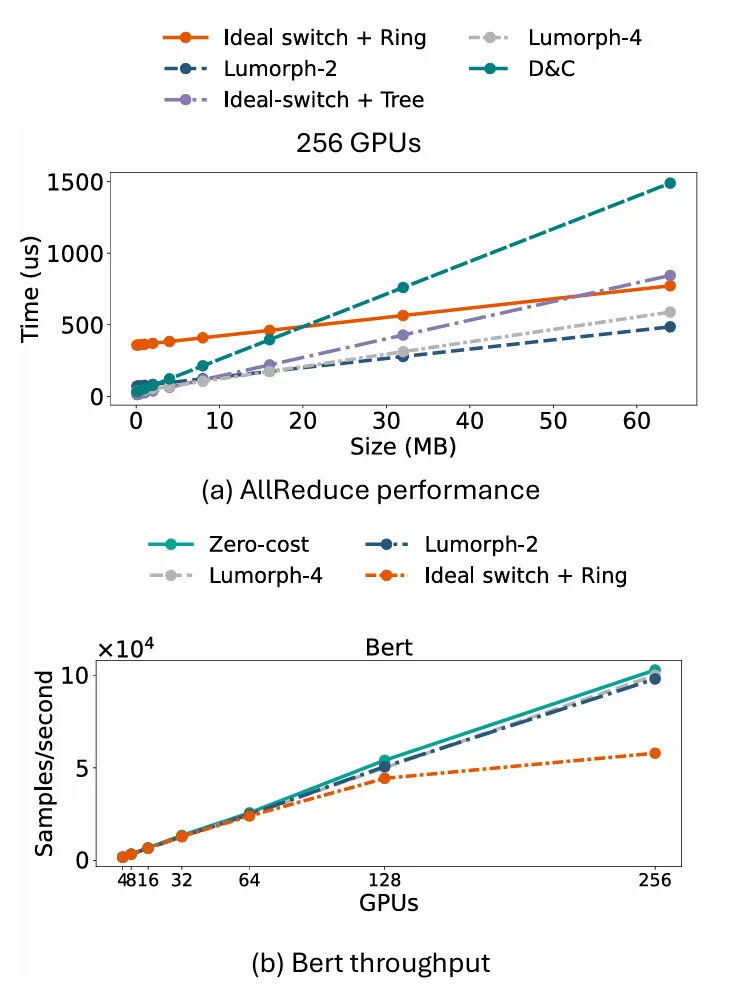
图4:LUMORPH的性能,显示了256个GPU上的AllReduce性能和BERT吞吐量测量结果。
令人印象深刻的性能提升
研究团队通过模拟评估了LUMORPH的性能,将其与具有理想开关(无排队延迟)的电气互连进行比较。尽管产生MZI重新配置延迟,LUMORPH的集体操作完成时间比具有理想开关的Ring和Tree算法快近80%。
在端到端评估中,他们使用FlexFlow模拟器为BERT语言模型生成最佳计算图。结果非常显著:LUMORPH的性能比通过理想开关连接的GPU上的Ring算法提高了高达1.7倍。
BERT显示出特别高的吞吐量改进,因为其并行化策略涉及许多小缓冲区ALLREDUCE调用。由于在高带宽(300 GB/s)下α成本主导小缓冲区ALLREDUCE运行时间,LUMORPH算法优于Ring算法,Ring算法在β方面是最优的,但在α方面是线性的。
结论
多加速器服务器的芯片间光子连接集成展示了机器学习训练的显著优势。LUMORPH使GPU能够以传统固定网络结构的集体算法无法匹配的方式与多个GPU进行更有效的通信。
这些结果强调了将人工智能通信升级为使用光子互连解决方案的好处,不仅仅是能源效率或带宽改进。凭借其实现无碎片化的多租户资源切片、74%更快的机架规模集体通信以及1.7倍的端到端ML训练吞吐量提升,LUMORPH代表了机器学习应用高性能计算领域的重大进步。
参考文献
[1] V. Kumar, A. Devraj, D. Bunandar, and R. Singh, "Chip-to-chip photonic connectivity in multi-accelerator servers for ML," in OFC 2025, 2025, pp. Th1F.2.
END
 微信公众号
 bilibili
 微信视频号