


引言
人工智能领域正在快速发展,片上AI能力正从传统的卷积神经网络(CNNs)转向基于transformer的生成式AI模型。本文探讨了三星4nm Exynos 2400系统芯片(SoC)中实现的尖端神经处理单元(NPU),该处理单元专为处理传统和生成式AI工作负载的严格要求而设计[1]。
生成式AI模型的挑战
生成式AI模型,如大型语言模型(LLMs,例如LLaMA)和大型视觉模型(LVMs,例如Stable Diffusion),与传统神经网络相比呈现出独特的计算挑战。LLMs需要在每个token生成过程中从DRAM读取数GB的权重数据,是内存密集型的。相比之下,LVMs更加计算密集,但具有明显的运算特性,其中softmax和层归一化操作占总计算时间的约40%。
这与CNNs有显著不同,在CNNs中,卷积操作通常构成了90-99%的计算工作量。这些新要求需要重新思考NPU架构,以高效支持生成式AI模型所需的各种操作。
异构NPU架构
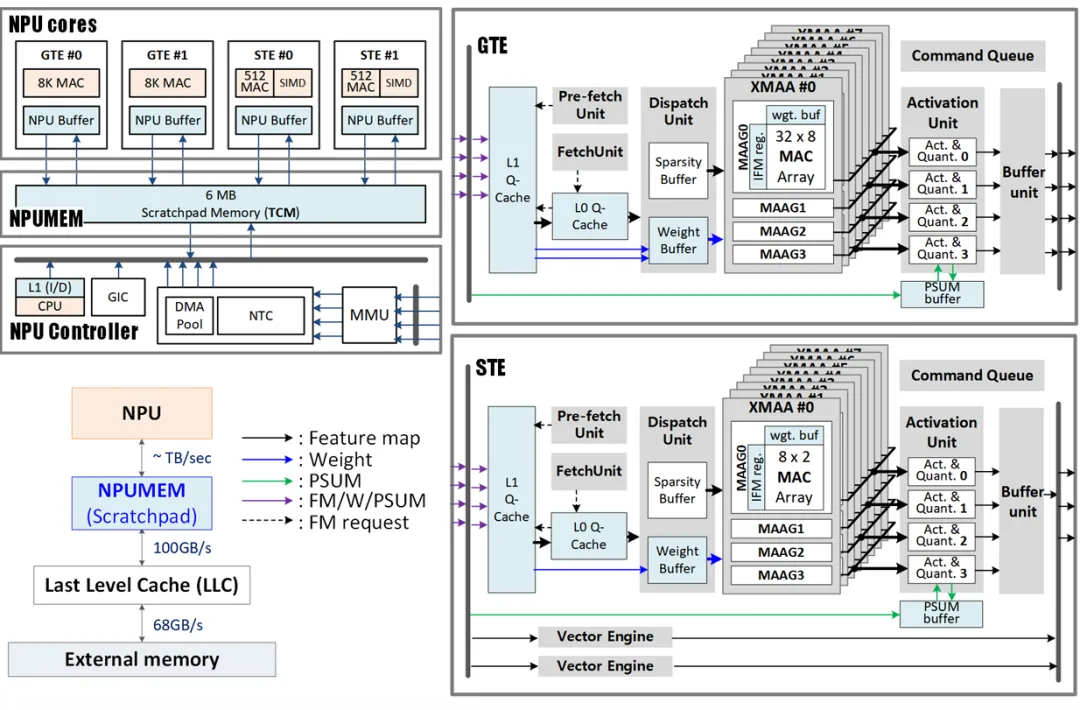
图1:神经处理单元的异构架构,展示了各种张量引擎、向量引擎和内存层次结构。
本文介绍的NPU架构采用异构方法来满足不同神经网络操作的各种计算需求。如图1所示,NPU集成了两种类型的张量引擎(TEs)和向量引擎(VEs),每种都针对特定类型的操作进行了优化。
通用张量引擎(GTEs)包含8K个MAC(乘-累加单元),针对计算密集型操作如卷积和矩阵-矩阵乘法进行了优化。浅层张量引擎(STEs),每个包含512个MAC,设计用于更高效地处理内存密集型操作,如矩阵-向量乘法和深度可分离卷积。
补充这些张量引擎的是四个向量引擎(VEs),这些引擎利用单指令多数据(SIMD)数据路径和32路执行单元。这些VEs专门设计用于处理非线性操作,如softmax、复杂激活函数和归一化操作,这些操作在基于transformer的模型中很常见。
所有这些处理引擎都连接到一个6MB的共享暂存内存,称为NPUMEM,用于存储输入和输出特征图、中间数据和权重值。这种共享内存架构促进了不同处理引擎之间的高效数据共享。
带队列缓存的优化内存层次结构
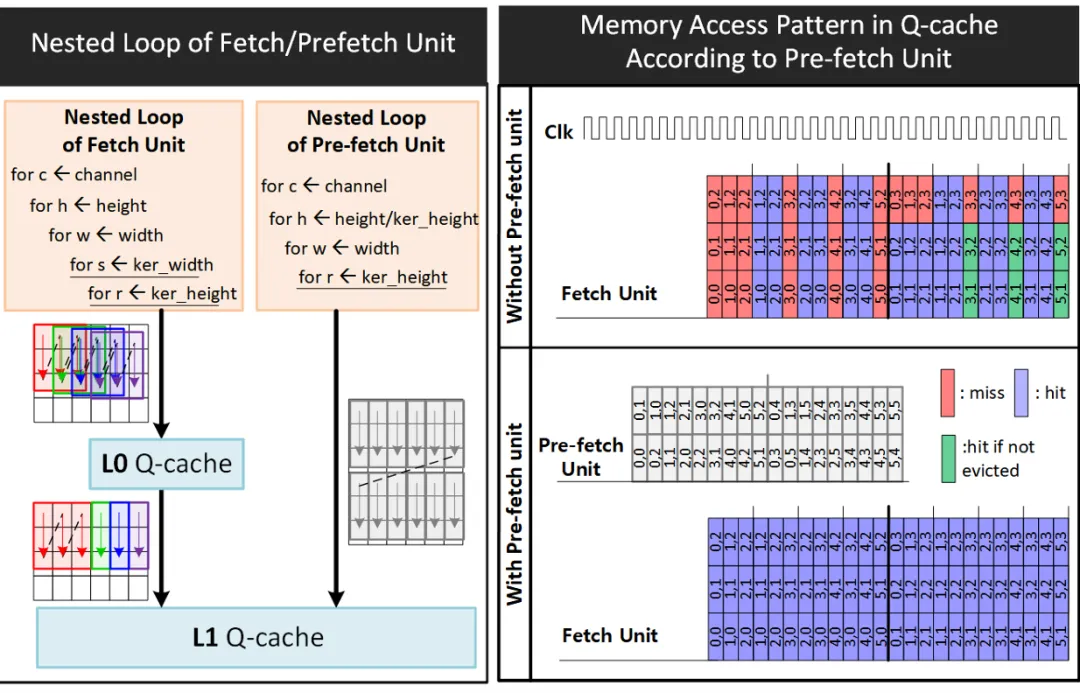
图2:L0/L1队列缓存操作,展示了如何管理数据序列以优化局部性并减少内存访问延迟。
这种NPU设计的一个关键创新是在每个张量引擎中实现L0/L1队列缓存(Q-cache)。与传统缓存不同,这些Q-cache专为减少未命中惩罚而设计,利用了张量引擎中操作的预定顺序。
如图2所示,Q-cache将数据序列作为队列管理,直观理解即将到来的数据请求的时间和空间局部性。这允许更精确的驱逐决策,在初始冷未命中后显著提高缓存命中率。此外,预取功能直接将数据加载到L1 Q-cache中,最小化初始冷未命中并进一步减少延迟。
这种方法能够有效隐藏延迟,而无需复杂的调度或任务管理技术,如单指令多线程(SIMT)。对于CNN操作,预取单元可以比提取单元提前几个周期操作,显著提高L1 Q-cache命中率并改善整体性能。
基于倾斜度的tile划分用于数据重用优化
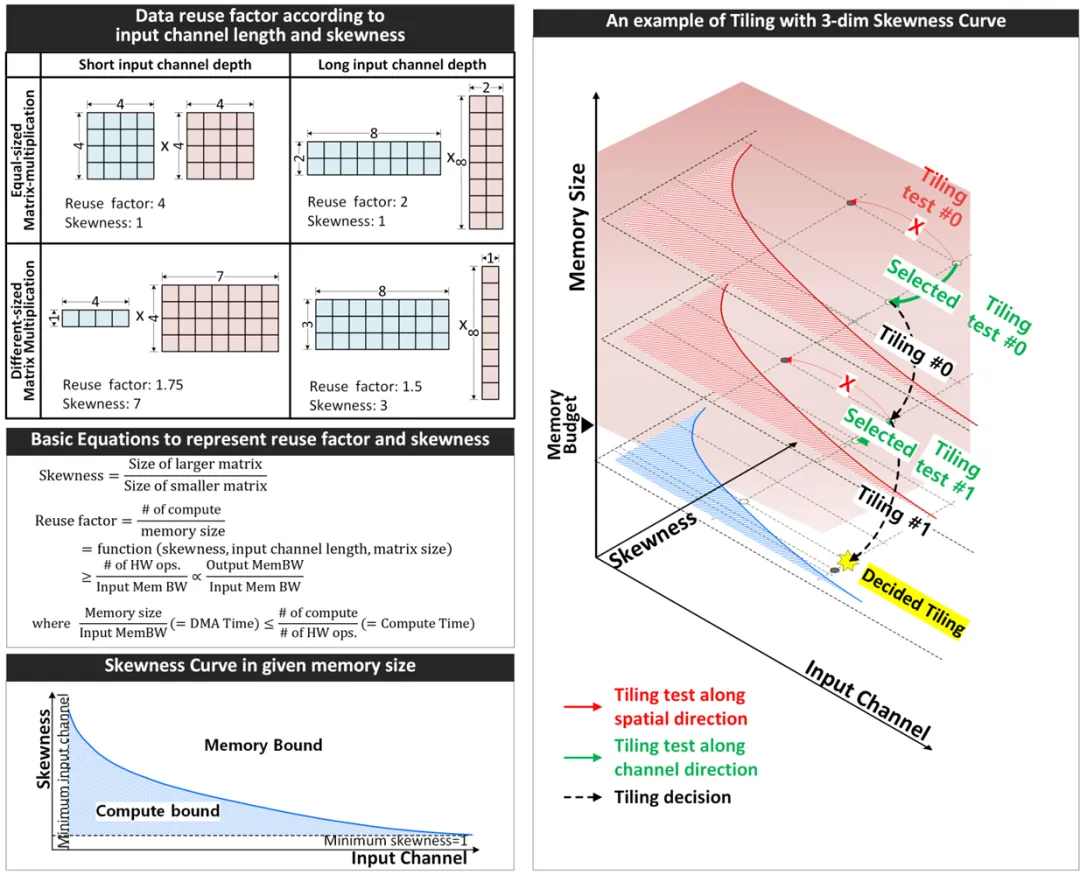
图3:使用倾斜度曲线的tile选择方法,展示矩阵大小、形状和输入通道长度如何影响数据重用效率。
本文介绍了一种创新方法,基于矩阵特性优化内存层次结构中的数据重用。如图3所示,三个关键因素影响数据可重用性:矩阵大小、特征图和权重矩阵的相对大小(定义为倾斜度),以及输入通道长度。
当较大的矩阵存储在内存中、当特征图和权重矩阵大小相似,以及当矩阵具有较小的输入通道长度时,NPU可实现更高的数据重用率。倾斜度定义为较大矩阵与较小矩阵之间的比率,而最小重用因子表示在内存层次结构中填补输入和输出端口之间带宽差距所需的最小数据重用量。
图3中的倾斜度曲线说明了给定内存大小下倾斜度与输入通道长度之间的关系。这条曲线有助于确定特定tile配置是计算密集型(蓝色区域)还是内存密集型。通过将这一概念扩展到三个维度以适应各种内存大小,NPU可以在可用内存预算内高效执行矩阵/张量tile划分,最大化数据重用。
tile划分过程使用基于倾斜度曲线的启发式方法。从大于内存预算的tile开始,系统以贪婪算法方式选择tile划分方向(宽度、高度或输入通道),参考倾斜度曲线。每次tile划分步骤后,倾斜度曲线会更新以匹配新的tile大小。这个过程持续进行,直到tile大小适合内存预算,确保整个计算过程中实现最佳数据重用。
使用异构引擎进行并行处理
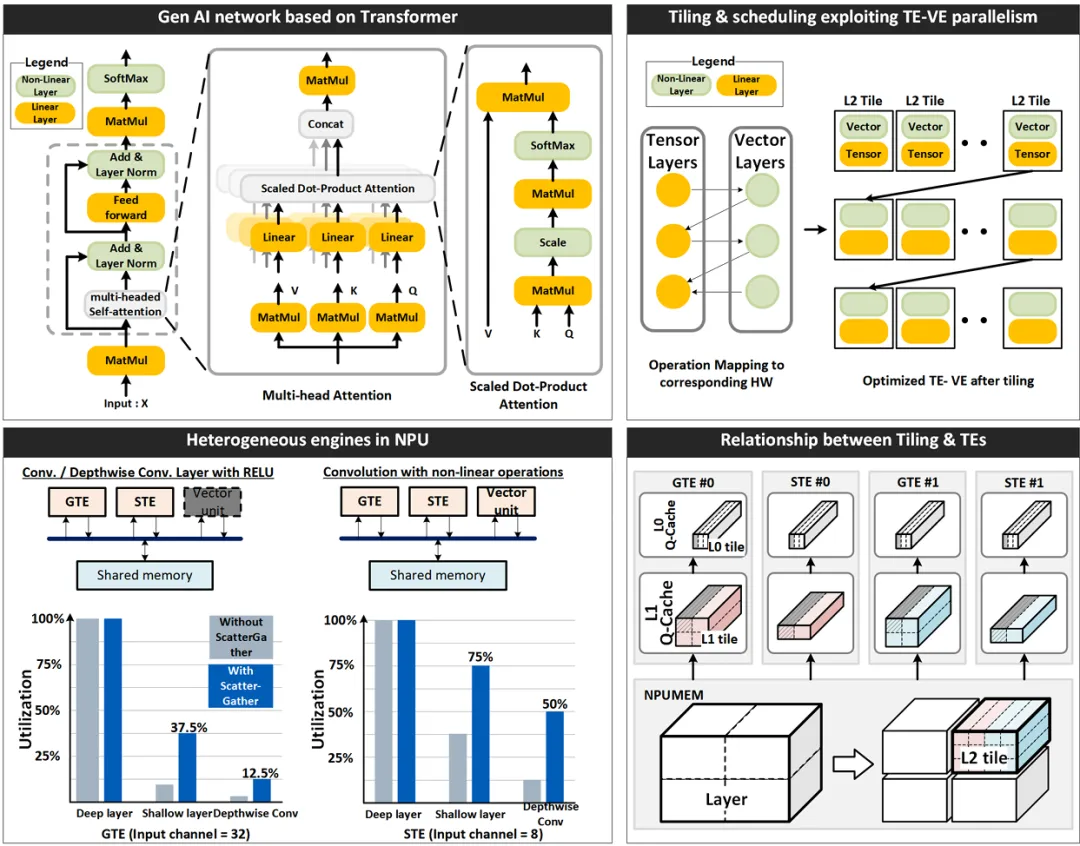
图4:使用异构引擎的神经网络操作,展示TEs和VEs如何通过tile级流水线协作并行处理不同操作。
在基于transformer的网络中,线性操作与非线性操作(如softmax)交替进行,后者占整体计算的很大一部分。为减少计算延迟,NPU使张量引擎(TEs)和向量引擎(VEs)能够并行执行。
如图4所示,整个神经网络被划分为大型L2 tile,其大小适合在NPUMEM中一次处理,考虑到TEs和VEs的并行处理能力。这些L2 tile进一步分为更小的L1 tile,考虑到张量引擎的L1 Q-cache。每个TE一次处理一个L1 tile,连续进行,直到完成L2 tile的所有计算。
NPU实现了tile级流水线,TEs和VEs与NPUMEM交换输入和输出tile。多个TE也可以并行执行,利用tile级并行性加速L2 tile的计算。这种协作方法确保高效处理线性和非线性操作。
虽然通用张量引擎(GTEs)针对具有高数据重用的卷积和矩阵-矩阵乘法进行了优化,但对于内存密集型操作如矩阵-向量乘法或深度可分离卷积,可能实现较低的硬件利用率。浅层张量引擎(STEs),虽然MAC数量较少但每个MAC的内存带宽较高,通过在这些操作中实现更高的硬件利用率来补偿这一限制。这种异构架构提供了功能灵活性,可高效处理各种类型的神经网络层。
热管理和封装创新
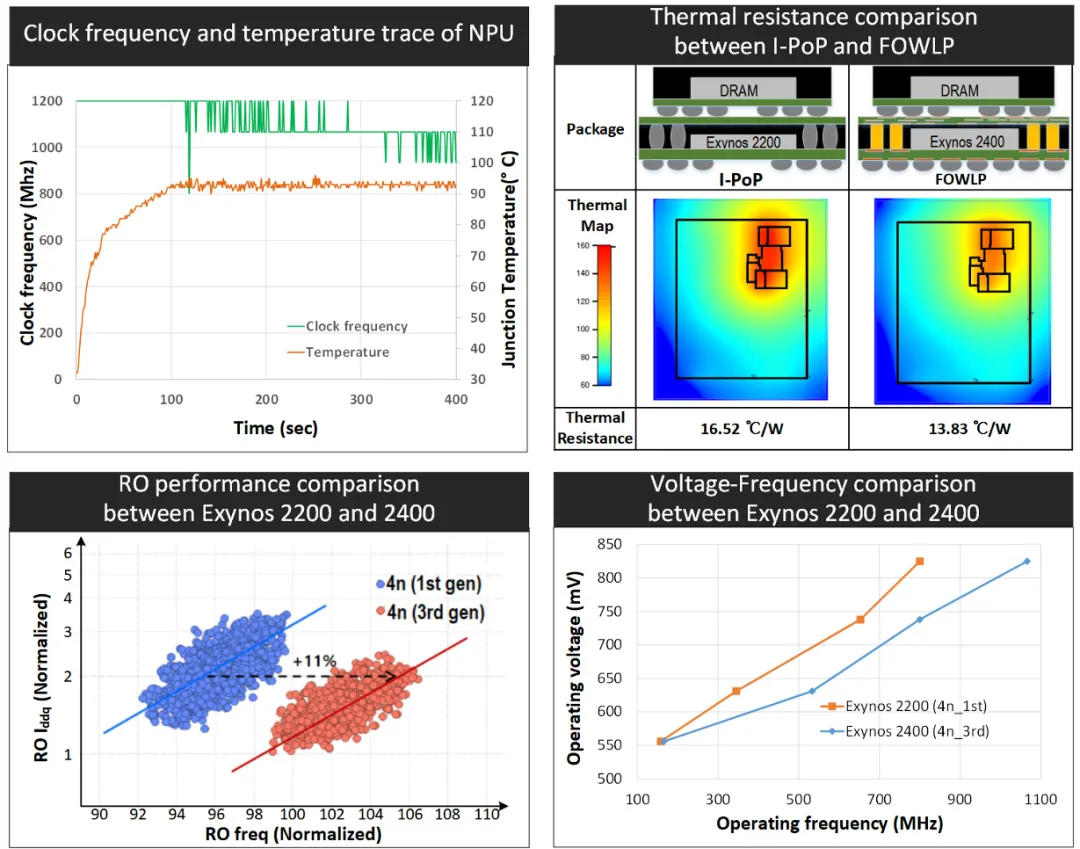
图5:通过RO AC性能增益和热阻减少实现的NPU性能改进,展示工艺和封装创新如何在相同功耗水平下提高时钟频率。
在小面积硅区域内高密度的MAC单元可能导致热管理挑战。如图5所示,NPU性能受热限制,需要降低时钟频率以防止过高的结温。
为克服这些热引起的性能限制,NPU采用了两项关键创新。首先,使用增强型第三代4nm工艺,与第一代4nm工艺相比,提供了11%的环形振荡器(RO)AC性能增益。这一改进通过源极和漏极工程、中间层线路电阻减少和替代金属栅极优化实现,降低了有效电容和电阻。
其次,NPU采用了具有优异热特性的扇出晶圆级封装(FOWLP)解决方案。与之前Exynos 2200使用的互连层封装叠层(I-PoP)相比,Exynos 2400中的FOWLP提供了更好的热阻特性。FOWLP中较大的芯片厚度和薄的重分布层增强了散热,将热阻从16.52°C/W降低到13.83°C/W,减少了16%。
工艺改进和封装创新的综合效果使NPU在相同功率水平下的最大时钟频率提高了30%,显著增强了AI应用的整体性能。
性能结果和结论
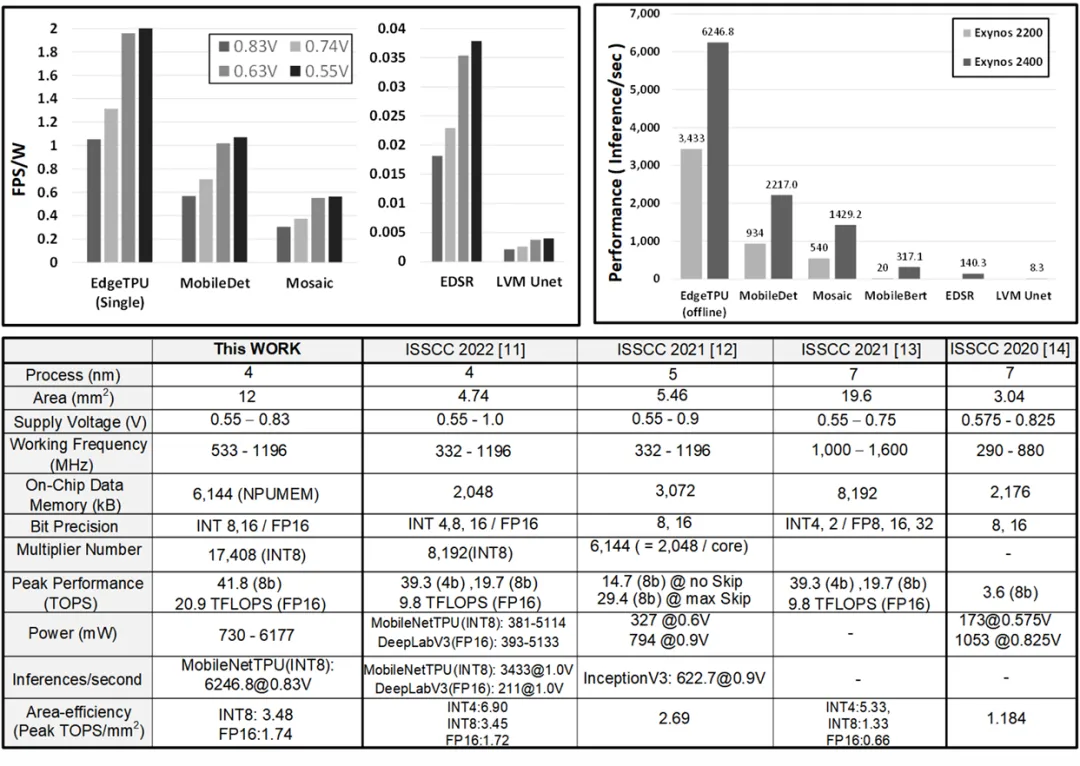
图6:测量结果和性能比较表,展示NPU在各种神经网络基准测试中的规格和性能指标。
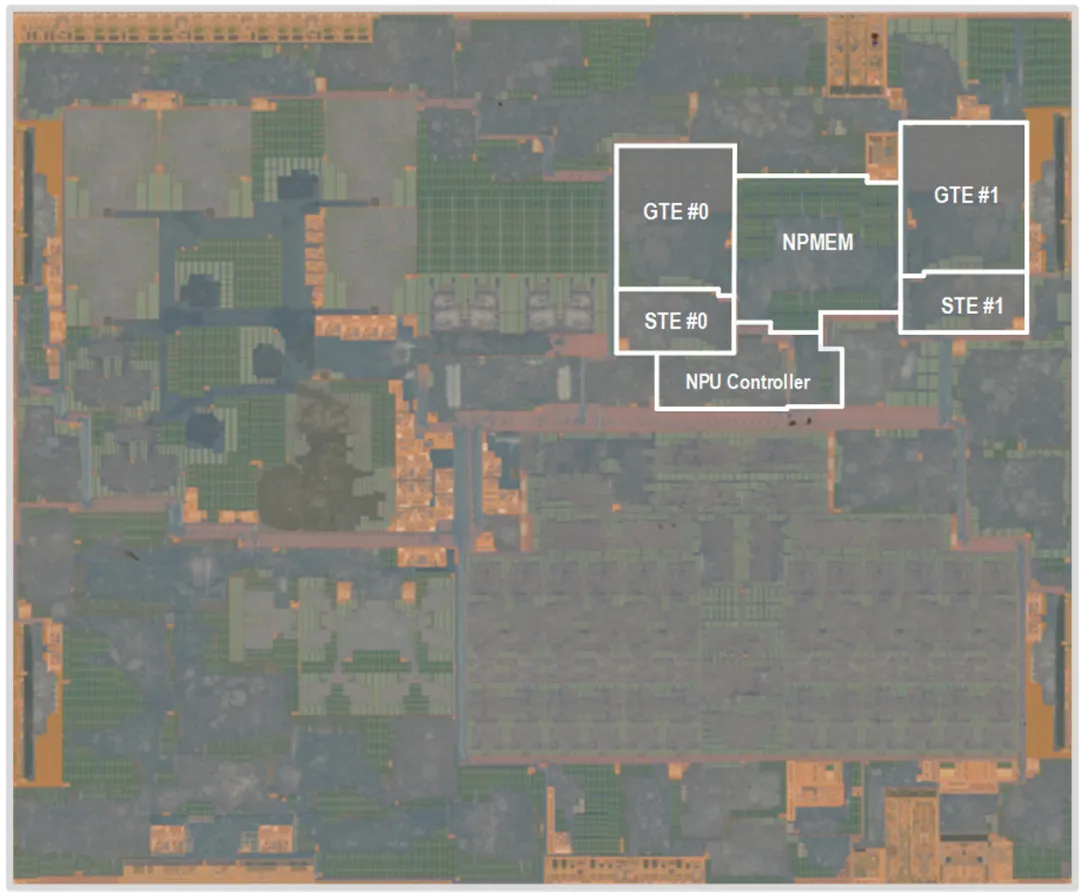
图7:Exynos 2400 SoC的芯片显微照片,突出显示了芯片中的NPU区域。
NPU占用12平方毫米的硅面积,工作电压在0.55V至0.83V之间,时钟频率范围从533MHz至1196MHz。如图6所示,NPU在各种神经网络基准测试中展示了令人印象深刻的性能。
与之前的实现相比,在1196MHz时MobileNetEdgeTPU、MobileDet和Mosaic网络的推理吞吐量分别提高了1.81倍、2.37倍和2.65倍。此外,NPU在EDSR上实现了每秒140.3次推理,在Stable Diffusion(LVM)中使用的U-net网络上实现了每秒8.3次推理。
尽管内部缓冲区大小从2MB增加到6MB,但由于优化的MAC设计和在空间方向上跨MAC共享权重缓冲区,NPU保持了3.48 TOPS/平方毫米的面积效率。图16.3.7显示了突出显示NPU的Exynos 2400 SoC芯片显微照片。
这种创新的NPU架构代表了片上AI能力的重大进步,高效支持传统的基于CNN的应用和新兴的基于transformer的生成式AI模型。通过结合异构处理引擎、优化的内存层次结构、智能tile划分策略和先进的热管理解决方案,NPU在保持功率效率的同时提供了下一代移动AI应用所需的性能。
参考文献
[1] A. Vaswani, et al., “Attention Is All You Need”, NeurIPS, 2017.
[2] A. Dubey, et al., “The Llama3 Herd of Models”, ArXiv, 2024.
[3] R. Rombach, et al., “High-resolution image synthesis with latent diffusion models”, ArXiv, 2021.
[4] J.R. Stevens, et al., “Softermax: Hardware/Software Co-Design of an Efficient Softmax for Transformers”, DAC, 2021.
[5] B. Klenk, et al., “Relaxations for High-Performance Message Passing on Massively Parallel SIMT Processors”, Int. Parallel and Distributed Processing, 2017.
[6] T. Yoo, et al., “Advanced Chip Last Process Integration for Fan Out WLP”, IEEE ECTC, 2022.
[7] V.J. Reddi, et al., “MLPerf Inference benchmark”, ISCA, 2020.
[8] M. Tan, et al., “EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks”, ICML, 2019.
[9] Y. Xiong, et al., “MobileDets: Searching for Object Detection Architectures for Mobile Accelerators”, CVPR, 2021.
[10] W. Wang, et al., “MOSAIC: Mobile Segmentation via decoding Aggregated Information and encoded Context”, ArXiv, 2021.
[11] J.-S. Park, et al., “A Multi-Mode 8k-MAC HW-Utilization Aware Neural Processing Unit with a Unified Multi-Precision Datapath in 4nm Flagship Mobile SoC”, ISSCC, pp. 246 247, Feb. 2022.
[12] B. Lim, et al,. “Enhanced Deep Residual Networks for Single Image Super-Resolution”, CVPR, 2017.
[13] J.-S. Park, et al., “A 6K-MAC feature-map-sparsity-aware neural processing unit in 5nm flagship mobile SoC”, ISSCC, pp. 152-153, 2021.
[14] A. Agrawal, et al., “7nm 4-Core AI Chip with 25.6TFLOPS Hybrid FP8 Training, 102.4TOPS INT4 Inference and Workload-Aware Throttling”, ISSCC, pp. 144-145, 2020.
[15] C.-H. Lin, et al., “A 3.4-to-13.3TOPS/W 3.6TOPS Dual-Core Deep-Learning Accelerator for Versatile AI Applications in 7nm 5G Smartphone SoC”, ISSCC, pp. 134-135, 2020.
END
 微信公众号
 bilibili
 微信视频号