


引言
半导体行业经历向基于Chiplet设计的范式转变,这种设计能够通过2.5D或3D封装技术集成专用芯片。这种方法解决了整体集成的挑战,同时提供更好的性能、良率和灵活性。通用Chiplet互连快速(Universal Chiplet Interconnect Express,UCIe)标准已成为Chiplet互连的关键标准,专注于带宽密度、能源效率和延迟等关键指标[1]。
Chiplet技术和UCIe标准简介
基于Chiplet的设计已获得显着发展势头,特别是由于人工智能和机器学习应用的日益增长的需求。这些应用需要大量计算能力,传统单片芯片设计难以实现。UCIe标准的开发旨在解决标准化Chiplet互连的需求,促进不同供应商Chiplet之间的互操作性。
Chiplet互连设计的主要挑战之一是平衡性能与功耗。动态时钟门控是减少功耗的关键技术,但在时钟门控和非门控模式之间切换会带来显着挑战。模式转换期间的瞬时电流浪涌(Di/Dt)会导致电源轨上的电压下降,进而导致数据采样不对齐和位错误。
系统架构与实现
TSMC与AMD的论文介绍了一个在3nm技术中实现的32Gb/s、64通道UCIe模块。该模块采用匹配延迟架构,专门设计用于解决动态时钟门控的挑战,同时确保低功耗和最小延迟。
系统采用2.5D先进封装技术,其中两个顶部系统级芯片(SoC)通过硅桥连接。每个芯片包括两个×64 UCIe模块,通过微凸点在硅中介层上相互连接,尺寸为3100×1500μm²。模块设计采用10列凸点模式,最小间距为45μm,在388.8μm前缘宽度内,遵循预定义的信号排序以确保链路互操作性。
图1展示了系统概述,包括多速率支持、封装横截面、芯片尺寸和模块凸点图。该图显示了UCIe接口的详细配置,通过硅桥连接的SoC顶部芯片。
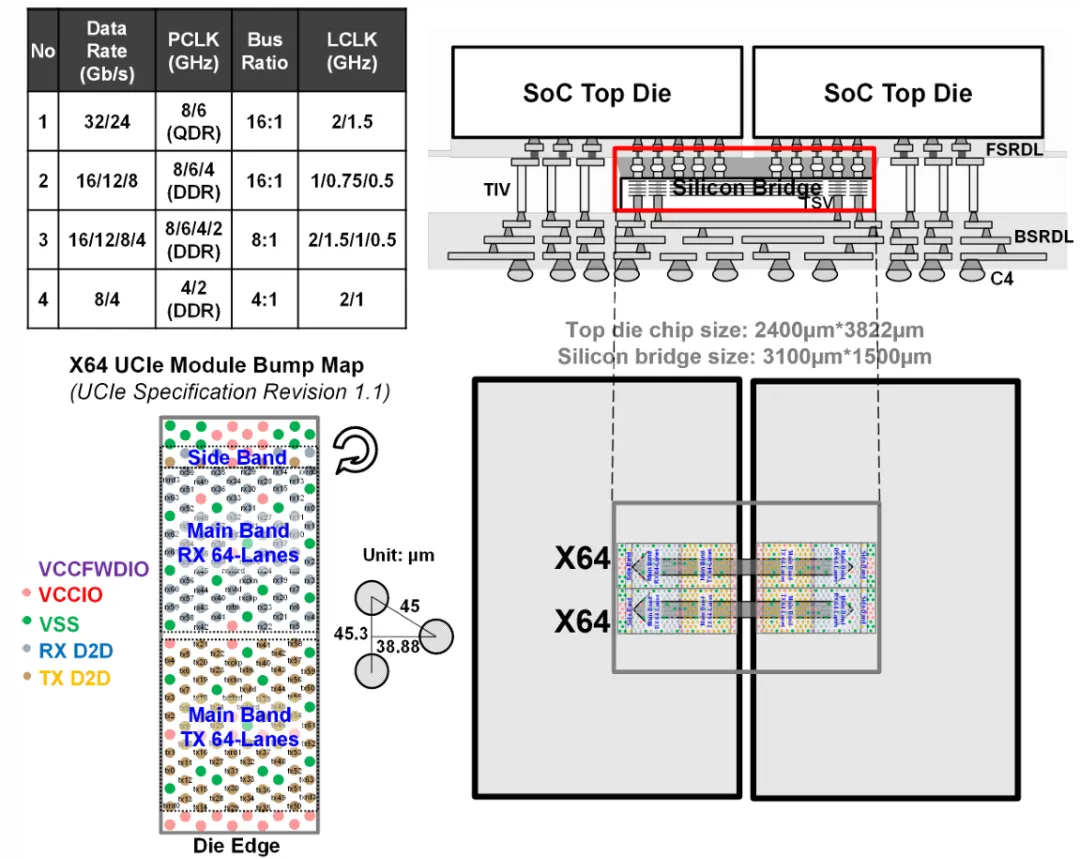
图1:系统概述,展示了通过硅桥连接的两个SoC芯片的封装横截面,以及UCIe模块凸点图和多速率支持规格。
UCIe模块支持4Gb/s至32Gb/s的数据速率,在32/24Gb/s时以四倍数据速率(QDR)模式运行,在16/12/8/4Gb/s时以双倍数据速率(DDR)模式运行。还支持各种总线比率(4:1、8:1和16:1)以适应不同的SoC应用,数字逻辑运行在0.5GHz至2GHz之间。
时钟架构与相位管理
时钟架构对于在支持动态时钟门控的同时实现高性能至为重要。在发送器侧,使用两个主要时钟:LCLK(由系统PLL生成)用于逻辑-PHY接口,ACLK(由PHY PLL生成)用于模拟PHY。
发送器支持两种时钟域交叉模式:
1. DESKEW模式:通过单个重定时触发器提供低延迟
2. TXFIFO模式:处理严重的LCLK温度或电压漂移,增加2-4T LCLK延迟和0.015pJ/b功耗
图2描述了详细的时钟架构,展示了具有数字控制延迟线(MPD_DCDL)的多相位延迟,该延迟线具有12个反相延迟级,共享粗调和微调控制。

图2:时钟架构图,展示了MPD_DCDL实现和INL消除技术,用于确保时钟信号之间的精确相位关系。
MPD_DCDL设计确保当延迟锁定环中的相位检测器对齐PH0和PH360之间的边缘时,每个级别有30度的相等延迟。这种相位延迟通过后续的基于反相器的相位插值器进一步细化,具有5位分辨率。相位旋转算法,结合特定的时钟选择布线配置,确保在正交相位之间进行一致的微调调整,以消除系统积分非线性(INL),实现0.9375度的相位调整分辨率,INL为1.06-LSB,DNL为0.37-LSB。
发送器设计与实现
发送器架构包含一个2抽头、基于1UI的前馈均衡器(FFE),以抵消通道插入损耗。数据和转发时钟通道具有相同的结构,以确保匹配延迟和使用0、90、45和135度相位的正确同步。
图3显示了详细的发送器线路架构,包括SST驱动器、脉冲级采样串行器和占空比校正器/正交误差校正器(DCC/QEC)组件。
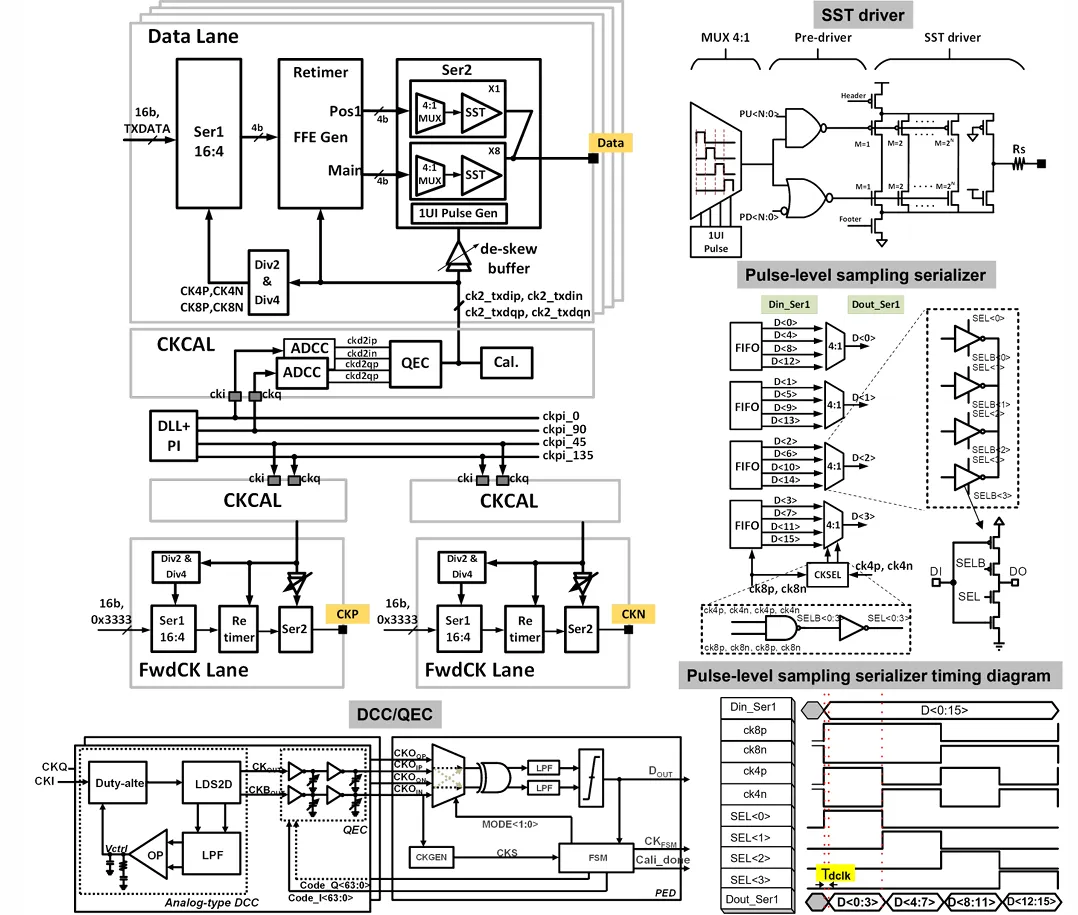
图3:发送器线路架构,展示了SST驱动器实现、脉冲级采样串行器设计以及确保时钟质量的DCC/QEC线路。
每个后级驱动器由九个源级终端(SST)驱动器组成,校准为25Ω输出阻抗。16:4串行器使用脉冲级采样通过时钟脉冲而非时钟边缘选择信号,从而减少延迟和功耗。这种方法使得FFE、重定时器和MUX的组合延迟仅为6UI。
一项关键创新是数据驱动的转发时钟生成器,通过在低速逻辑中操作同步时钟模式灵活生成转发时钟,同时保持关键的数据-时钟相位关系。DCC和QEC位于时钟路径的中间位置,以确保时钟质量。模拟DCC便于运行时校准,之后可以门控时钟以在空闲期间节省功耗。由有限状态机(FSM)控制的QEC采用斩波消除技术,消除直流偏移和器件不匹配。这些组件共同实现了小于0.3%的占空比误差和330fs的正交相位误差。
具有匹配延迟拓扑的接收器架构
接收器架构采用匹配延迟拓扑,确保数据和时钟信号在整个信号路径中保持适当的相位关系。这对于动态时钟门控特别重要,其中取消门控后的第一个时钟转换必须正确捕获数据,而不需要时钟前导码的额外延迟。
图4展示了接收器线路架构,强调了匹配延迟拓扑、自去偏能力、运行时校准以及带有P/N偏斜校准的基于反相器的接收放大器(RXAMP)。
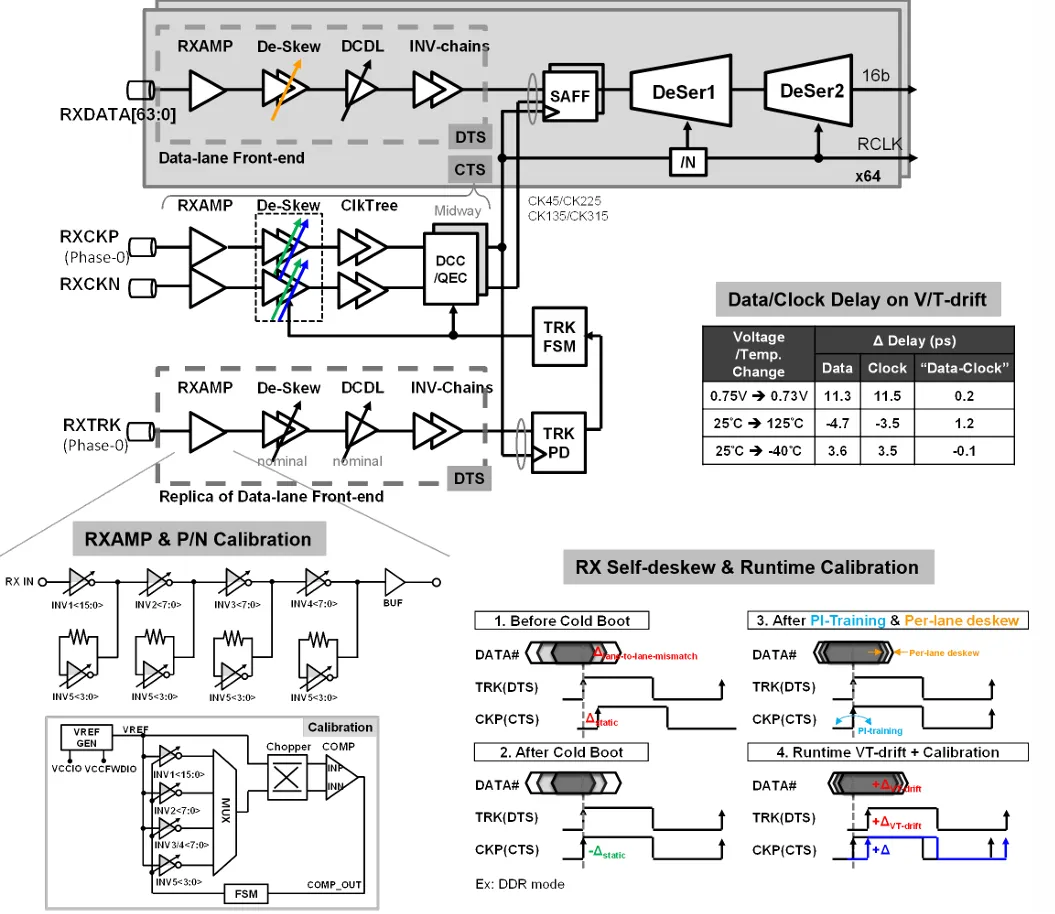
图4:接收器线路架构,展示了维持数据和时钟信号之间相位关系的匹配延迟拓扑,以及自去偏和运行时校准机制。
在接收器中,DATA和CKP/CKN延迟精确匹配,维持45度相位关系直至感应放大器触发器(SAFF)。数据和时钟路径共享类似的线路拓扑,以确保尽管电压下降或温度漂移,相位仍然一致。物理不匹配,如时钟路径中的过度RC延迟,通过数据通道中的门延迟进行补偿。
设计表现出对电源变化的出色抵抗力。20mV的Vcc扰动在数据/时钟路径中导致11.3/11.5ps的绝对延迟,仅导致两个延迟匹配结构之间0.2ps的延迟差异。器件变异性通过校准过程进一步管理。
数据通道前端作为硬化宏实现在每个接收器凸点下,Track通道(TRK)具有一个复制实例。在冷启动初始化期间,Track通道通过时钟路径中的每通道去偏缓冲器将CKP与TRK对齐,最小化数据(DTS)和时钟(CTS)路径之间的静态不匹配。随后,训练协议基于单个内置自测试(BIST)操作进行相位插值器训练和数据通道的每通道去偏,将CKP与数据眼中心对齐,同时扩大总体眼余量。
物理实现与电源完整性
UCIe模块的物理实现由于微凸点间距小而面临显着挑战,这限制了电源和接地凸点的访问。为了在避免IR压降和电源震荡问题的同时实现32Gb/s的全速测试,模块被分为九个段,每次仅激活一个段(最多8个收发器)进行位误差率测试。
图5展示了模块的物理实现,突出了分段方法、去耦电容策略、电源阻抗和电压纹波性能。
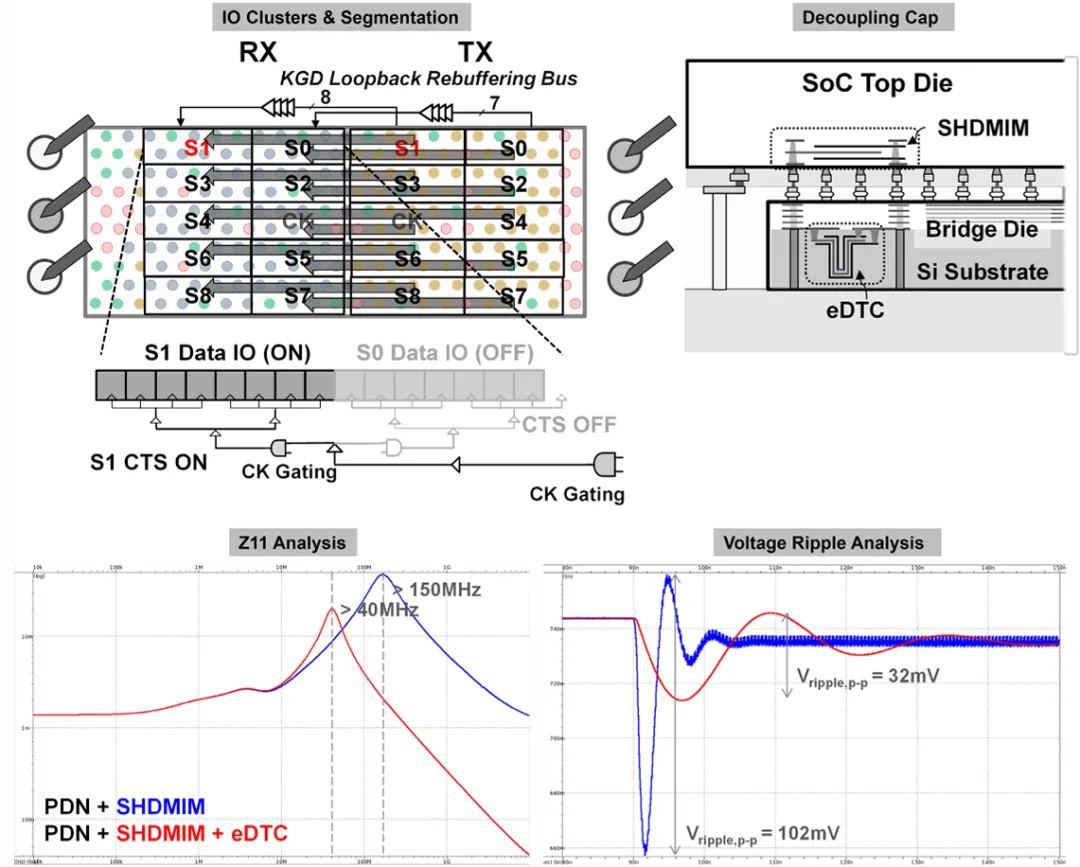
图5:模块集群分段、去耦电容策略和电源阻抗分析,展示了使用先进去耦技术时电压纹波性能的显着改善。
根据官方UCIe凸点图,TX和RX集群位于相对的两端。在已知良好芯片(KGD)分选期间,发送器的高速数据通过重新缓冲级穿过模块的一半到接收器形成回路路径,同时保持匹配延迟结构以实现同步。
采用了两种关键的去耦电容技术:
顶部芯片中的超高密度金属-绝缘体-金属(SHDMIM)电容
中介层芯片中的嵌入式深沟电容(eDTC)
SHDMIM电容虽然成本更高(50nF/mm²),但提供低等效串联电阻(ESR)并在150MHz以上共振电源平面阻抗。eDTC提供更高的电容效率(1100nF/mm²)并减轻40MHz以上的阻抗。实现显示添加eDTC后峰峰电压纹波从102mV降至32mV,突显了先进封装技术对改善电源完整性的重要性。
芯片间通道与信号完整性
芯片间通道设计对于在高数据速率下保持信号完整性很重要。图6展示了使用桥芯片中五个金属层的芯片间通道布线风格,以及信号完整性分析和眼图测量。
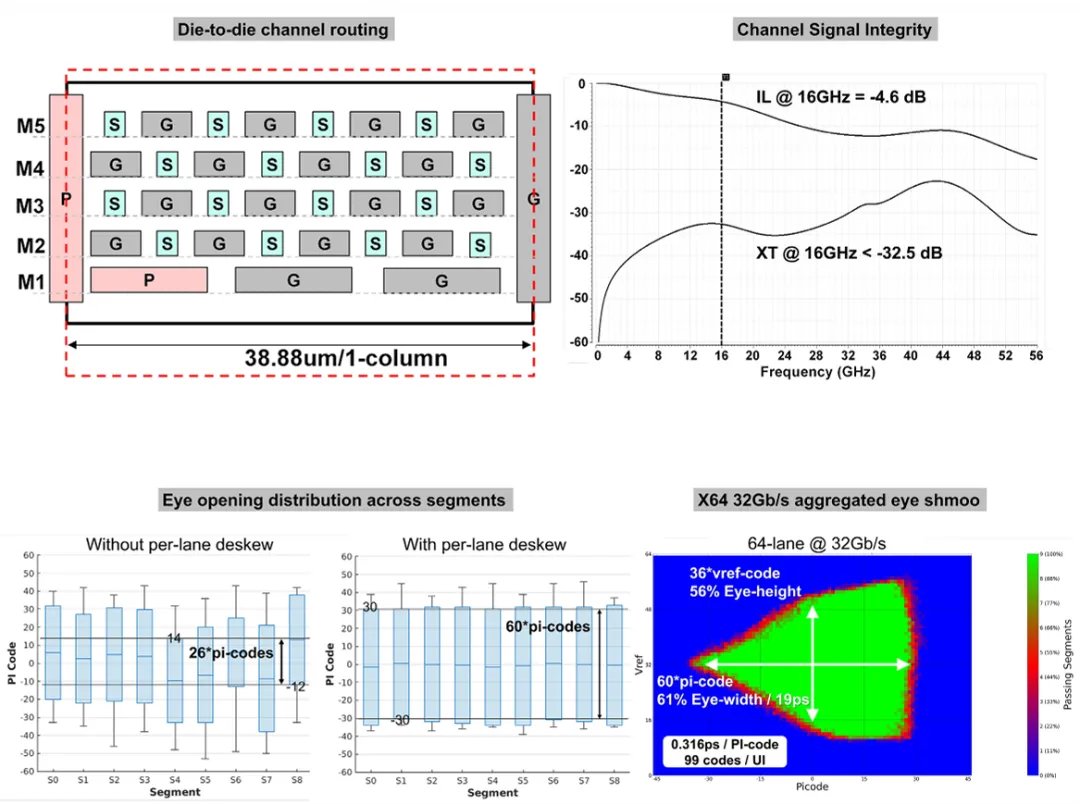
图6:芯片间布线风格、展示插入损耗和串扰性能的信号完整性分析,以及有无每通道去偏校正的测量眼图开口分布。
每条信号线都通过接地连接屏蔽,以最小化串扰噪声。该图还显示了通过九个段中64个通道的pi码测量的眼图开口分布。在每通道去偏校正后,眼图开口从26个pi码宽度(-12至+14)改善至60个pi码宽度(-30至+30),将眼图余量提高了34%UI并将眼图中心定位在pi码=0处。
通过在x轴上扫描pi码(316fs/码)和在y轴上扫描Vref码(16mV/码)获得的2D眼图shmoo,在32Gb/s操作下实现了令人印象深刻的19ps眼宽(61%UI)和56%的眼高,展示了设计的优异信号完整性。
性能与比较
图7展示了从顶部芯片俯视图的芯片照片,显示了芯片间微凸点和用于单芯片CP测试的较大间距探测凸点。该图还包括功率分布分析和与最先进技术的比较。
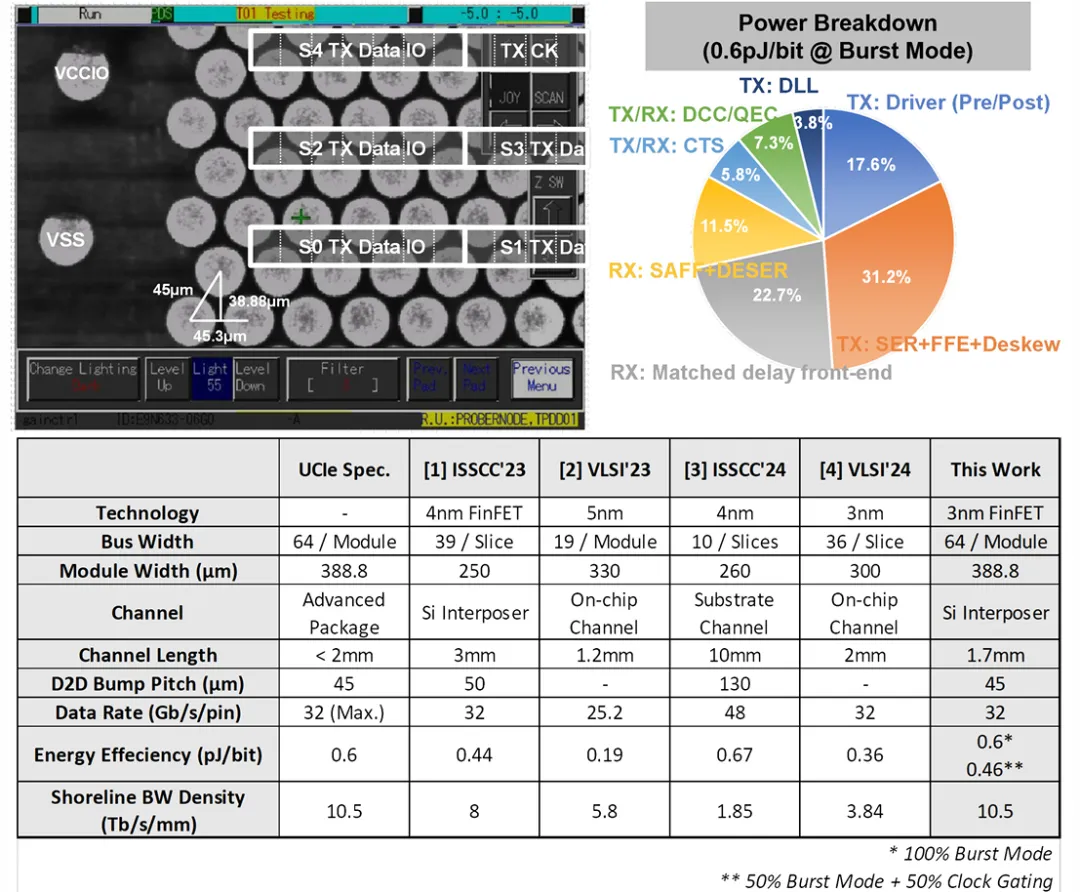
图7:芯片照片展示了微凸点和探测凸点布局,以及功率分布分析和与其他最先进实现的性能比较。
UCIe接口特有64个Tx通道和64个Rx通道,每通道实现32Gb/s,前缘带宽密度达10.5Tb/s/mm。系统在全突发模式下实现0.6pJ/b的能源效率,在50%突发模式和50%时钟门控下改善至0.46pJ/b。
与其他最先进实现相比,这项工作因高数据速率(32Gb/s)、出色的能源效率(0.6pJ/b)和卓越的带宽密度(10.5Tb/s/mm)的组合而突出。比较表显示,虽然其他一些设计在特定操作模式下实现了更好的能源效率,但该实现在完全符合UCIe标准的同时提供了性能指标的平衡组合。
结论
3nm技术中的32Gb/s UCIe兼容接口代表了Chiplet互连技术的重大进步。通过用于动态时钟门控的匹配延迟架构等创新线路技术,该设计解决了实现高带宽密度、能源效率和低延迟的关键挑战。
匹配延迟方法确保数据和时钟信号之间的正确同步,即使在时钟门控和非门控模式之间切换时,也不需要时钟前导码的额外延迟。通过精心的线路设计和校准机制,该实现也展示了对电源供应变化和器件变异性的出色抵抗力。
物理实现利用了先进的封装技术,包括SHDMIM和eDTC去耦电容,以改善电源完整性。芯片间通道设计采用接地屏蔽信号线和每通道去偏校正,确保在32Gb/s操作下的出色信号完整性。
随着基于Chiplet的设计继续在解决AI和ML应用日益增长的计算需求方面发挥重要作用,像UCIe这样的标准化互连解决方案将在实现下一代高性能计算系统中发挥关键作用。该实现表明,UCIe标准可以实现先进Chiplet集成的带宽密度、能源效率和延迟要求,同时保持不同供应商Chiplet之间的互操作性。
参考文献
[1] M. Lin et al., "A 32Gb/s 10.5Tb/s/mm 0.6pJ/b UCIe-Compliant Low-Latency Interface in 3nm Featuring Matched-Delay for Dynamic Clock Gating," 2025 IEEE International Solid-State Circuits Conference (ISSCC), San Francisco, CA, USA, 2025, pp. 586-587.
END
 微信公众号
 bilibili
 微信视频号