


引言
UCIe代表着芯片到芯片互连技术的重大进步,旨在支持从单片式设计向基于Chiplet的架构的行业转变。本文探讨了UCIe电气链路线路的技术需求、架构考虑因素和最新创新,内容基于UCIe联盟电气工作组联合主席Zuoguo (Joe) Wu在IEEE ISSCC 2025论坛的演讲[1]。

从单片式SoC到Chiplet的演变
半导体行业在近50年来一直受到摩尔定律的驱动,通过CMOS工艺的持续改进,实现了越来越复杂的单片式系统芯片(SoC)设计。然而,随着CMOS缩放开始减速,行业正在向模块化方法转变,使用Chiplet——可以集成到完整系统中的较小、专用芯片。
这种转变受到多种因素的推动。首先,节点缩放的经济效益正在减少,使异构集成变得更具吸引力。其次,Chiplet架构允许混合不同的工艺技术,针对特定功能进行优化。发展路径现在超越了简单的Chiplet,包括结合CMOS、CNT和MRAM等多样技术的异构3D集成。
硅缩放趋势表明,在22纳米节点之后,传统缩放带来的性能提升已显着放缓。作为回应,行业开发了多种集成方法——3D单片式、3D键合和3D封装——每种方法提供不同的性能特性和制造复杂性。向极端异构化的转变不仅是制造策略,更是系统架构设计理念的根本转变。

图1:从单片式SoC到Chiplet和异构3D集成的转变,曲线描绘了向极端异构化的发展过程。
芯间互连类型
现代半导体封装提供多种集成策略,每种策略对芯间互连具有不同的优势。2D集成方法使用标准封装走线,提供最佳的封装平面布局灵活性。UCIe和XSR是支持此方法的互连标准示例。与更先进的集成技术相比,此方法提供最大的设计自由度,但性能适中。标准封装走线的传输特性带来信号完整性挑战,特别是在更高数据速率下,需要通过均衡技术解决。
2.5D集成方法采用硅桥或硅中介层,提供更优越的横向连接关键性能指标(KPI)。这些硅结构比标准封装基板提供更精细的线宽和更好控制的阻抗特性。虽然相对成本更高且平面布局选择受限,但2.5D集成显着提高了带宽密度和信号完整性。通过英特尔EMIB等硅桥或台积电CoWoS等中介层的电气路径,寄生效应减少且耦合更紧密,实现更高数据速率。UCIe和HBM(高带宽存储器)标准支持此集成方法,针对改进的通道特性进行特定优化。
3D集成代表着封装技术的前沿,利用硅中介层或混合键合集成(HBI)。通过显着减少互连长度并利用完整的三维空间,该方法实现了最佳功耗效率、最低延迟和最高带宽密度。3D堆叠中的垂直连接,通常通过硅穿孔(TSV)和面对面键合技术实现,从根本上改变了互连设计约束。尽管封装成本更高且硅面积平面布局受限,3D集成为高性能应用提供了令人信服的优势。UCIe-3D和HBM/DRAM接口专为这些堆叠技术设计,具有应对垂直信号传播独特挑战的专门电气特性。
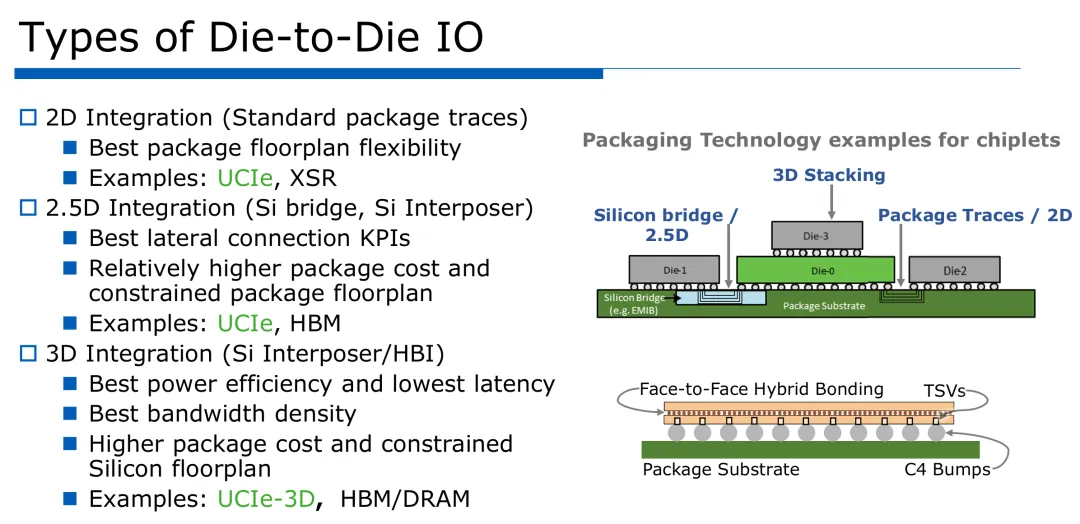
图2:不同的Chiplet封装技术,展示了2D、带硅桥的2.5D和3D堆叠方法及其物理特性。
Chiplet互连的关键指标和采用标准
任何芯间互连技术要获得广泛采用,必须满足多个关键技术指标,同时解决更广泛的生态系统需求。带宽密度,按线性(GB/s/mm)和面积(GB/s/mm²)衡量,决定了互连如何有效利用可用的硅边缘和面积。此指标直接受封装技术的可实现数据速率和最小凸点间距影响。UCIe实现范围广泛,从标准封装的28-224 GB/s/mm到高级封装的165-1317 GB/s/mm不等。
能源效率,以每比特皮焦耳(pJ/b)计量,随着互连功耗成为系统总功耗更大部分而变得越发重要。UCIe经过优化,根据实现不同可达到0.25-1.25 pJ/b,比传统的片外链路效率高约20倍。这种效率通过可扩展的能源消耗设计和复杂的低功耗模式实现,典型进入/退出时间约为0.5ns。这些特性组合允许系统在活动和空闲状态之间快速转换以节省功耗,同时不牺牲响应性。
延迟,从发送器输入到接收器输出测量,直接影响许多应用的系统性能。UCIe在16GT/s时目标为约2ns,在其他数据速率下的值因不同的序列化方法和传输时间考虑而有所不同。这种低延迟通过精简的物理层设计和最小协议开销实现。
通道覆盖能力决定了信号在保持完整性的同时可以传输的最大距离。UCIe标准封装支持高达25mm的覆盖,而高级封装由于设计目标不同,通常针对2mm覆盖。跨工艺节点、操作频率和位错误率(BER)目标的技术兼容性确保了在不同半导体制造工艺和应用需求中的广泛适用性。
影响行业采用的更广泛因素包括跨供应商和技术的互操作性,通过标准化的电气规范和合规测试方法实现。通过支持PCIe和CXL等已建立的协议,确保与现有软件的完整堆栈兼容性。该技术对电源传输、冷却和修复策略的适应性解决了制造和运营关注点,而通过开放标准的广泛行业生态系统支持促进了在半导体行业的采用。
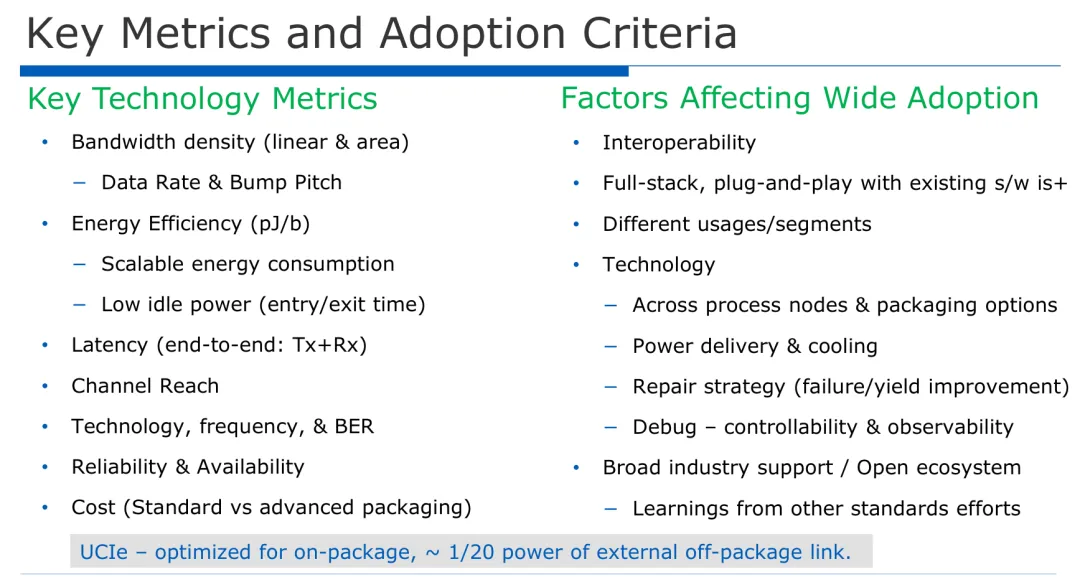
图3:比较了关键技术指标与影响广泛采用的因素,强调了UCIe对片上连接的优化,显着降低了功耗。
UCIe规范架构
UCIe规范采用分层架构方法,在保持高性能的同时最大化灵活性和互操作性。在基础层面,物理层在电气层面处理芯间I/O,实现链路训练、通道修复/反转、扰码、模拟前端功能、时钟、侧带通信和配置寄存器。该层还定义通道要求并确保符合电气规范。物理层设计为适应不同的封装技术,同时保持一致的性能特性。
中间层,称为芯间适配器,作为可靠性层负责确保可靠的数据传输。当使用多个协议时,实现仲裁和多路复用,处理CRC/重试机制进行错误检测和纠正,管理链路状态转换,并支持连接设备之间的参数协商。适配器维护可访问高级功能的配置寄存器,在原始模式下可完全绕过,用于需要直接访问物理层的专用应用。这种灵活性允许标准化和定制实现在UCIe框架内共存。
在堆栈顶部,协议层支持多种接口类型,以适应多样化的使用模型。主要支持的协议是CXL/PCIe,适用于需要标准化"即插即用"功能的大量应用,如I/O附件、内存接口和加速器。这些协议利用现有软件生态系统,实现与当前系统架构的无缝集成。对于更专业的应用,UCIe还支持流式接口,可容纳AXI、CHI、SFI和CPI等专有协议。这种流式方法对于从较小芯片构建更大计算单元的扩展场景特别有价值,例如由多个较小元素组成的CPU、GPU和网络交换机。
完整规范涵盖从物理凸点/键合焊盘层到形状因素定义的互连,为跨不同封装技术和应用领域的Chiplet集成创建了全面框架。
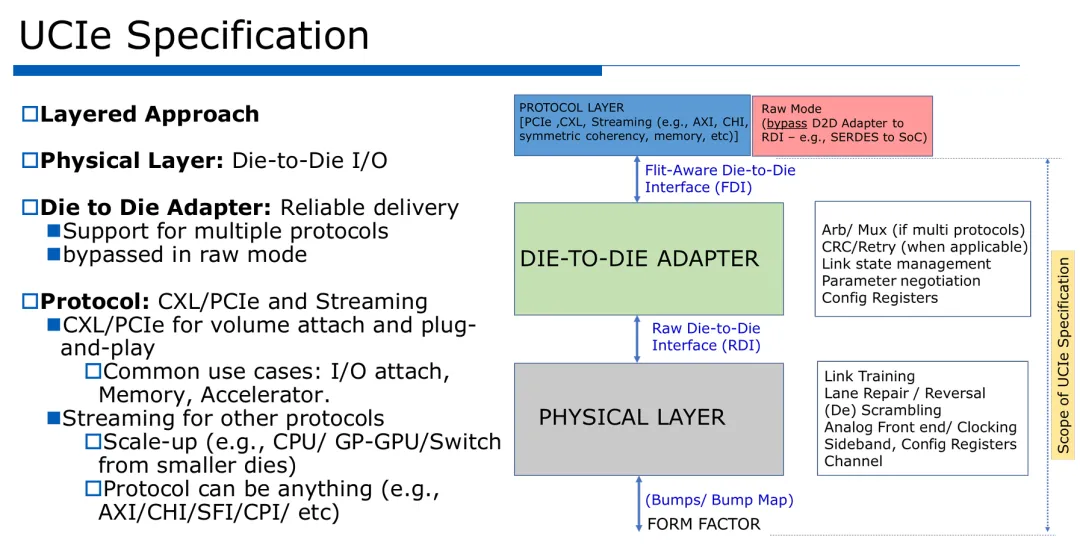
图4:UCIe规范的分层架构,展示了协议层、芯间适配器和物理层及其各自功能和层间接口。
UCIe标准和高级封装选项
UCIe的一个显着优势是在单一统一规范中支持多样化的封装方法。这种灵活性创造了开放生态系统,使芯片可以由不同供应商制造和组装,潜在地在同一封装中混合2D和2.5D集成,以优化成本和性能权衡。
标准封装(2D)方法利用传统基板布线技术,提供具有更长互连距离的经济有效解决方案。这些标准封装走线的电气特性包括与更先进选项相比更高的损耗和串扰,但UCIe的均衡能力确保在数据速率高达32GT/s且距离达25mm的情况下可靠运行。这种方法适用于对带宽敏感度较低的应用或成本优化设计,需要平衡性能要求与制造经济性。
高级封装(2.5D)方法利用硅互连技术提供能效高、带宽密度高的连接。UCIe支持多种高级封装选项,包括硅桥(如英特尔的EMIB)、硅中介层(如台积电的CoWoS)和集成扇出技术(台积电的InFO)。这些技术实现了更精细的线宽和更好控制的阻抗特性,支持高达32GT/s的数据速率,与标准封装相比带宽密度显着提高(高达1317 GB/s/mm)。较短的2mm通道覆盖是为改进的信号完整性和更高的互连密度而做的故意权衡。
UCIe跨这些多样化封装选项的统一规范促进了芯片设计重用和兼容性。设计有UCIe接口的芯片可以在不同的封装技术中实现,无需重新设计,允许半导体公司根据特定产品需求而非接口限制优化其制造和集成策略。
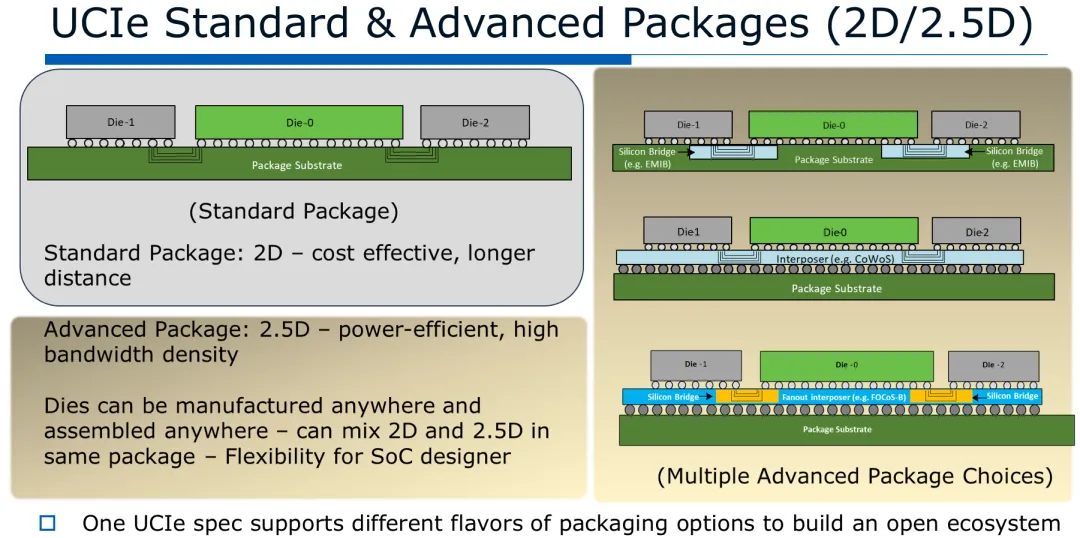
图5:各种UCIe封装选项,包括标准2D封装和使用硅桥和中介层的多种高级2.5D封装配置。
UCIe PHY架构和特性
UCIe物理层(PHY)融合了许多技术创新,以在不同实现场景中优化性能、功率效率和可靠性。数据路径延迟经过精心优化,对于数据速率高达16 Gb/s的设计为12单位间隔(UI),对于24-32 Gb/s的设计为16 UI。实际上,这转化为在16 Gb/s时包括适配器层在内的总延迟低于2ns,即使多个Chiplet必须通信,也能实现响应灵敏的系统行为。
一个突出特点是超快空闲退出能力,允许链路在不到1ns的时间内从省电空闲状态转换到活动操作。这比典型的串行I/O技术快数个数量级,后者通常需要数十或数百纳秒才能完成类似转换。这种快速唤醒能力对于能量比例计算重要,允许精细粒度的电源管理而不会显着降低性能。
有效帧机制采用汉明距离4编码,大幅提高可靠性,支持三重错误检测或具有双重错误检测的单错误纠正。这种方法确保数据完整性,无需复杂的前向错误纠正方案,后者会增加功耗和延迟。
电源管理通过多种机制实现,包括L1电源状态和可根据特定应用需求定制的额外断电选项。对于高级封装,UCIe结合了冗余和修复机制(每32位两个),以解决高密度互连制造良率挑战。
数据扰码用于缓解电源噪声,无需额外引脚,如传统方法如DBI(数据总线反转)所需。扰码算法经过精心设计,打破可能导致电磁干扰或电源扰动的重复模式。
对于特别匹配良好的通道,UCIe定义了紧密耦合模式,通过减少均衡要求和简化时序恢复,实现进一步优化。该架构包括匹配的线路设计和互连,以优化发送器和接收器组件之间的信号完整性,确保即使在数据速率增加的情况下也能可靠运行。

图6:UCIe PHY架构,包括高级和标准封装模块,突出显示主要组件,包括序列化器、TX/RX模块和时钟分配。
驱动器和输入缓冲器考虑因素
UCIe规范定义了参考线路架构,同时允许实现灵活性,以适应不同的工艺技术和设计方法。典型的发送器实现采用具有独立控制强度段的分段驱动器。虽然参考设计中通常显示CMOS实现,但规范允许替代结构,如NMOS-NMOS(NN)驱动器,适用于特定工艺技术或性能目标。
对于24 GT/s及以上的数据速率,需要至少一个前置游标抽头的TX线性均衡器(TXLE)来补偿通道损耗。这种均衡在链路初始化期间进行训练,而不需要连续适应,简化了线路设计,同时仍提供有效的通道补偿。规范故意不强制实时适应,以避免不必要的功耗和复杂性。
在接收器侧,当适用时指定接地终端,具体实现细节可以根据技术和性能要求而变化。输入缓冲器设计保持灵活,规范不强制任何特定架构。对于使用RX放大器的实现,建议带宽大于数据速率的0.75倍(相当于奈奎斯特频率的1.5倍),确保足够的信号保真度而不会过度消耗功率。
对于焊盘电容成为显着因素的标准封装,建议使用T-线圈网络来减少有效电容负载。这些电感结构创建谐振线路,扩展接口带宽,实现更高的数据速率,而无需更激进的均衡。T-线圈放置和特性可以针对特定的封装参数和性能目标进行优化。
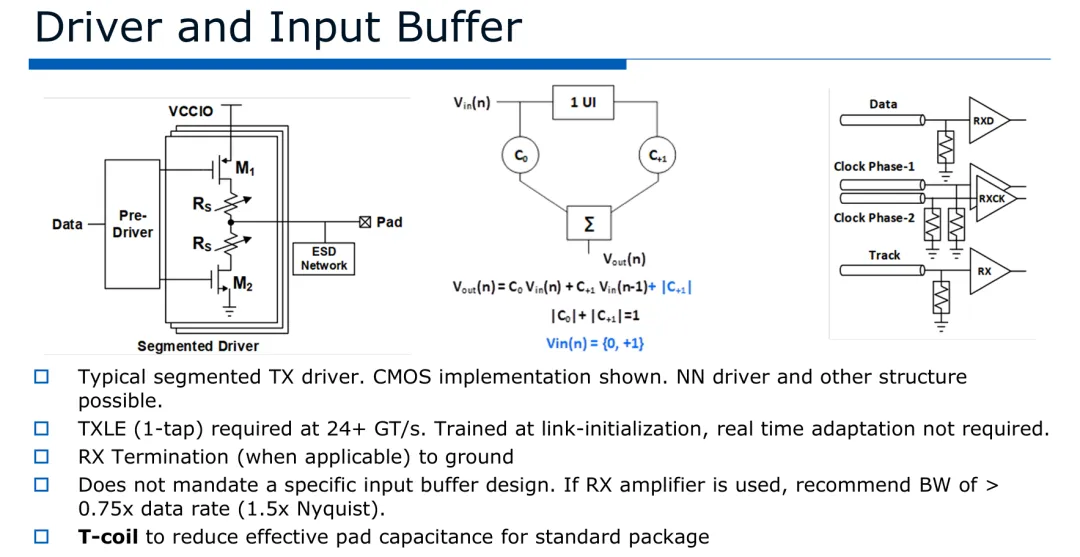
图7:UCIe的驱动器和输入缓冲器实现,包括分段驱动器设计、TX均衡和RX缓冲器方法。
PHY时钟
UCIe时钟系统结合了复杂的时序控制机制,在高数据速率下保持信号完整性,同时优化功耗。该架构支持发送器和接收器线路的2路和4路交织,允许设计者选择时钟频率和线路复杂性之间的适当平衡。例如,4路交织允许32 GT/s链路使用8 GHz时钟而非16 GHz,减少高频时钟分配的挑战。
独立的奇/偶相位控制提供精细的时序调整,以补偿工艺变化和通道特性。这种方法允许每个数据通道单独优化,而无需完全重新设计时钟分配网络。
规范根据数据速率要求定义了三级相位调整。全局TX调整同时影响所有发送器,而局部TX和RX调整可应用于特定通道。更高的数据速率需要更复杂的相位控制以保持时序裕度,最先进的实现采用所有三种调整机制。
数据有效位具有两个关键功能:当没有数据传输时门控时钟分配以节省功率,并提供帧信息以确保正确的数据对齐。这种双用途信号同时提高了能源效率和可靠性。
跟踪位促进在操作期间的背景训练和相位对齐,允许链路适应温度和电压变化,而不会中断数据传输。这种连续适应能力确保即使在具有挑战性的环境条件下也能稳健运行。
不同数据速率的时钟频率和所需相位精确指定,更高的数据速率需要更精确的时序控制。例如,32 GT/s操作通常使用16 GHz时钟,相位差为90°和270°,而去偏斜功能成为必需,以补偿接口间的时序变化。
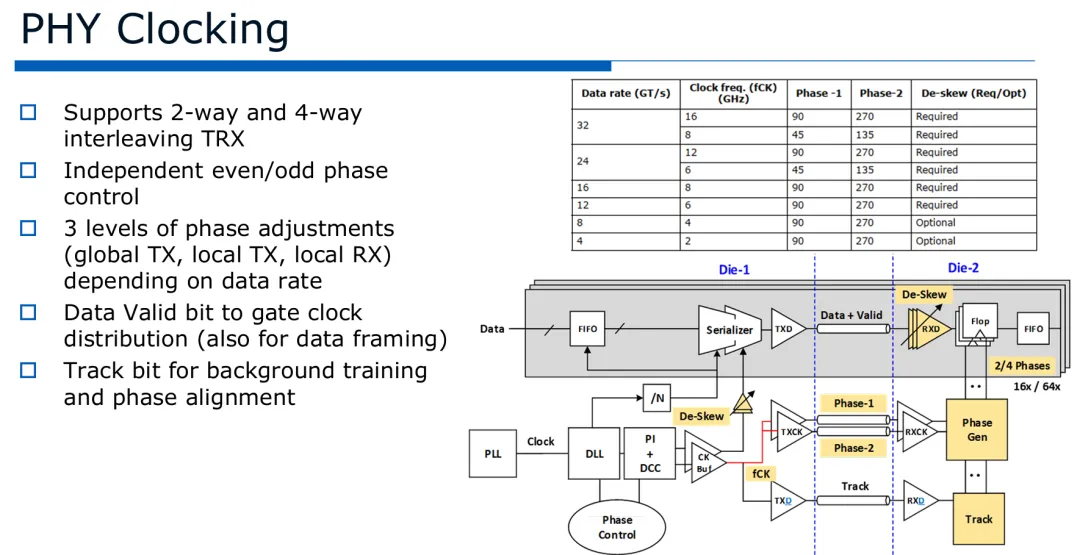
图8:PHY时钟架构,包括相位控制机制、时钟生成和跨多个数据通道的分配。
UCIe电气性能总结
UCIe提供适应各种集成方法和性能需求的全面配置范围。规范为标准封装(具有16位宽接口)和高级封装(具有64位宽接口)在多种数据速率下定义了性能参数。
对于标准封装,数据速率范围为4至32 GT/s,通道覆盖范围为2-25mm,取决于实施。功率效率范围为0.25至1.25 pJ/bit,更低功耗的设计通常在更低数据速率下运行。带宽密度指标显示令人印象深刻的能力,在最高数据速率下,线性(边缘)密度达到224 GByte/s/mm,面积密度达到145 GByte/s/mm²。
高级封装进一步推动这些边界,支持4至32 GT/s的数据速率,但针对硅中介层或桥技术优化的较短2mm覆盖。其功率效率范围为0.25至0.6 pJ/bit,反映了较短互连长度的好处。带宽密度优势显着,线性密度高达1317 GByte/s/mm,面积密度高达1075 GByte/s/mm²——比标准封装实现高约6-7倍。
规范包括根据数据速率和封装类型变化的详细BER目标。较低数据速率(4-12 Gb/s)通常针对极低错误率10^-27,而更高数据速率(16-32 Gb/s)使用更常规10^-15目标,平衡了性能与实际实现约束。特别是在较低数据速率下,严格的错误率要求确保即使在具有挑战性的环境中也能极其可靠地运行。
PHY接口的物理尺寸精确定义,以确保互操作性。基于32接口参考,标准封装接口每模块有效宽度为571.5 μm,而高级封装减少到388.8 μm,反映了其更高密度能力。这些尺寸,连同标准化凸点模式,使来自不同供应商的Chiplet能够无缝协同工作。
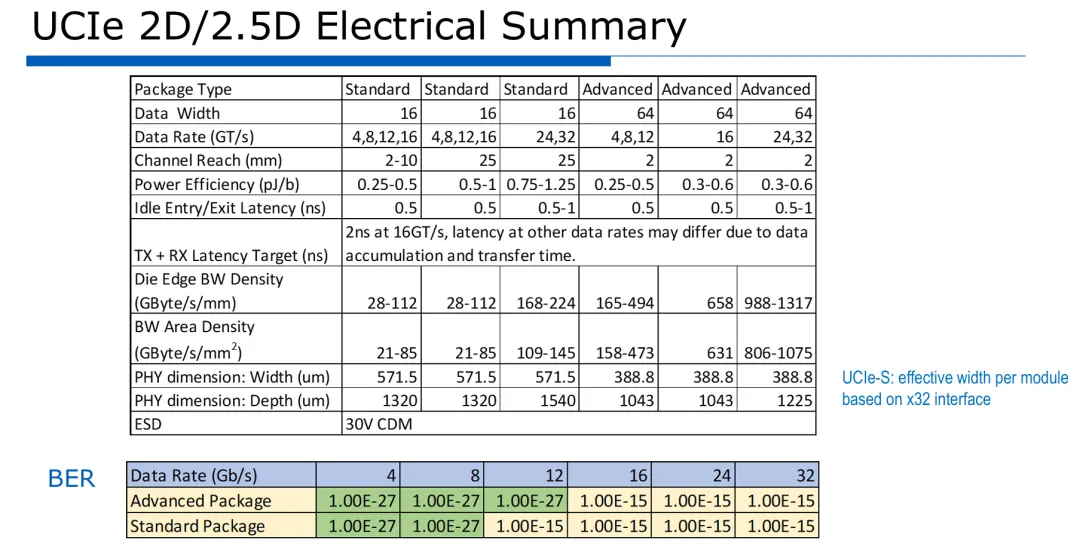
图9:总结了UCIe 2D/2.5D电气规范,涵盖不同封装类型、数据速率和性能参数。
通道合规性和信号完整性
为确保不同实现之间的可靠运行,UCIe使用眼图掩模方法定义了全面的通道合规要求。每个通道必须在使用标准化行为发送器和接收器模型的模拟下满足最小眼图mask要求,确保不管具体实现细节如何都能保持一致性能。
眼高规范对所有数据速率均设置为40mV,提供足够的电压裕度进行可靠检测。眼宽要求随数据速率而变化,4-16 Gb/s指定为0.75 UI,而24-32 Gb/s启用均衡时放宽到0.65 UI。这种自适应方法认识到了更高数据速率下增加的通道挑战,同时保持足够的时序裕度确保可靠运行。
UCIe不仅依赖传统S参数方法,还使用电压传输函数(VTF)方法定义插入损耗和串扰规范。这种方法特别适合Chiplet互连典型的短传输线,传统S参数模型可能无法捕获所有相关效应。VTF方法直接评估从发送器到接收器的电压传输特性,以与实际线路行为良好关联的方式结合所有寄生效应。
规范定义了插入损耗限制,确保从DC到奈奎斯特频率的频率范围内有足够信号到达接收器。类似地,串扰规范限制相邻通道间的干扰,以在密集互连环境中保持信号完整性。这些限制使用频域mask定义,可在设计和合规测试期间高效验证。
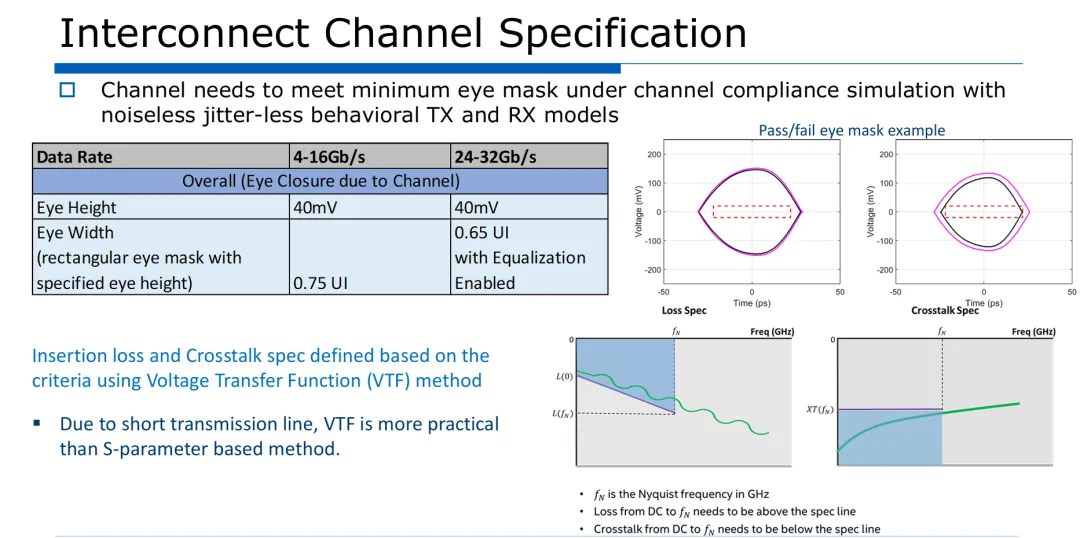
图10:通过/失败眼图mask示例,并使用电压传输函数方法跨频率范围说明插入损耗和串扰规范。
UCIe-3D:扩展到垂直维度
UCIe-3D代表着标准向3D集成扩展的重大进展,应对使用面对面混合键合等先进技术的独特需求。与传统2D和2.5D连接不同,3D互连必须在极其受限的区域内运行,同时提供特殊的功耗效率和带宽密度。
UCIe-3D的基本要求是紧凑设计,线路和逻辑局限于凸点区域。这一约束需要比2D对应部分更简单的线路,在更低频率下运行。对于目标为1μm凸点间距的最先进实现,每通道的面积必须小于1μm²,推动了线路微型化的显着创新。
该标准采用最小PHY方法,将系统级芯片逻辑(片上网络)直接连接到PHY,没有芯间适配器层的开销。这种简化之所以可能,是因为3D堆叠中几乎为零的通道距离消除了许多在更长覆盖实现中需要复杂均衡和错误纠正的信号完整性挑战。由此产生的架构保持极低延迟,同时减少功耗。
为测试和调试目的,UCIe-3D将功能集中在为Chiplet内所有3D链路服务的公共模块中。这种方法提高了面积效率,同时确保全面的测试覆盖。测试基础设施连接到每个Chiplet内的SoC逻辑网络,允许跨整个3D堆叠进行协调测试。
UCIe-3D的修复策略在集群级别而非单独通道上运行。当在制造或初始化期间检测到缺陷时,SoC逻辑可以重新配置网络以绕过失败的连接。这种集群范围的方法提供了强大的良率改进,同时适应3D制造的现实,其中缺陷往往同时影响多个相邻连接。

图11:此图展示了UCIe-3D架构,SoC逻辑直接连接到PHY组件,以及处理3D Chiplet连接中故障的路由方法。
混合键合先进集成
混合键合代表着芯片互连技术的前沿,结合介电键合与金属(通常是铜)键合,实现极细间距的连接。这项技术延续了互连方法的历史演进,从线键合到焊料凸点再到微凸点,现在发展到晶圆级的直接键合。
混合键合过程始于室温下的氧化物对氧化物内部键合,在芯片表面之间创建初始连接。随着结构加热,金属和氧化物不同的热膨胀系数使金属键合垫靠近。进一步加热然后在不需要外部压力的情况下压缩金属,形成坚固的电气连接,同时保持周围介电材料的结构完整性。
这种方法实现了间距低于10μm的连接,技术路线图可能扩展到1μm甚至更小的尺寸。与传统焊料凸点相比,直接键合机制减少了互连寄生效应(电阻和电容)约90%,显着提高了能源效率和信号完整性。
成功的混合键合需要具有精确控制冶金的极其平坦光滑的表面。氧化物表面通常必须达到小于1nm的粗糙度,而金属表面要求小于3nm的粗糙度。这些严格要求影响了制造工艺和线路设计方法。
对UCIe-3D设计的重要考虑是,混合键合连接中的单个缺陷可能由于极其紧密的间距而影响多个相邻垫。这种聚类效应直接影响了UCIe-3D修复策略,侧重于绕过缺陷簇而非单独连接故障的重新路由。
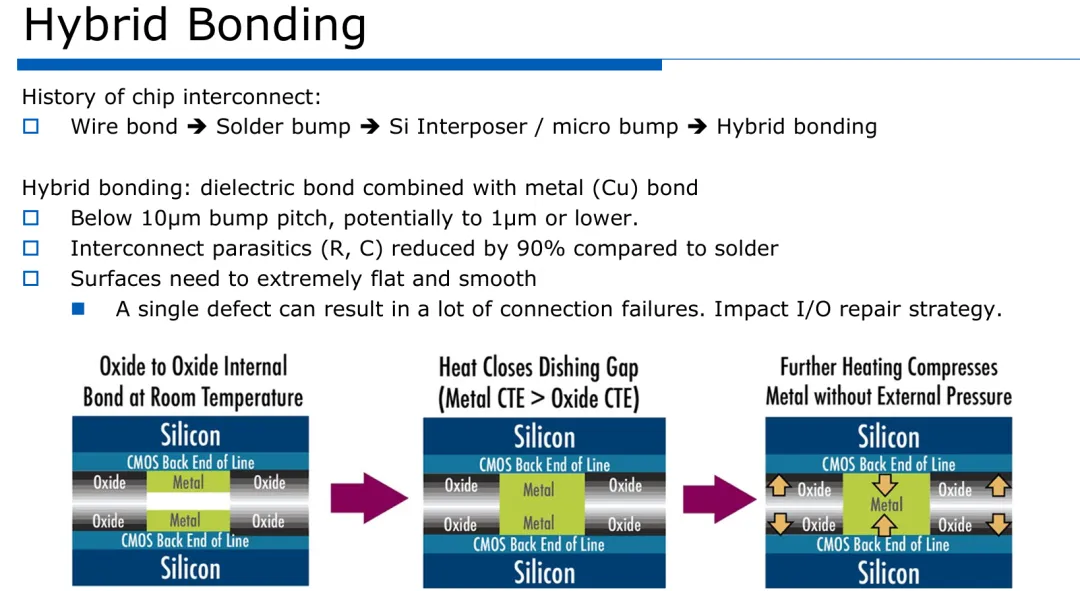
图12:混合键合过程,展示了从室温下的氧化物对氧化物内部键合,到通过加热阶段不需要外部压力的金属压缩的进展。
UCIe-3D PHY电气考虑因素
UCIe-3D PHY电气设计代表了在实现匹配架构的噪声抑制优势与避免此类方法通常相关的功耗增加之间的精心平衡。这一挑战的出现是因为传统匹配设计往往需要额外线路而增加功耗,直接与3D集成的功率效率目标相矛盾。
设计必须满足基本时序方程,确保在所有操作条件下可靠运行:
max(TAclk) − min(TAclk) + max(TBclk) − min(TBclk) + Tmismatch + Tsetup + Thold < Tcycle
该方程考虑了两个芯片中的时钟时序变化(TAclk和TBclk)、信号路径不匹配(Tmismatch)以及接收线路的建立和保持时间要求。以最小裕度满足此时序约束对于在保证可靠性的同时最大化性能重要。
对于像UCIe-3D这样的功率受限系统,信号方案的选择显着影响能源效率。分析表明,对于短距离、低损耗的3D连接,简单的NRZ(非归零)信号提供了最佳功率效率。虽然PAM-4(具有4个电平的脉冲幅度调制)等更复杂的方案可以降低给定数据速率的波特率,但需要更高的信噪比,最终增加总功耗。
UCIe-3D的功率优化方法专注于根据每比特能量方程最小化总开关电容和操作电压:
E(pJ/b) = (Cdat/4 + Cck/N) × Vdd²
其中Cdat代表与数据位相关的电容,Cck代表与时钟相关的电容,N是数据速率与时钟频率的比率,Vdd是操作电压。该方程揭示,增加N(每个时钟周期的数据位数)只有在所需线路复杂度增加因子小于N时才能提高效率。对于实际实现,N值为1或2通常提供性能、灵活性和功率效率的最佳整体平衡。
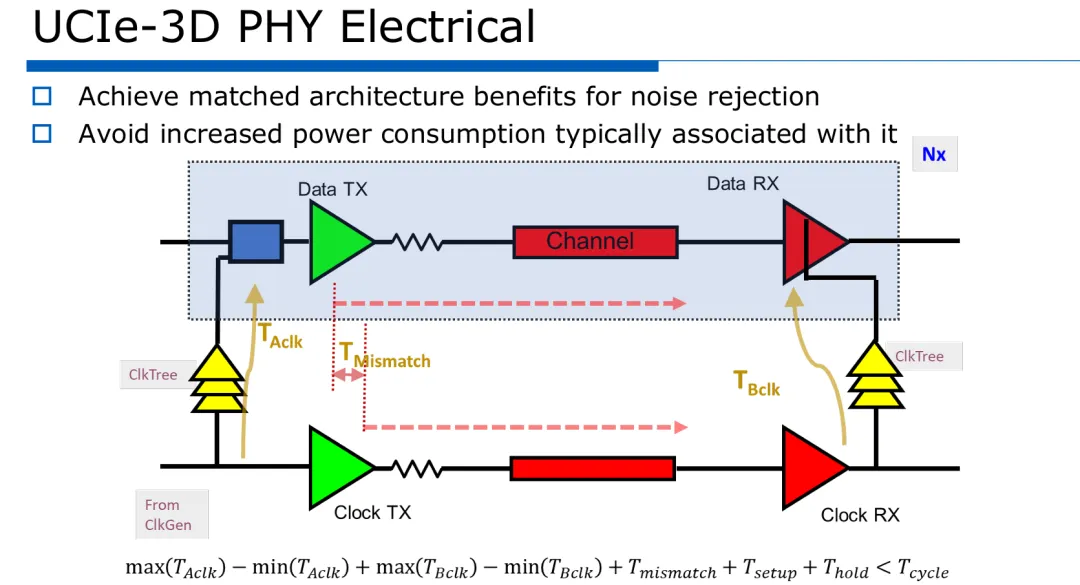
图13:UCIe-3D PHY电气设计的匹配架构方法,显示数据和时钟路径及其相关时序参数。
链路分析和错误处理
UCIe结合了复杂的链路分析和错误处理机制,确保在高数据速率下的可靠性,而无需复杂的错误纠正方案。链路分析方法同时检查典型和最差情况的病态通道,建立性能边界。
通道效应通过不同位错误率(BER)值的模拟扫描进行表征,对Q尺度(统计置信水平)上的眼宽测量进行线性回归,提取固定和分布成分。对于最差情况分析,假设最大眼闭合,没有分布,确保保守的设计裕度。
电压参考错误和输入参考噪声使用信号边缘转换率转换为时序错误,创建统一的时序预算,考虑所有潜在错误源。这种全面方法确保即使在制造和操作条件变化的情况下,链路也将在目标BER下保持可靠运行。
决策反馈均衡(DFE)错误传播的分析对高速率实现特别重要。详细的数学模型量化了当使用DFE时单个位错误如何潜在地传播到后续位。使用考虑确定性和随机噪声成分的统计方法,计算PAM-L信号的第k UI错误延伸到k+1 UI的概率。对于具有典型DFE抽头值(h1/h0比率低于0.3)的UCIe实现,随时间失效(FIT)率保持可忽略不计,确认DFE可以安全使用,而无需额外错误纠正机制。
数据和有效通道的可靠性计算表明,UCIe即使在高数据速率下也能实现极低的FIT率。对于有效通道,汉明距离4编码提供强大的错误检测能力,允许系统在检测到帧错误时重新训练链路。由CRC机制保护的数据通道在所有实际操作条件下实现远低于1的FIT率,即使考虑潜在的错误相关效应。
这些全面分析确认UCIe可以实现所需的可靠性,而无需强制复杂的前向错误纠正(FEC)系统,保持架构简单性的同时确保稳健运行。
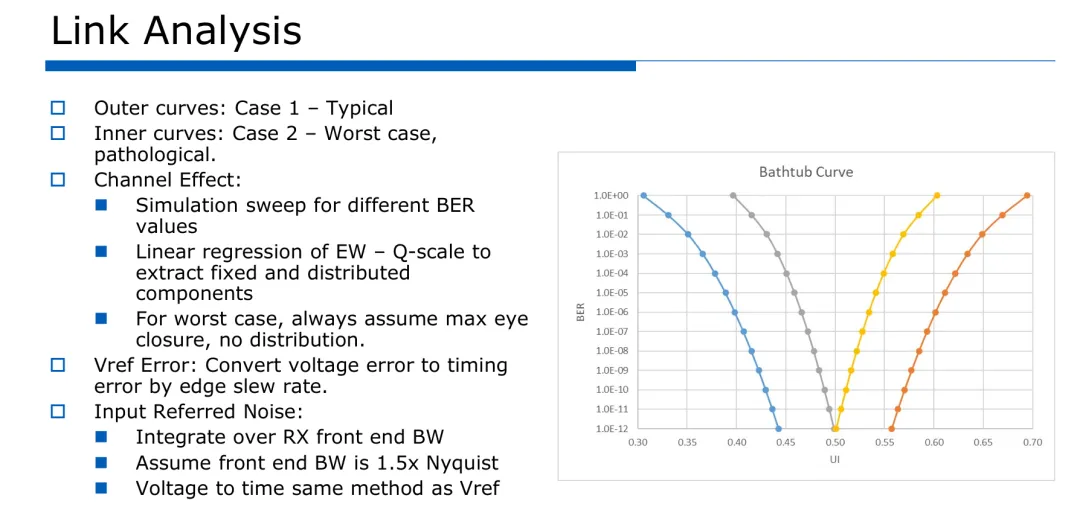
图14:此浴盆曲线图显示了不同UI(单位间隔)值的BER分析,说明UCIe链路设计中可用的时序裕度。
未来方向:扩展到更高数据速率和光学集成
UCIe继续发展,努力将数据速率提高到48和64 GT/s,同时保持与现有实现的兼容性。这些更高的数据速率面临显着的信号完整性挑战,需要增强的均衡技术,而不损害使UCIe具有吸引力的功率效率。
增强的均衡方法结合了具有前游标和后游标抽头的3抽头发送器前馈均衡(TX FFE),以补偿通道特性。UCIe规定了在链路训练期间可选择的六个预设系数组合,而非实现昂贵的自适应均衡。这种方法提供有效的通道补偿,而没有连续适应的功率和复杂性开销。
在接收器侧,一阶无源连续时间线性均衡(CTLE)线路提供额外的高频提升。CTLE通常可以与用于焊盘电容补偿的T-线圈网络结合,创建高效的双用途结构。对于最具挑战性的通道,可以实现可选的1抽头决策反馈均衡(DFE)线路,对抽头系数有仔细约束以防止错误传播问题。
这些更高速率下的时钟分配采用四分之一速率架构,允许64 GT/s链路使用可管理的16 GHz时钟运行。这种方法平衡了多相时钟生成的复杂性与跨芯片分配非常高频信号的挑战。
这些更高数据速率实现的性能预测表明,与当前32 GT/s设计相比,边缘带宽密度提高了1.7-2倍,面积带宽密度提高了1.3-1.6倍。功率效率目标仍然激进,为0.5-0.75 pJ/b,功率预算大致分为发送器40%,接收器40%,共用线路20%。
除电气互连外,UCIe非常适合与光电共封装(CPO)集成,通过光学技术实现带宽扩展,同时利用已建立的UCIe生态系统进行芯间电气连接。光学I/O提供多个扩展向量——包括波长数、线路速率、光纤数量和极化——可以结合提供随时间的显着带宽增加。标准化的UCIe电气接口为集成光引擎提供了理想基础,创建了带宽需求超出纯电气连接能力时的无缝过渡路径。
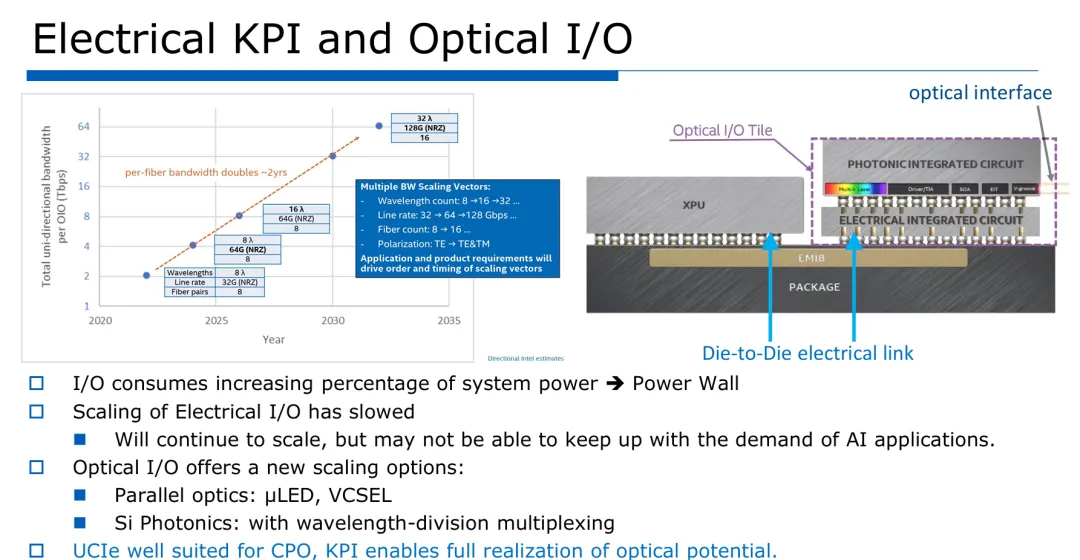
图15:此图表说明了光学I/O带宽扩展路线图,显示了波长数、线路速率和光纤数量与UCIe电气连接能力一起的发展。
总结与结论
UCIe标准为基于Chiplet的设计建立了坚实基础,并在多个维度继续发展。随着越来越多的半导体公司在其Chiplet设计中实现UCIe接口,生态系统继续通过行业采用和扩展而增长。这种增长形成良性循环,更广泛的采用导致更多互操作性选项,进一步加速行业向模块化芯片设计的过渡。
3D集成的探索代表着UCIe的新前沿,UCIe-3D规范解决了垂直连接的独特需求。这一维度的扩展在带宽密度和能源效率方面提供了显着改进,实现了仅靠传统水平互连难以实现的新系统架构。
数据速率和带宽密度继续扩展,路线图延伸到64 GT/s及以上。这些进步需要仔细权衡功率效率要求,确保互连功耗不会成为系统设计的限制因素。标准对低功耗操作和快速状态转换的重视实现了精细粒度的功率管理,提高了整体系统能源效率。
UCIe联盟拥有六个技术工作组(电气、协议、形状因素与合规性、可管理性与安全、系统与软件,以及汽车和市场营销组),致力于推进该标准。这些工作组确保标准发展时保持向后兼容性,使UCIe技术投资在添加新功能时受到保护。同时支持新的使用模型,增强成本优化策略,并建立强大的合规框架,确保整个生态系统的互操作性。
随着半导体行业继续向分解、异构设计转变,UCIe提供了芯间通信的标准化方法,平衡了性能、功率效率和实现灵活性。这一基础使不同供应商的专用Chiplet可以无缝协同工作的开放生态系统成为可能,超越单片设计限制,释放系统架构和性能扩展的新可能性。
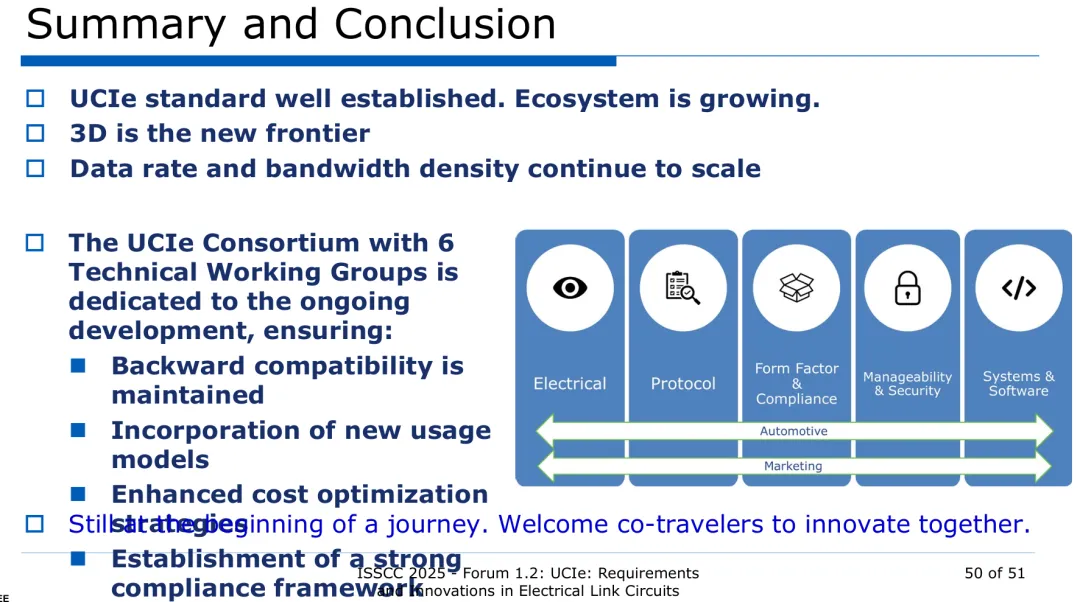
图16:UCIe联盟结构,包括六个技术工作组(电气、协议、形状因素与合规性、可管理性与安全、系统与软件)以及汽车和市场营销组。
参考文献
[1] Z. Wu, "UCIe: Requirements and Innovations in Electrical Link Circuits," presented at the International Solid-State Circuits Conference (ISSCC) 2025 Forums, IEEE, 2025.
END
 微信公众号
 bilibili
 微信视频号