


引言
半导体行业正经历数据处理需求的快速增长,需要创新的芯片设计和集成方法。芯片间(Die-to-Die,D2D)互连技术已成为解决这些挑战的关键解决方案,通过将传统的片上系统(SoC)设计分解为更灵活、更高效的封装内系统(SiP)实现。本文探讨高带宽、高能效芯片间互连技术的关键方面,重点关注通用Chiplet互连标准(Universal Chiplet Interconnect Express,UCIe)技术。
指数增长时代
我们正处于数据处理需求真正的"指数增长时代"。行业趋势显示各种标准的数据传输速率显著增加。如图1所示,自2000年以来,PCIe、SATA、DDR、GDDR等协议的每通道传输速率呈指数级增长。最引人注目的是,CEI等标准在2024年达到的速率接近每通道256 Gb/s。
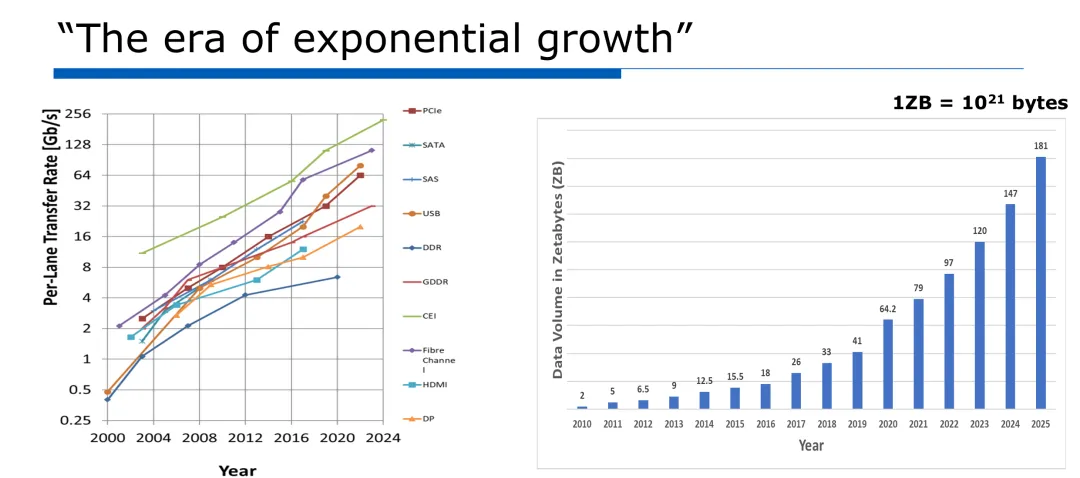
图1:展示2000年至2024年不同标准每通道增长率的图表,CEI达到接近256 Gb/s的最高速度
这种增长与全球数据量的爆炸性增长直接相关,预计到2025年将达到惊人的181泽字节(10^21字节)。这比2010年的仅2泽字节增长了近百倍,展示了推动更快、更高效互连技术需求的持续数据增长速度。
从SoC分解到SiP
先进计算中最重要的架构转变之一是从单片片上系统(SoC)设计向分解式封装内系统(SiP)实现的转变。这种方法提供了许多优势,包括改善良率、优化工艺和增强可扩展性。
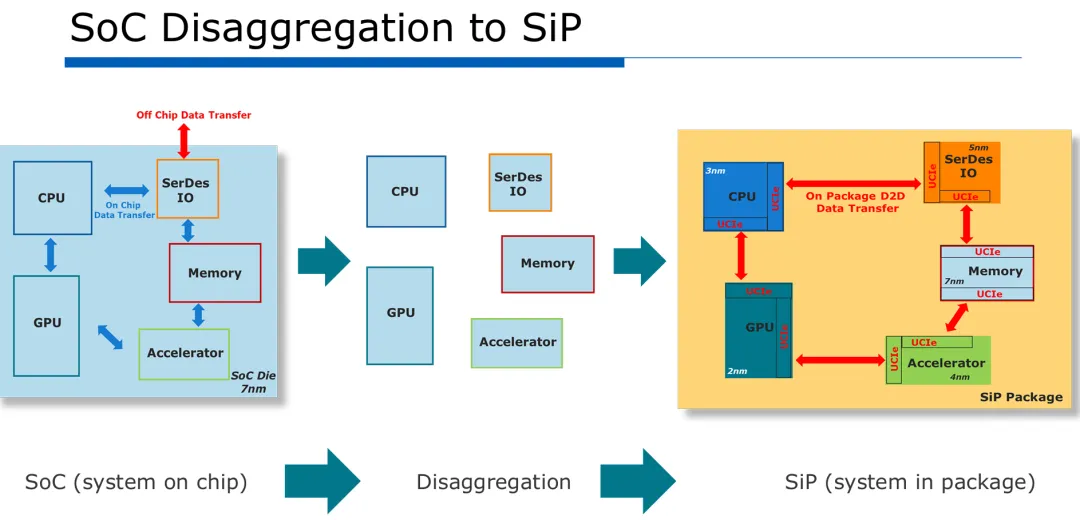
图2:展示从SoC到通过D2D链路连接的多个Chiplet的分解式SiP设计演变的图表
如图2所示,传统SoC设计将CPU、GPU、内存、加速器和SerDes I/O组件集成在使用相同工艺节点(如7nm)的单个芯片上。分解方法将这些组件分离,允许每个组件使用最合适的工艺技术制造:CPU使用3nm,GPU使用2nm,内存使用7nm,加速器使用4nm,SerDes I/O使用5nm。这些独立芯片然后通过高速、低延迟的UCIe链路在单个封装内连接。
这种异构集成策略通过为每个组件使用最合适的工艺节点来优化成本、性能和能效,同时保持紧密连接组件的带宽和延迟优势。
D2D标准化
芯片间互连领域从专有解决方案演变为标准化方法,UCIe成为领先标准。如图3所示,行业最初依赖Cadence的Ultralink、Nvidia的NVLink和Blue Cheetah的Blue Lynx等专有技术。
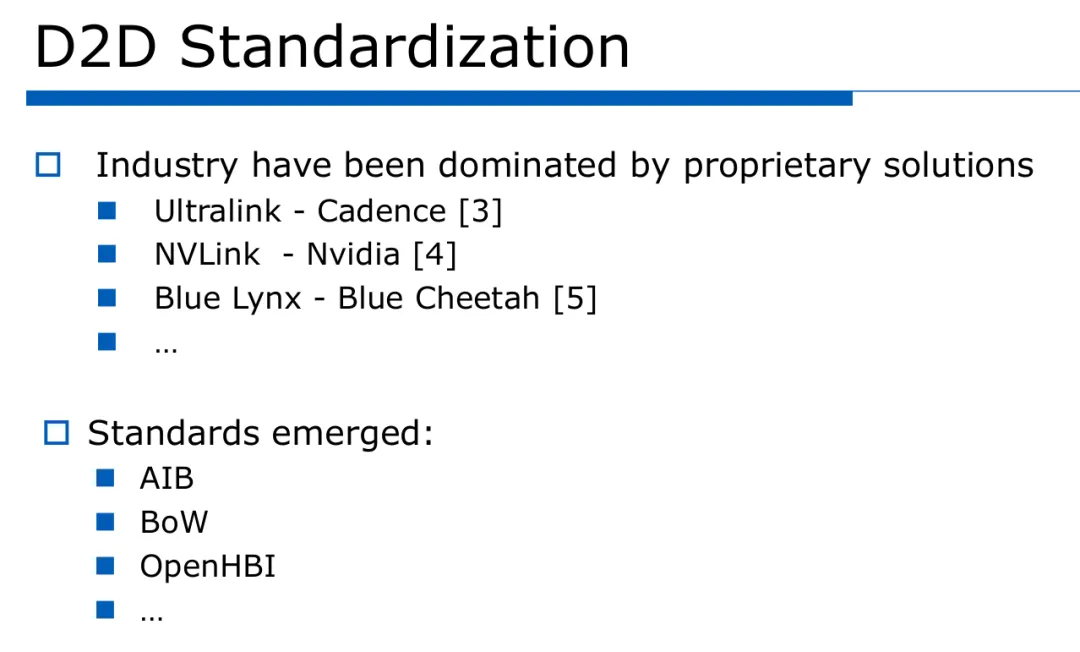
图3:行业专有解决方案和新兴标准(包括UCIe)列表
然而,互操作性和生态系统发展的需求推动了AIB、BoW、OpenHBI等标准的出现,其中UCIe最为突出。通用Chiplet互连标准(UCIe)代表了行业协作努力,建立芯片间连接的通用规范,促进基于Chiplet设计的广泛采用。
UCIe性能目标和架构
UCIe定义了两种具有不同性能目标的封装:高级封装(Advanced Package,AP)和标准封装(Standard Package,SP)。图4概述了关键性能规范,强调了这些方法之间的显著差异。
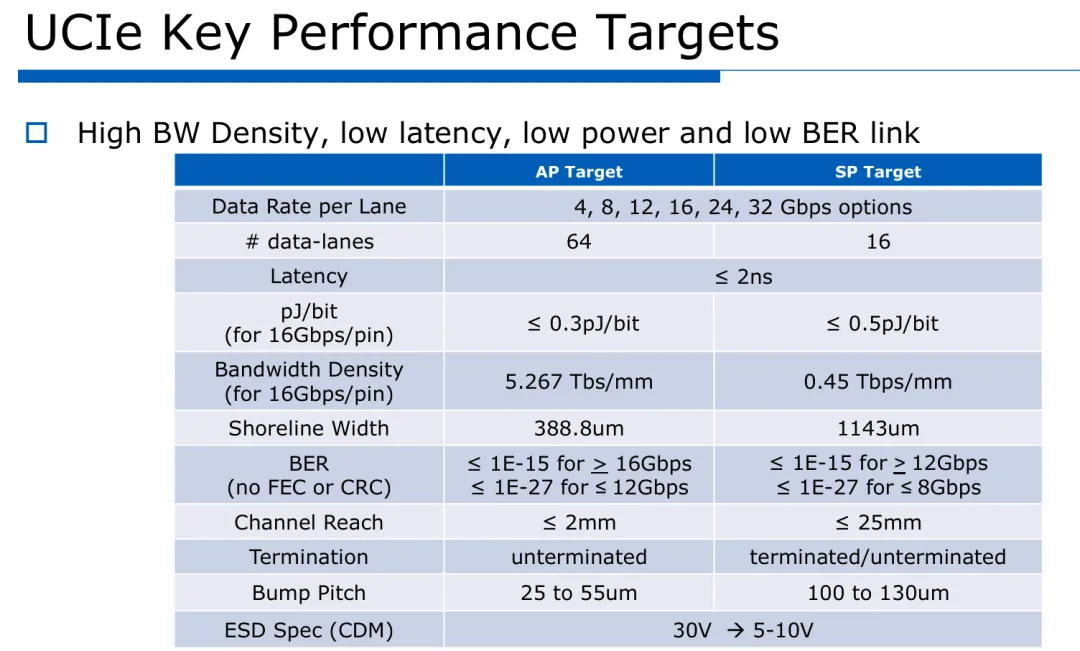
图4:比较AP和SP UCIe目标的表格,包括数据速率、通道数量、延迟、能效、带宽密度等规范
高级封装(AP)设计目标是极高带宽密度(5.267 Tbps/mm),具有64个数据通道和超低功耗(16Gbps时≤0.3pJ/bit)。这些实现使用小间距凸点(25-55μm)且无终端匹配。相比之下,标准封装(SP)设计提供更适中的带宽密度(0.45 Tbps/mm),16个数据通道和略高功耗(≤0.5pJ/bit)。SP实现使用更大间距凸点(100-130μm),可以选择有终端匹配或无终端匹配。
AP和SP解决方案都支持每通道4至32 Gbps的数据速率,并保持极低延迟(≤2ns),这对于分解设计中维持性能至关重要。两者还在不需要前向错误纠正(FEC)或循环冗余校验(CRC)的情况下实现了令人印象深刻的位错误率(BER)。
UCIe架构要点和挑战
UCIe标准做出了特定的架构选择,平衡性能、能效和实现复杂性。图5详细说明了这些架构决策及其优势和挑战。
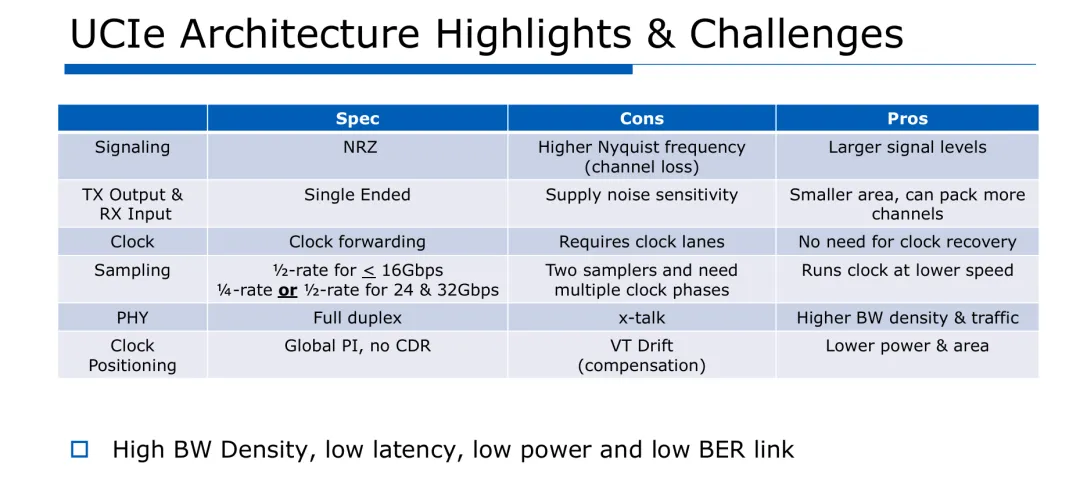
图5:展示UCIe架构规范及其在信号传输、发送/接收接口、时钟、采样率等参数方面的挑战和优势的表格
UCIe采用NRZ(非归零)信号传输,提供更大信号电平,但面临更高奈奎斯特频率要求和通道损耗挑战。采用单端发送输出和接收输入,实现更高通道密度,但增加了对电源噪声的敏感性。时钟前向传输消除了复杂时钟恢复线路的需求,但需要专用时钟通道。
对于高速操作(24和32 Gbps),UCIe支持四分频和二分频采样方法。虽然这需要多个采样器和时钟相位,但允许时钟以较低速度运行。该架构还实现全双工通信以最大化带宽密度,并使用没有时钟数据恢复(CDR)的全局相位插值来减少功耗和面积需求。
链路性能挑战和亮点
实现UCIe链路面临几个关键挑战,必须解决这些挑战才能达到所需性能目标。如图6所详述,这些挑战涵盖带宽密度、延迟、位错误率、能效和物理约束。
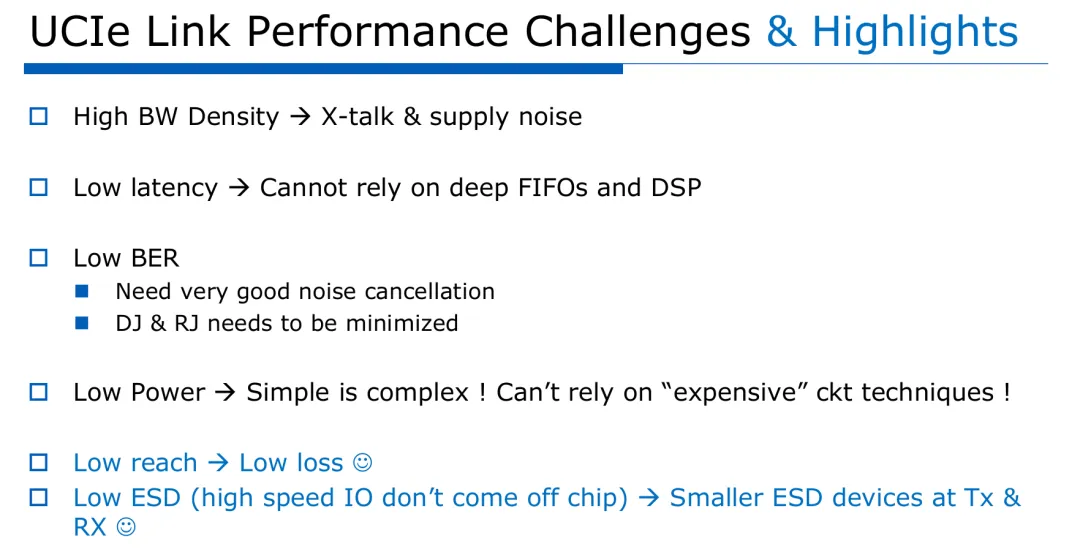
图6:UCIe链路性能挑战和亮点概述,包括带宽密度、延迟、BER、功耗和物理约束
高带宽密度带来显著的串扰和电源噪声挑战。严格的低延迟要求(≤2ns)阻止使用深FIFO和复杂数字信号处理技术,这些技术常用于更长距离标准。实现规定的低位错误率需要优秀的噪声消除和最小化确定性和随机抖动。
能效目标迫使设计者接受"简单即复杂"的原则—避免使用耗电线路技术,同时仍满足性能要求。减少物理距离(AP≤2mm,SP≤25mm)通过限制通道损耗提供帮助,而高速I/O不离开封装的较低ESD要求允许在发送器和接收器使用更小的ESD保护器件。
UCIe的封装设计
成功实现UCIe需要精心封装设计,以满足信号完整性(SI)和电源完整性(PI)规范。图7概述了UCIe规范定义的关键封装要求。
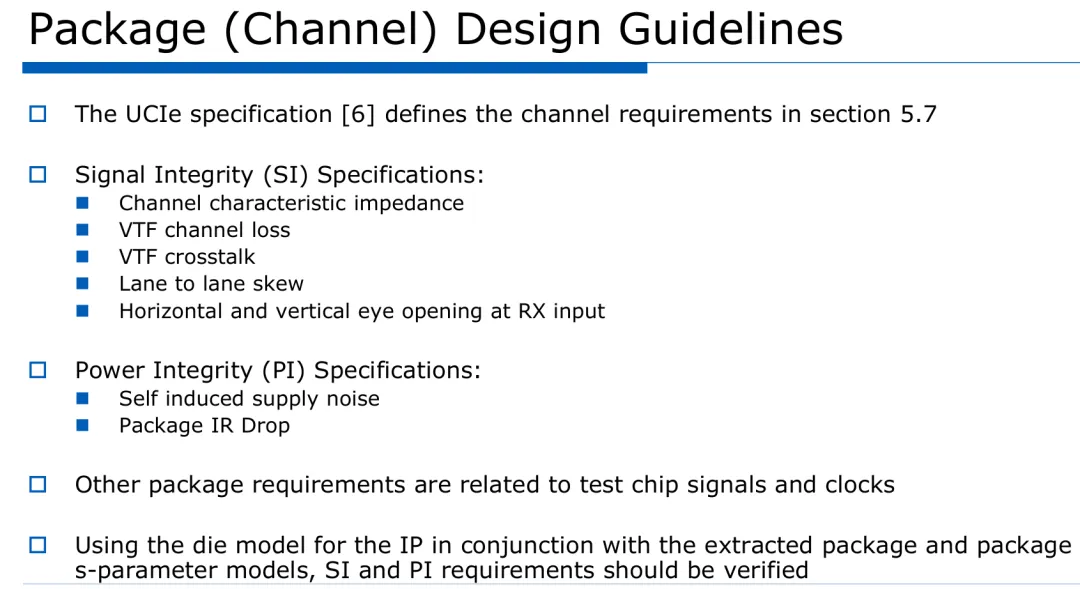
图7:UCIe实现的封装设计指南和要求,包括SI和PI规范
信号完整性规范包括通道特性阻抗、电压传递函数(VTF)通道损耗、VTF串扰、通道间偏差,以及接收器输入处的水平和垂直眼图开口要求。电源完整性规范涉及自感应电源噪声和封装IR压降。
设计过程通常涉及使用从封装设计提取的s参数模型进行迭代仿真和优化。图8和9说明了高级封装实现的信号完整性和电源完整性设计流程,强调了满足UCIe规范的迭代优化过程。
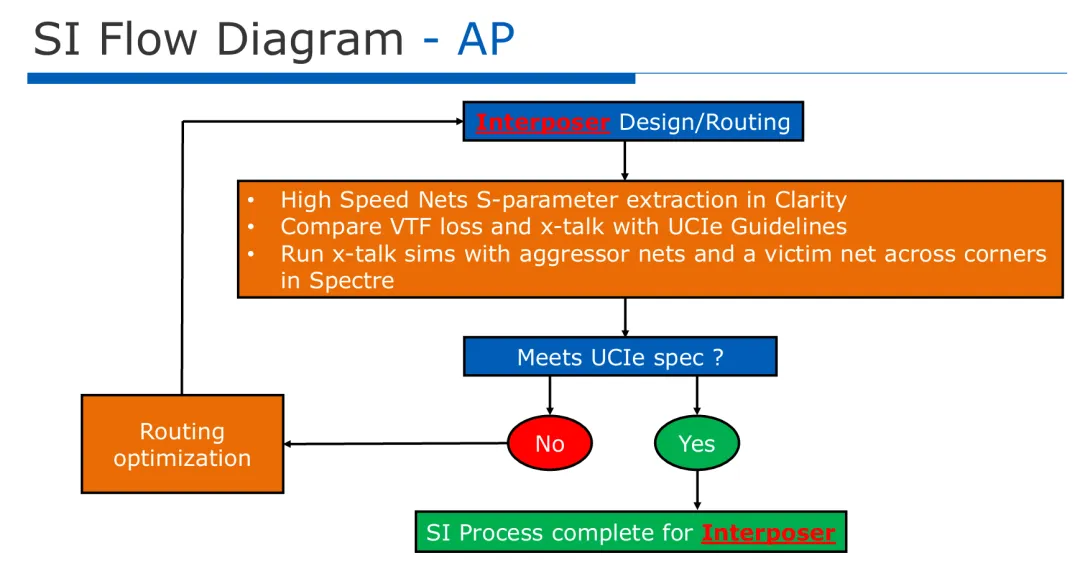
图8:AP的SI流程图,显示中间层设计/布线、S参数提取和验证UCIe规范的过程

图9:AP的PI流程图,显示中间层PI和组合中间层与封装PI分析的两步过程
通道性能分析
通道性能分析对确保实现满足UCIe规范至关重要。图10和11显示了AP和SP实现在各种通道长度上的VTF损耗和VTF串扰测量结果。
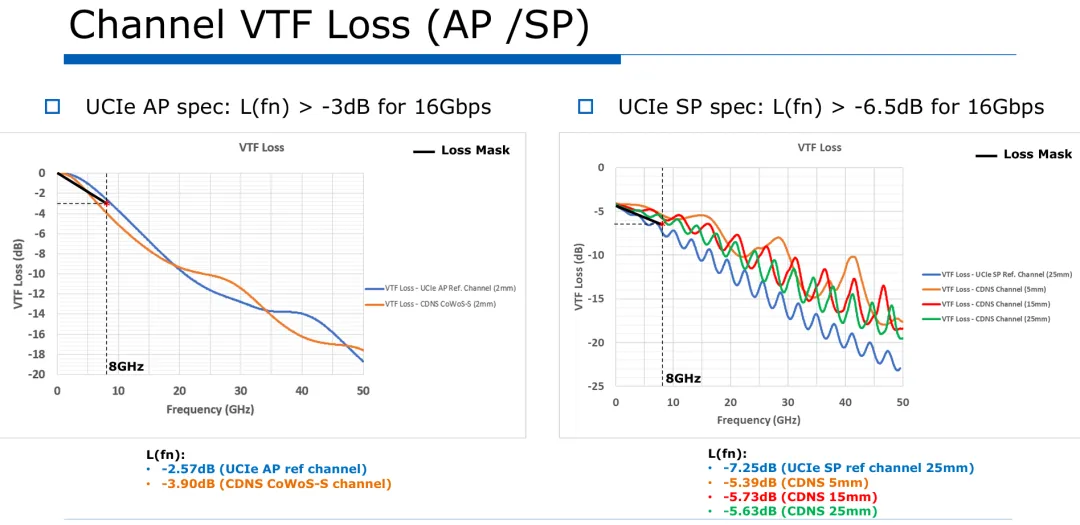
图10:比较AP和SP实现VTF损耗与UCIe规范的图表
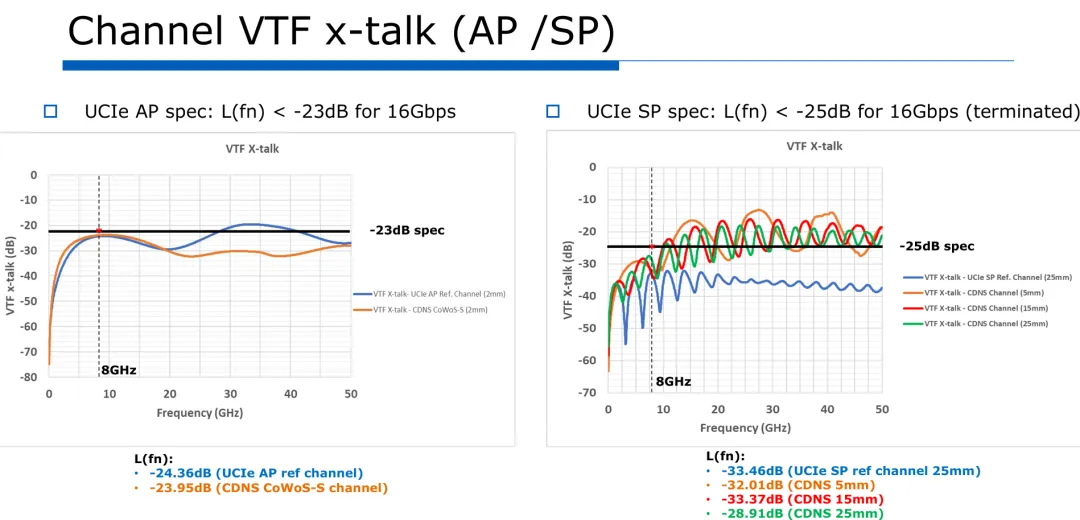
图11:比较AP和SP实现VTF串扰与UCIe规范的图表
对于AP实现,16Gbps时测量的VTF损耗为Cadence CoWoS-S通道的-3.90dB,与UCIe参考通道值-2.57dB相比。16Gbps时测量的VTF串扰为-23.95dB,满足小于-23dB的规范。
对于SP实现,16Gbps时测量的VTF损耗从5mm通道的-5.39dB到15mm通道的-5.73dB,以及25mm通道的-5.63dB,均满足大于-6.5dB的规范。16Gbps时测量的VTF串扰范围从-32.01dB到-33.37dB,轻松满足终端匹配实现小于-25dB的规范。
Cadence UCIe收发器架构
Cadence UCIe收发器实现提供了满足所有UCIe规范并实现卓越能效的完整解决方案。图12说明了Cadence UCIe SP实现的顶层架构。
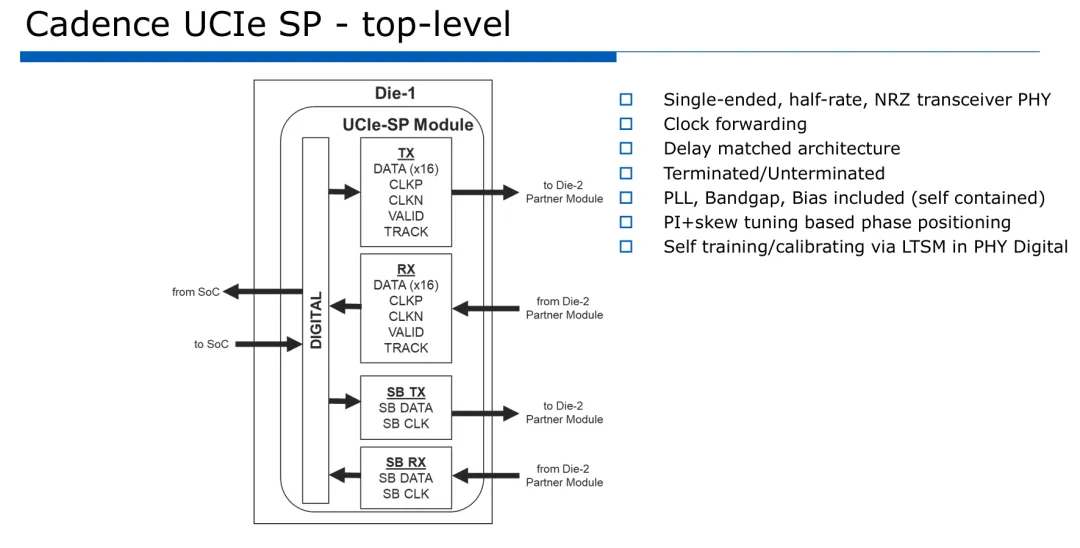
图12:Cadence UCIe SP收发器框图,显示TX、RX和数字组件
该设计特点是单端、半速率、NRZ收发器PHY,带时钟前向传输。采用延迟匹配架构,支持终端匹配和无终端匹配操作。收发器集成PLL、带隙和偏置电路,创建自包含解决方案。相位定位通过相位插值和偏移调整实现,训练和校准通过链路训练状态机(LTSM)由PHY数字逻辑处理。
图13显示UCIe SP设计的顶层实现和凸点图,突出显示130μm凸点间距以及TX、RX、电源/地、数字和侧带接口的组织。
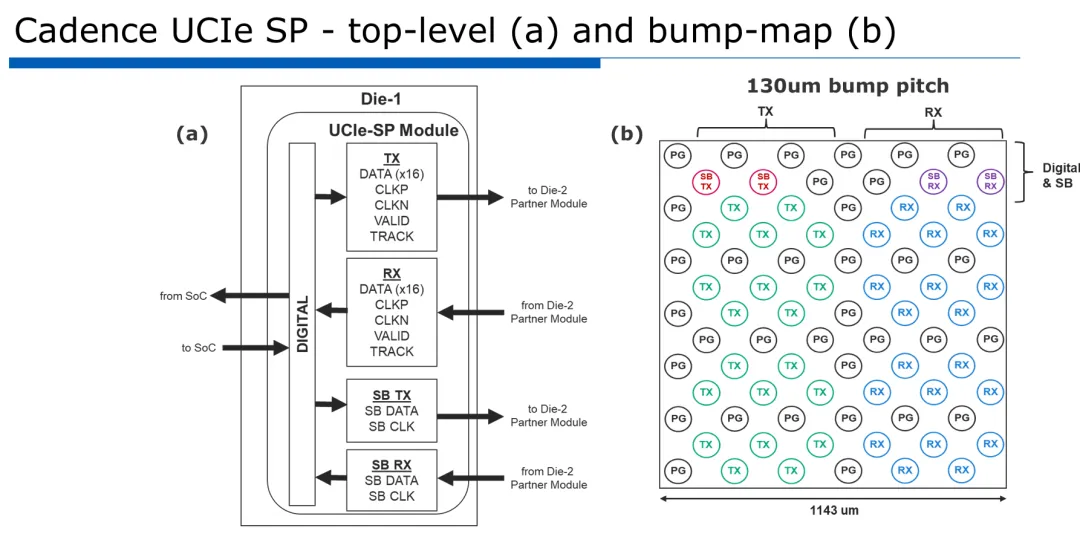
图13:Cadence UCIe SP实现的顶层图和凸点图,显示TX、RX、PG和数字组件的排列
发送器和接收器设计
发送器(TX)和接收器(RX)设计对满足UCIe性能目标至关重要。图14显示TX通道实现,具有8:2串行化、占空比失真(DCD)检测和校正,以及去偏移能力。
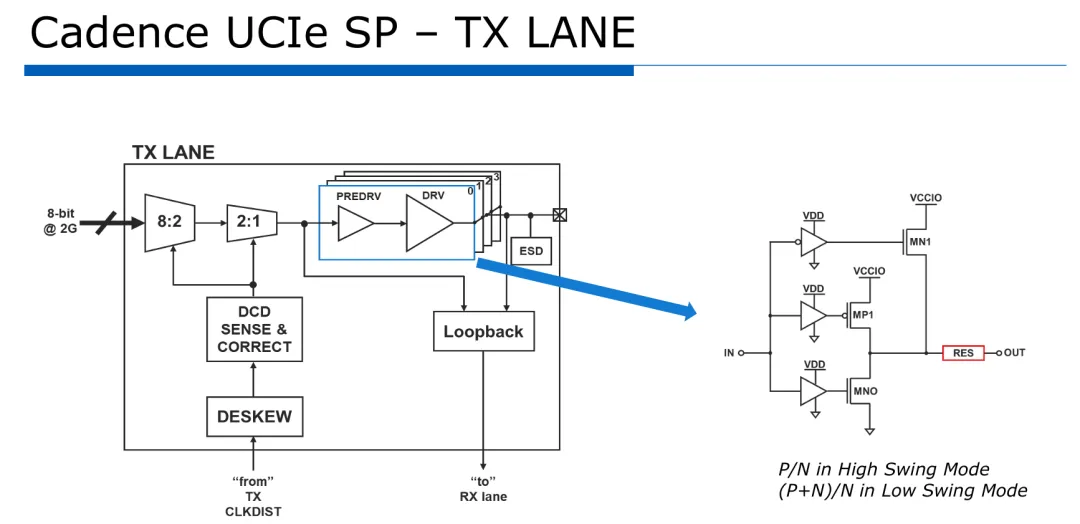
图14:UCIe SP TX通道框图,显示串行化、DCD校正和输出级
发送器输出驱动器支持使用P/N操作的高摆幅模式和使用(P+N)/N操作的低摆幅模式,为不同通道特性优化信号幅度和功耗。
图15说明接收器(RX)架构,实现半速率设计,具有延迟匹配、单通道去偏移、单相CMOS时钟分配和全局DCD校正。
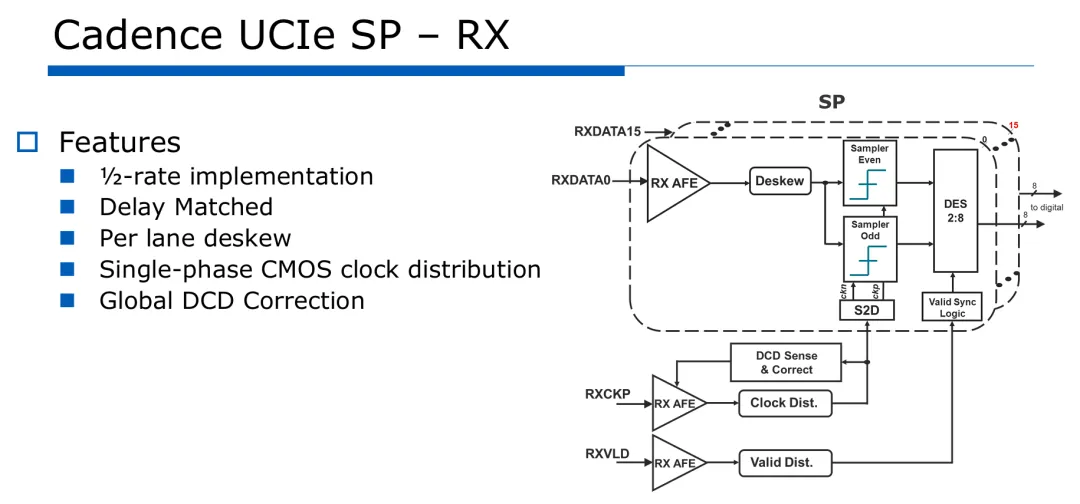
图15:UCIe SP RX框图,显示模拟前端、去偏移、采样器和解串器级
图16详细描述的接收器模拟前端(AFE)使用乒乓架构,通过两组采样器实现时间交错操作的功耗节省,同时保持所需灵敏度和带宽。
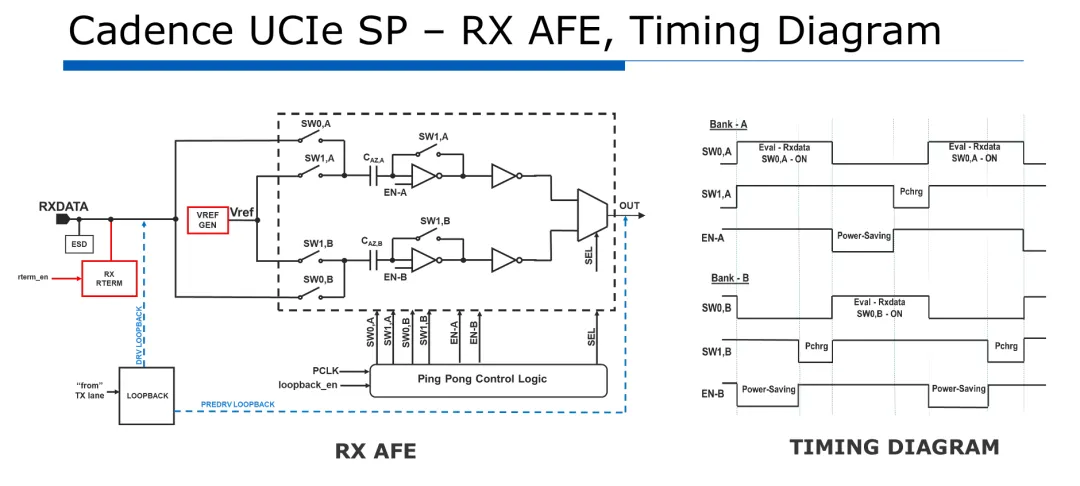
图16:接收器模拟前端详细电路图及其显示乒乓操作的时序图
测量结果
硅片测量展示了Cadence UCIe实现的卓越性能。在不同数据速率和通道长度下捕获了所有通道的眼图。图17-18显示16个通道在5mm、15mm和25mm通道上以16Gbps运行的眼图。
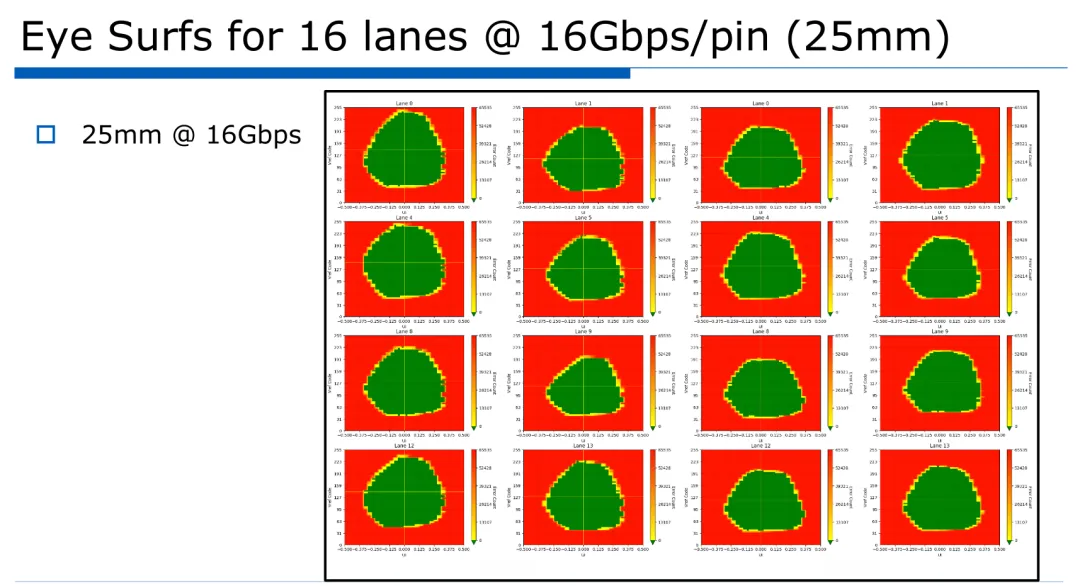
图17:16个通道在25mm通道上以16Gbps运行的眼图,显示优秀眼图开口
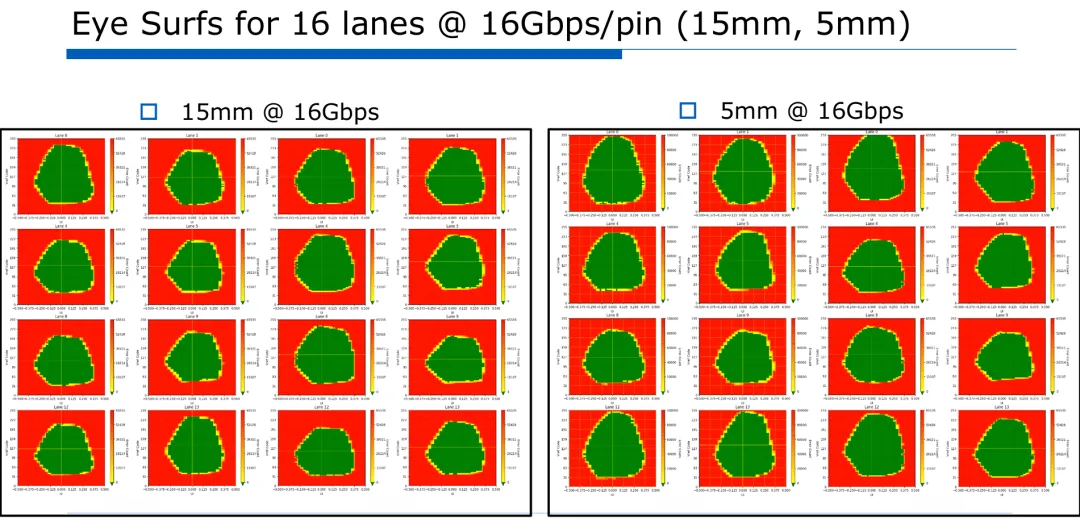
图18:16个通道在15mm和5mm通道上以16Gbps运行的眼图
图19所示的位错误率(BER)测量确认实现满足BER < 1E-15的UCIe规范。16Gbps操作时,BER=1E-15的水平裕度测量为0.38UI,垂直裕度为230mV。
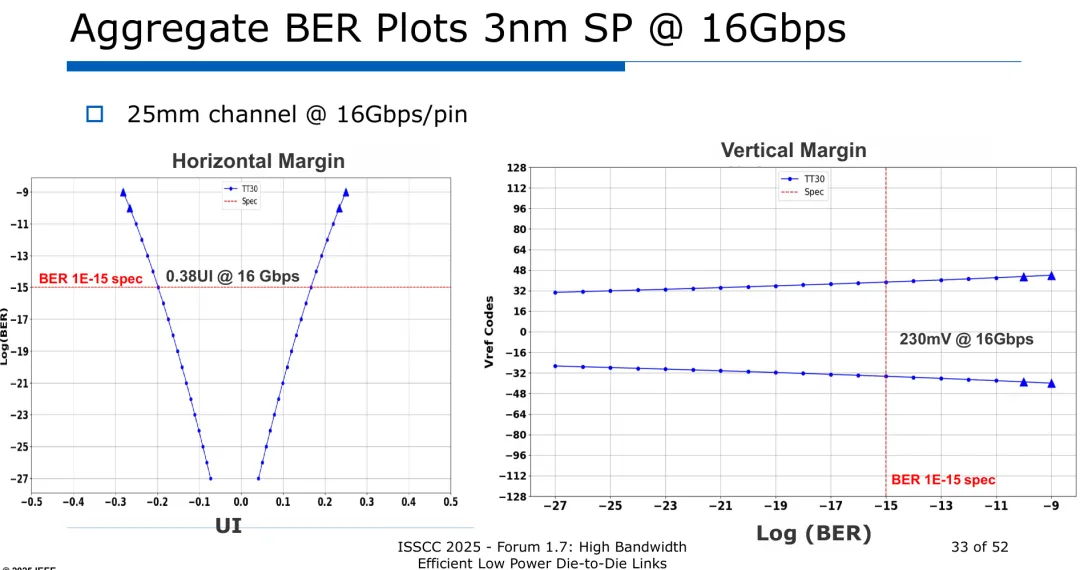
图19:显示16Gbps时水平和垂直裕度超过UCIe规范的BER图
该设计通过运行时重校准展示了优秀的VT漂移补偿,如图20所示。在电压变化(±5%)和温度变化(-40°C至125°C)下的测量表明,维护模式在极端条件下有效保持眼图宽度。
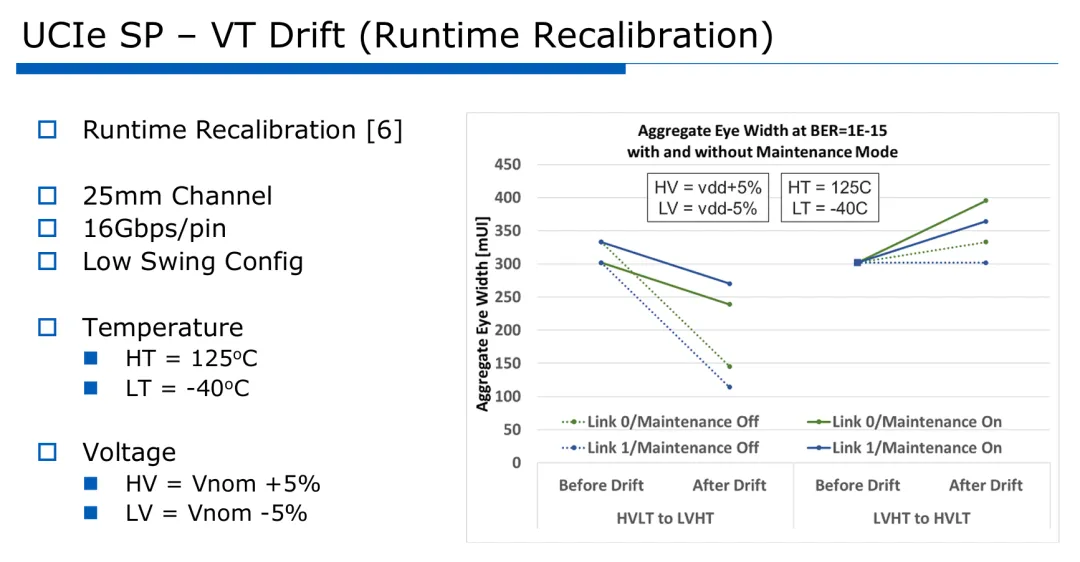
图20:在电压变化(±5%)和温度变化(-40°C至125°C)下的测量。
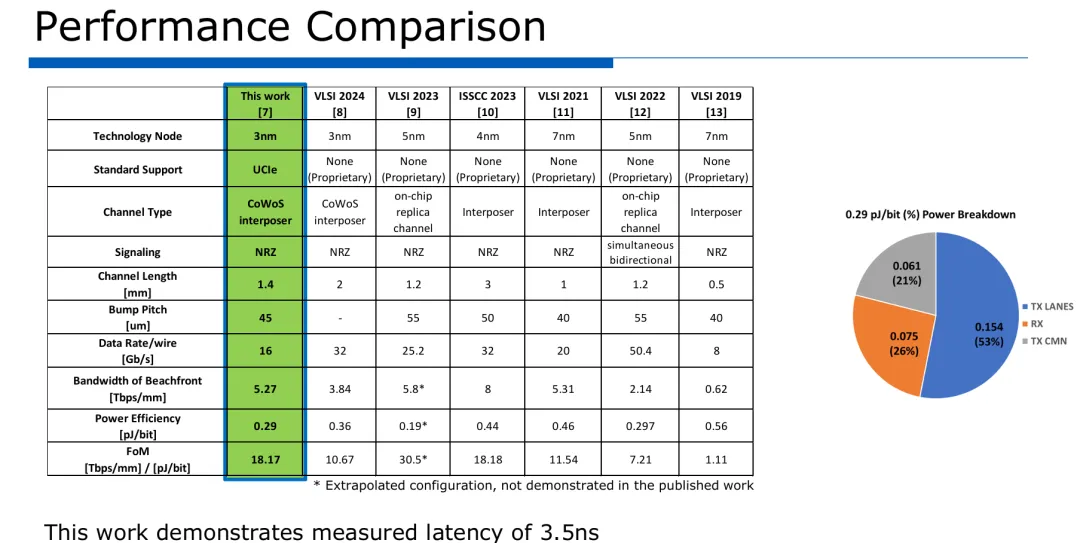
图21:显示Cadence实现与其他已发表D2D链路比较的性能表
与其他已发表设计相比,性能表现优秀,实现0.29 pJ/bit的能效和5.27 Tbps/mm的带宽密度。计算为[Tbps/mm]/[pJ/bit]的性能指标(FoM)为18.17,是文献中报道的最佳性能之一。
未来方向:32G和64G UCIe
展望未来,UCIe正在发展以支持更高数据速率。图22说明32Gbps UCIe架构,在发送器和接收器路径中添加均衡,以补偿高频下增加的通道损耗。
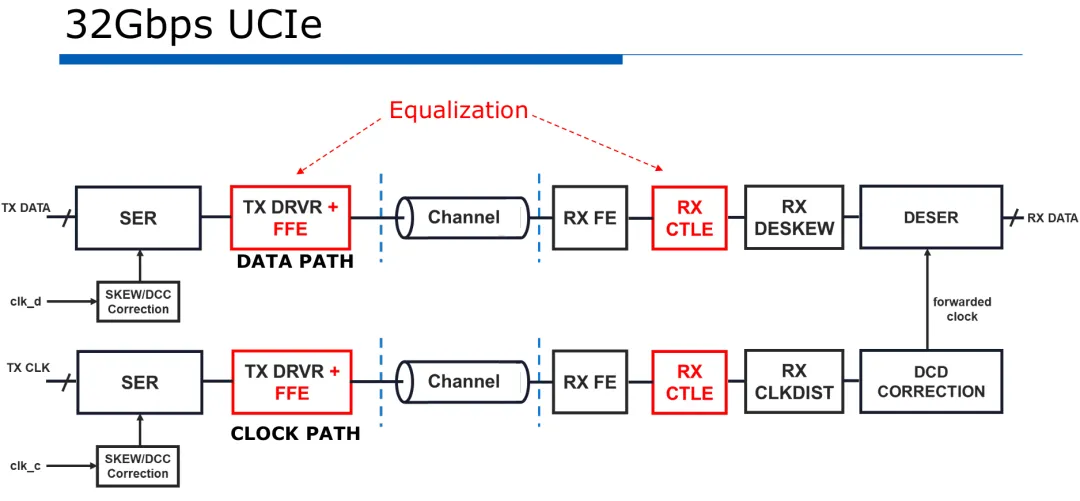
图22:32Gbps UCIe框图,显示TX和RX路径中添加的均衡阶段
对于32Gbps及以上数据速率,UCIe面临图23概述的几个挑战,包括更高通道损耗、更严格时序裕度、更复杂时钟要求以及需要更复杂均衡技术。
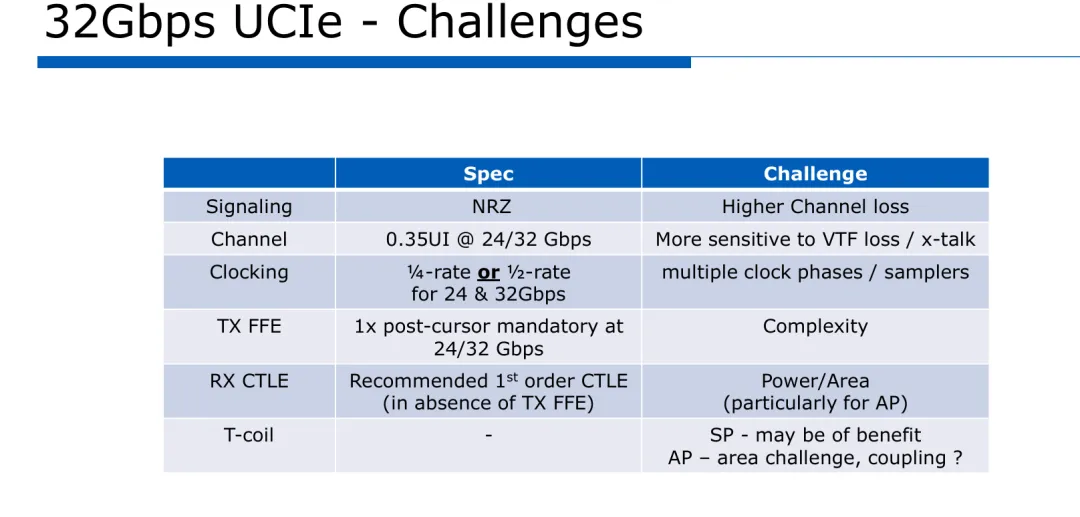
图23:32Gbps UCIe操作在信号传输、通道、时钟和均衡领域面临的挑战表
结论
使用UCIe标准的芯片间链路代表Chiplet集成技术的重大进步。Cadence UCIe实现证明带宽密度、能效和位错误率的性能目标可在硅片上实现。
如图24所总结,UCIe性能挑战已通过精心封装设计、优化收发器架构和全面验证得到解决。展望未来,向32Gbps乃至64Gbps的演进将需要均衡、信号传输和线路设计方面的额外创新。
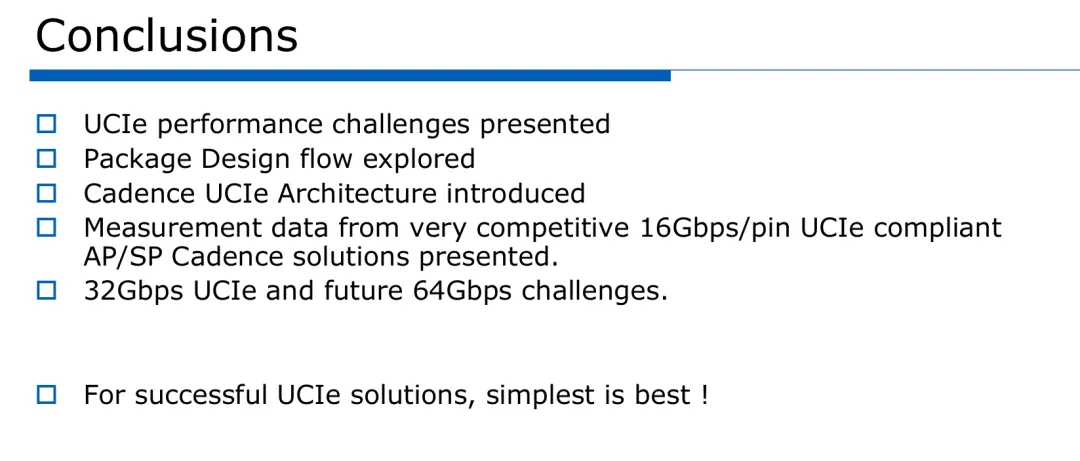
图24:结论突出UCIe实现的关键成就和未来挑战
"最简为最佳"原则对成功UCIe实现特别有价值,因为不必要复杂的解决方案常导致功耗、面积和可靠性问题。通过保持这种优雅简洁性的关注,同时解决不断增加的性能要求,UCIe将继续支持Chiplet革命,为下一代计算架构提供基础。
参考文献
[1] K. Geary, "High Bandwidth Efficient Low Power Die-to-Die Links," in International Solid-State Circuits Conference (ISSCC), 2025, pp. 1-52.
END
 微信公众号
 bilibili
 微信视频号