


引言
半导体行业已经发展超越传统CMOS缩放,拥抱异构集成作为克服现代电子系统挑战的关键解决方案。本文提供了先进封装技术的全面概述,从单片二维集成到复杂的三维异构集成方法[1]。

CMOS技术的演进
半导体行业历来遵循摩尔定律,通过持续缩小晶体管尺寸实现计算能力的指数级增长。自1990年代以来,CMOS技术经历了显著的变革。铜制后端互连替代了铝,提供更低的电阻和更好的抗电迁移特性。应变硅提高了载流子迁移率,而高k介电材料与金属栅极减少了栅极氧化物变薄时的漏电流。2010年左右从平面晶体管向鳍式场效应晶体管(FinFET)的转变提供了更好的静电控制,最近,纳米片晶体管已成为下一代技术演进。
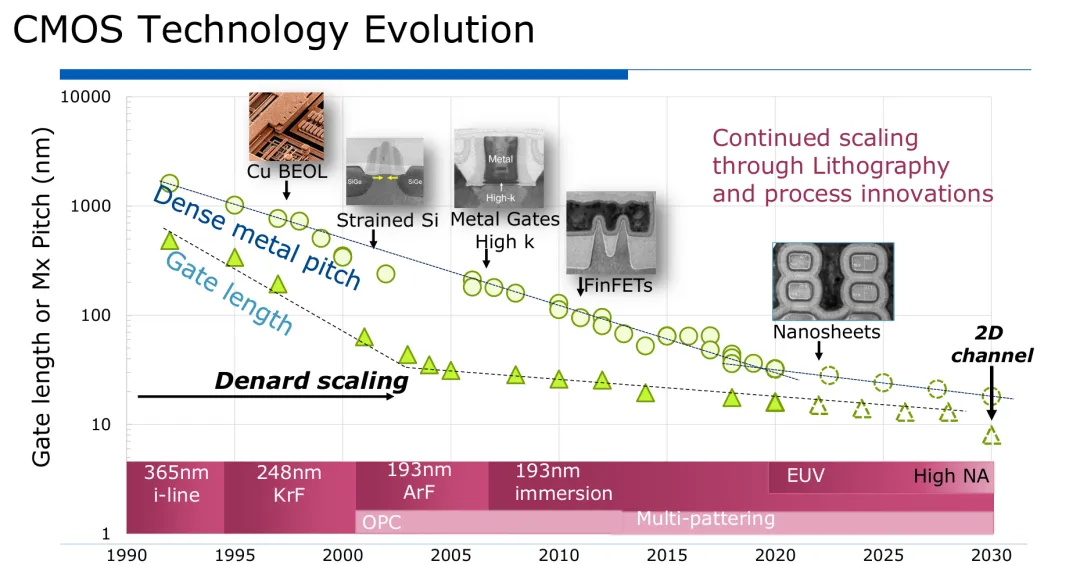
图1:从1990年到2030年CMOS技术演进,展示了栅极长度和金属间距缩放趋势,说明了各种工艺创新和光刻技术的发展。
制造技术相应地通过日益复杂的光刻技术发展。从365nm i线光刻开始,行业发展到248nm KrF和193nm ArF准分子激光技术。光学邻近效应校正(OPC)技术和多重曝光方法扩展了193nm浸没式光刻的能力,直到极紫外光(EUV)光刻以13.5nm波长彻底革新了先进工艺节点的制造格局。高数值孔径(High NA)EUV系统现在有望在本十年末进一步推动技术缩放。
然而,尽管晶体管缩放持续进行,高性能微处理器数据显示出显著的挑战。虽然晶体管数量继续呈指数增长(在五十年内从数千增至数十亿),但单线程性能增长自2005年以来已明显放缓。最大时钟频率在3-4 GHz左右趋于平稳,需要多核设计等架构创新。功耗同样在100-150瓦左右饱和,受传统封装中热散发能力的限制。这创造了"功耗墙"——一个限制进一步性能缩放的基本热限制。
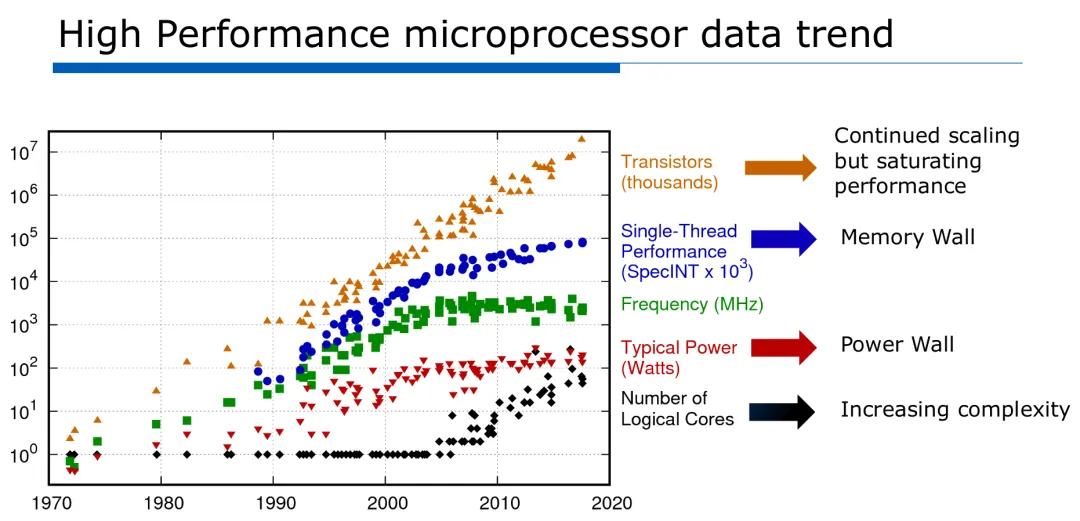
图2:高性能微处理器数据趋势,展示从1970年到2020年晶体管数量、单线程性能、频率、功耗和逻辑核心数量。
数据访问限制,即所谓的"内存墙",进一步限制了系统性能,因为内存带宽和延迟改进未能跟上处理能力增长的步伐。同时,设计复杂性急剧上升,逻辑核心从个位数增长到现代SoC中的几十个甚至上百个,在互连、验证和设计成本方面带来挑战。
异构集成:前进方向
为解决这些基本挑战,半导体行业正转向异构集成方法。与单纯依赖单片缩放不同,异构集成结合了针对特定功能优化的多样化组件,即使单个技术缩放放缓,也能实现系统级性能的持续提升。
主要技术解决方案包括开发多芯片异构集成技术,允许在单个封装中结合不同技术;创建功能性SoC系统分区方法,优化组件布局和互连;实现高密度三维互连技术,最小化分区组件之间的通信延迟。
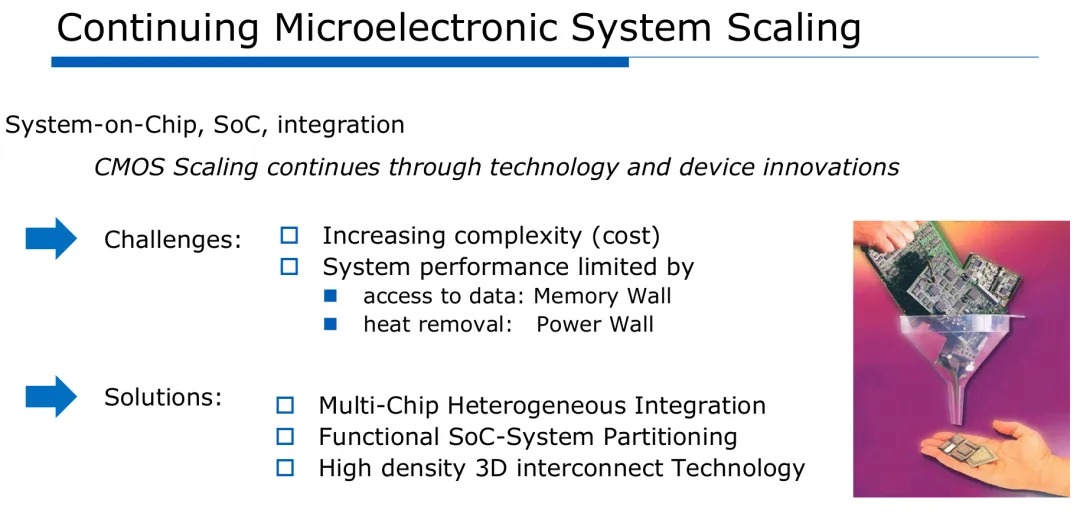
图3:微电子系统缩放延续的概念,包括异构集成面临的挑战和解决方案。
这些解决方案的实施需要远超传统键合方法的先进封装技术。硅中介层提供微米级特征的高密度水平互连,而垂直互连从焊料微凸点发展到混合键合技术,实现亚微米间距的连接。这些先进互连技术是实现异构集成革命的基础。
三维集成应用驱动因素
传统三维集成由特定高价值应用驱动。CMOS图像传感器代表最早的商业应用之一,其中感应光电二极管阵列与信号处理电路分离。这项技术继续发展,复杂度增加,涉及两层以上结构,朝着面阵感应架构发展。新颖应用包括用于增强现实显示的微型LED集成,其中发射器阵列与驱动电路垂直堆叠。
高带宽存储器(HBM)堆栈已成为高性能计算和AI应用的关键技术。这些堆栈从早期四颗芯片配置发展到当前包含8、12甚至16颗存储芯片垂直堆叠的实现。带宽相应增加,超过每秒1太字节,单个I/O通道运行速度超过8 Gbps。这些存储堆栈通常在现代服务器和AI加速器设计中与高性能逻辑SoC集成在硅中介层上。
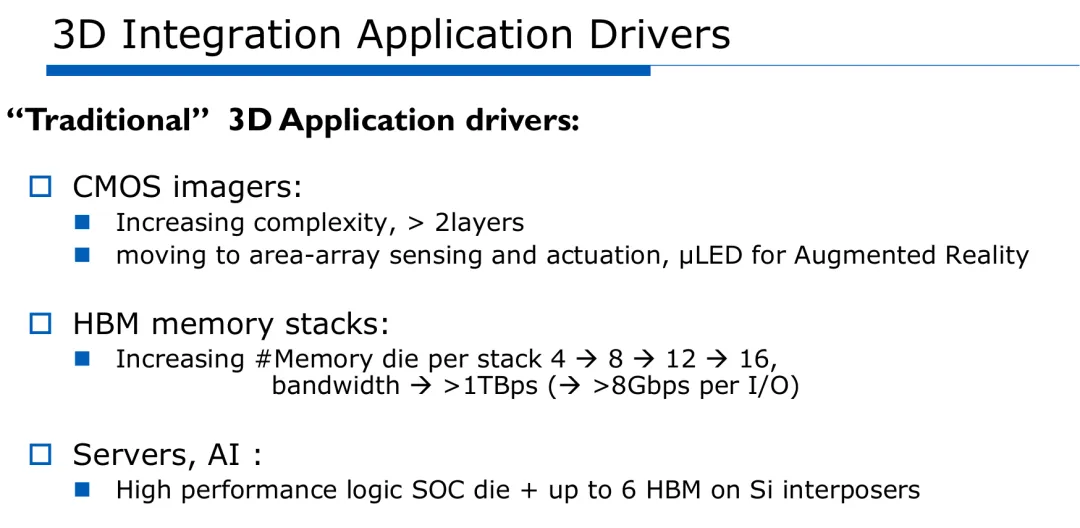
图4:展示传统三维应用驱动因素,包括CMOS图像传感器、HBM存储堆栈以及服务器/AI应用。
新兴应用显著扩展了三维集成的范围。Chiplet方法通过使用标准化总线接口如高级接口总线(AIB)、线束(BOW)或通用Chiplet互连快车(UCIe)实现多芯片互连。这些接口通常需要低于4μm的互连间距才能达到必要的带宽密度。
SoC重分区代表另一个前沿领域,之前单片集成的组件被分为优化的三维堆叠分区。一个突出的例子是芯片到晶圆(D2W)L3缓存三维堆叠,其中大型存储阵列放置在单独的芯片中,并垂直连接到处理器逻辑。存储重分区进一步扩展了这一概念,采用晶圆到晶圆(W2W)混合键合技术,将3D-NAND阵列直接键合到逻辑晶圆上。
背面电源分配网络(PDN)代表了为密集逻辑电路供电的革命性方法。通过晶圆键合和背面互连技术将电源分配移到晶圆背面,减少了活动前端的布线拥塞,在标准单元级别实现了改善的电源完整性和信号布线密度。
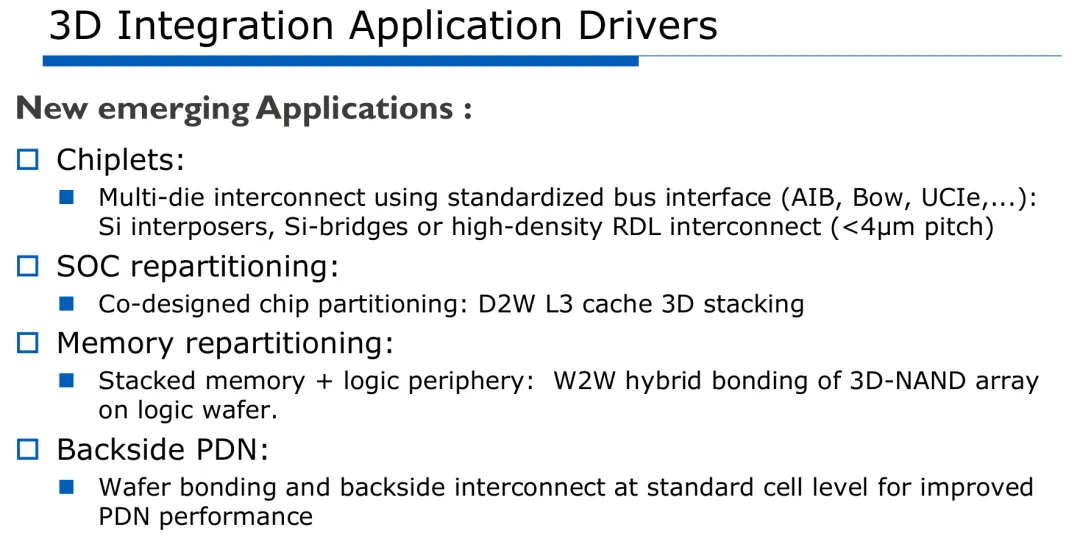
图5:三维集成的新兴应用,包括Chiplet、SoC重分区、存储重分区和背面PDN。
行业主要方向
半导体行业正在推进两种互补的异构集成方法,每种方法都有不同的特点和应用领域。2.5D-Chiplet集成方法强调模块化设计,采用通过标准化"片外"总线接口通信的独立芯片设计。这种方法最大化设计重用,允许混合工艺技术、制造来源和设计团队。
三维SoC集成方法代表了一种更紧密结合的解决方案,系统从一开始就为三维实现而协同设计。三维SoC设计不使用标准化接口,而是将片上互连网络扩展到垂直维度。三维互连采用片上IP接口电路,传输时序关键信号,在核心电压级别运行,并专注于低功耗操作。这种方法优化性能但需要跨三维堆栈的全面协同设计。
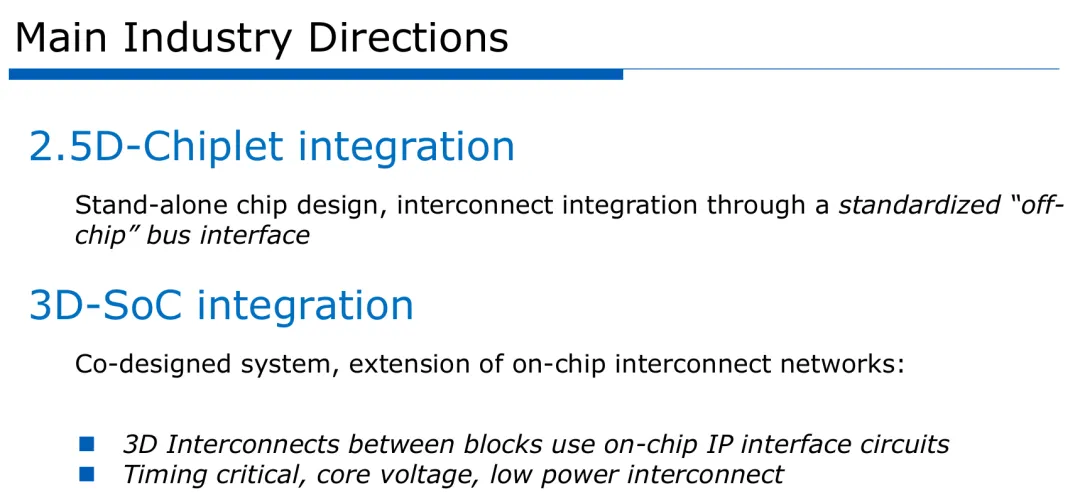
图6:2.5D-Chiplet集成和三维SoC集成的主要行业方向及其特点。
这两种方法在异构集成格局中发挥重要作用,Chiplet集成提供灵活性和模块化,而三维SoC集成为紧密耦合的设计提供最大性能和效率。
Chiplet集成与互连缩放
Chiplet方法将传统的片上系统分割成多个较小的芯片,每个芯片实现特定功能。这些Chiplet通过实现标准化接口协议的PHY IP模块在芯片之间通信。最广泛采用的例子是高带宽存储器(HBM)接口,它通过定义的协议和物理层规范将存储堆栈连接到逻辑处理器。
HBM接口的详细分析揭示了Chiplet互连中的工程选择。接口使用1024位宽数据总线,逻辑芯片和存储堆栈之间有1656个总I/O连接。连接以32个通道排列,间距为165μm,互连层实现约3.5μm线宽/间距特征。大部分连接用于电源、接地和控制信号,突显了Chiplet接口中固有的开销。
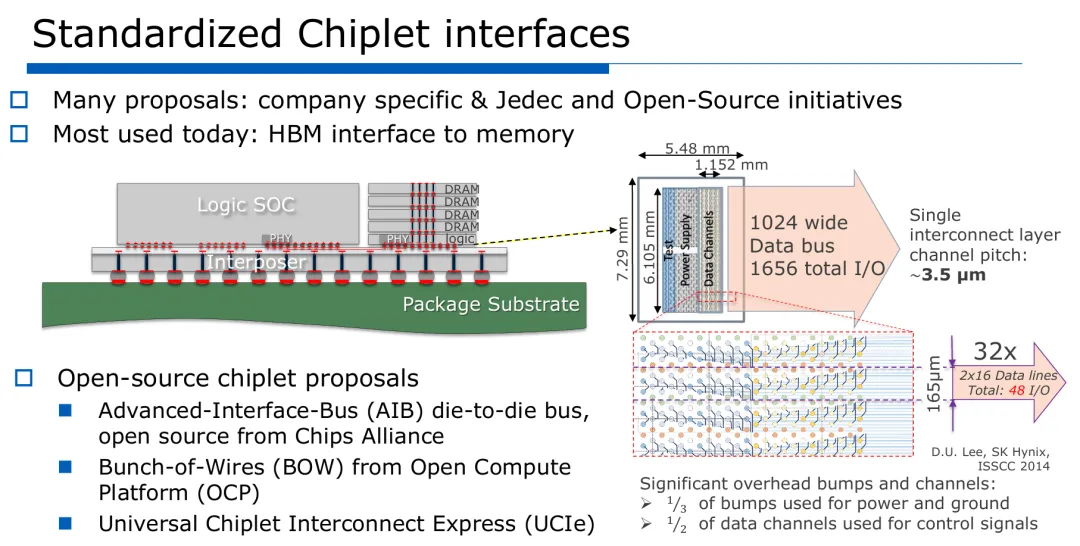
图7:标准化Chiplet接口,包括HBM接口详情和开源Chiplet提案。
基于Chiplet的系统性能高度依赖于互连缩放。数学分析表明,Chiplet互连总线的单位长度带宽(BWbus)与通道间距(Pch)成反比:
BWbus = BWsc / Pch
其中BWsc代表单通道带宽。这种关系驱使通道间距缩放以增加互连的带宽密度。当前行业实现在约4μm间距下运行,每通道8-12 Gbps,而更先进的研究针对2μm间距,每通道4-6 Gbps。最终目标是实现每毫米总线宽度2太比特每秒。
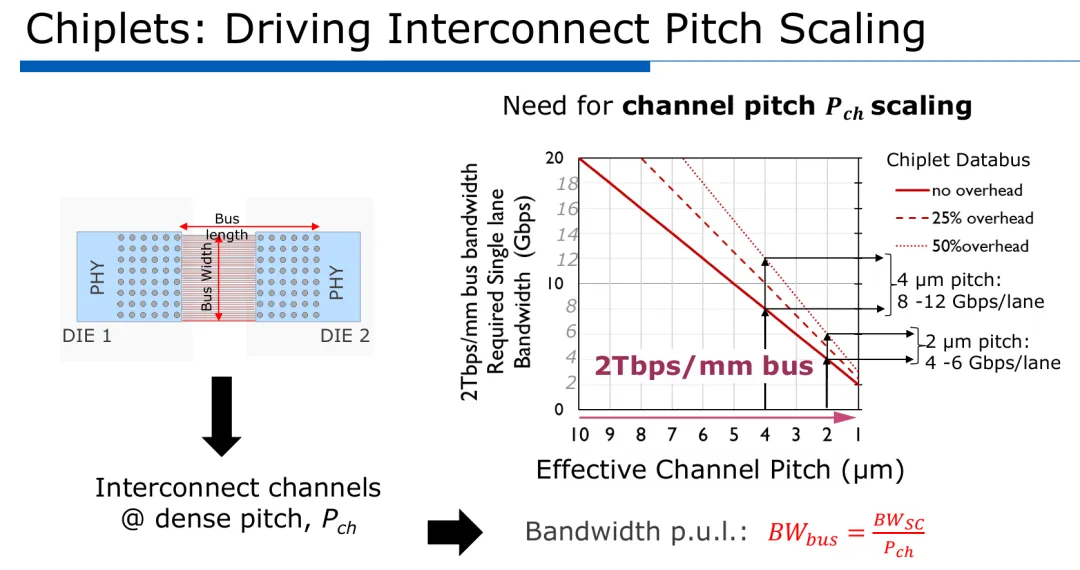
图8:有效通道间距、所需单通道带宽和总体总线带宽之间的关系,证明通道间距缩放的必要性。
进一步分析研究了互连开销与微凸点间距的关系。扇出自Chiplet接口所需的额外互连长度(ΔL)与微凸点间距(PμB)的平方成正比,与通道间距(Pch)成反比:
ΔL = (1 + 1/3) × P²μB / Pch
这种数学关系推动了精细间距通道互连和缩放I/O凸点间距的需求。互连扇出所需的增加芯片面积直接影响制造成本,使互连间距缩放对经济Chiplet实现很重要。
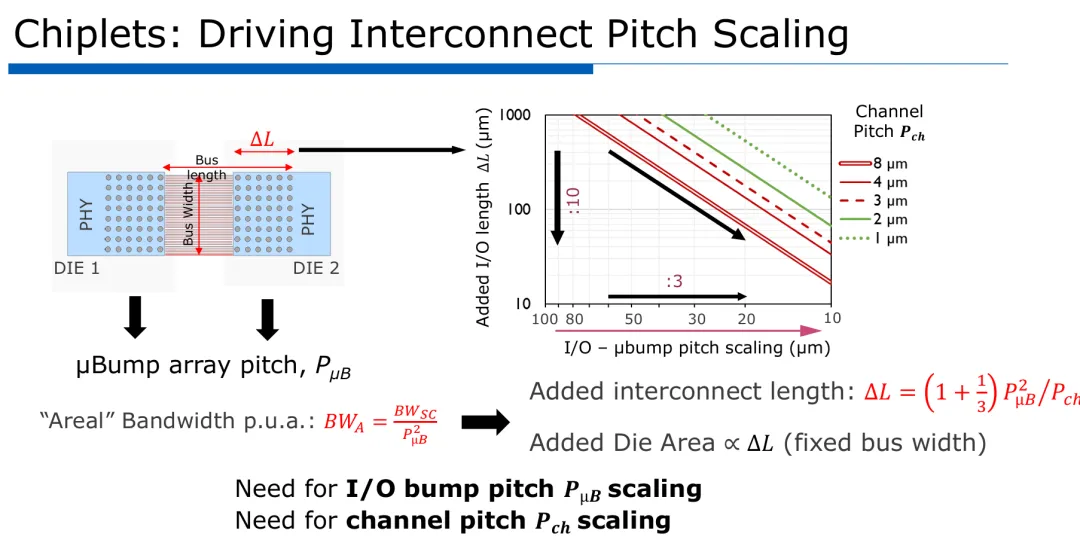
图9:互连长度、总线宽度、μ凸点阵列间距和通道间距缩放需求之间的关系。
功耗分析揭示了额外见解。Chiplet互连所需的功率包括两个主要组成部分:SerDes(串行器/解串器)功率,随串行化频率与芯片内部频率比的对数缩放;以及互连功率,与通道数量、运行频率、通道电容和电压平方成正比。对于Chiplet应用典型的短互连,SerDes能耗占主导地位,进一步强调通道间距缩放减少所需串行化比率的重要性。
2.5D集成技术
三种主要技术已经出现支持2.5D集成,每种技术都有不同的特点、优势和缩放潜力。
硅中介层代表最成熟的方法,使用带有氧化物基后端导线(BEOL)布线技术的大型硅基板。这些中介层通常实现约0.4μm线宽和间距,最多五个金属层,实现放置在中介层表面的Chiplet之间的高密度互连。附加功能包括深沟槽电容或金属-绝缘体-金属(MIM)电容,以改善电源完整性。
硅中介层的尺寸能力继续扩展,从当前约80mm × 80mm的实现到2027年预计超过120mm × 120mm。由于最大芯片尺寸由光刻掩模场定义,更大的中介层通过掩模拼接技术实现,有效连接多个曝光场。这一能力对于集成多个大型Chiplet与HBM存储堆栈的高性能计算应用很重要。
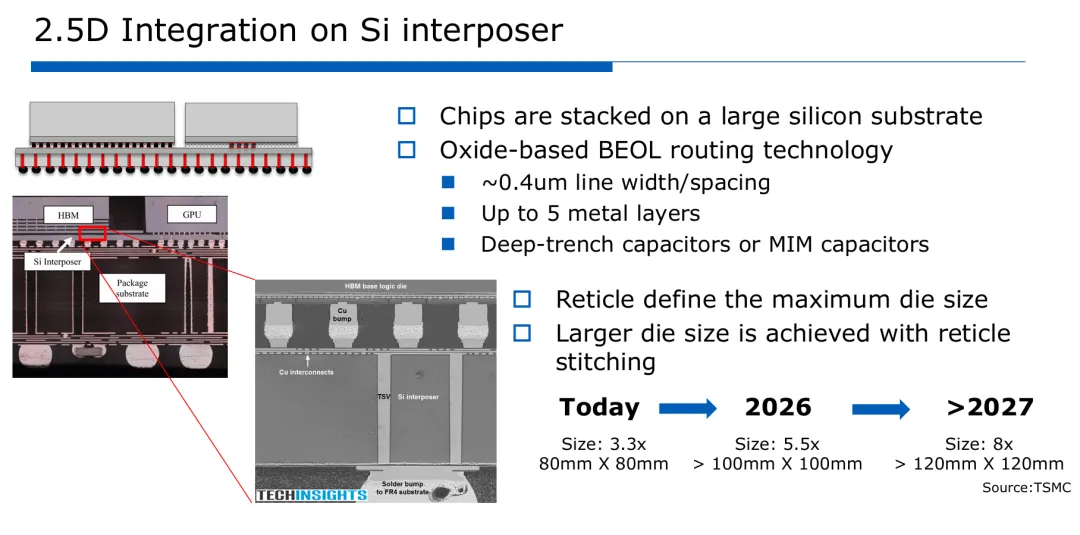
图9:硅中介层上的2.5D集成、其组成和尺寸缩放趋势。
硅桥提供了更有针对性的方法,仅在Chiplet相互接口的区域实现高密度硅互连技术。这种"仅在需要处使用硅"的理念与完整中介层相比降低了总体成本。最初开发时没有通过硅通孔(TSV),但当前实现纳入了TSV以满足高数据率的信号和电源完整性要求,如UCIe-S标准规定。先进实现甚至可以在桥结构中集成高密度去耦电容,以改善电源完整性。

图10:硅桥技术及其与完整中介层相比的优势。
精细间距重分布层(RDL)技术代表了Chiplet集成的经济替代方案,特别适用于不需要硅中介层极端互连密度的应用。正在开发两种主要方法:
1. 半加成RDL工艺建立在传统半导体制造技术基础上,从当前行业标准2μm线宽/间距特征缩放到研究实现低于1.6μm。然而,这种方法面临缩放限制,因为通孔通常需要比互连线更大的尺寸。
2. 聚合物"大马士革"RDL技术解决了这些限制,实现类似于BEOL处理的双重大马士革方法,但使用聚合物介电材料。这种技术在每层保持平坦表面,实现所有层的小间距,支持小于3μm直径的无焊盘通孔,并改善扇入/扇出布线能力。研究演示已显示从2μm到1μm的缩放,并继续探索朝向0.5μm线宽/间距特征。
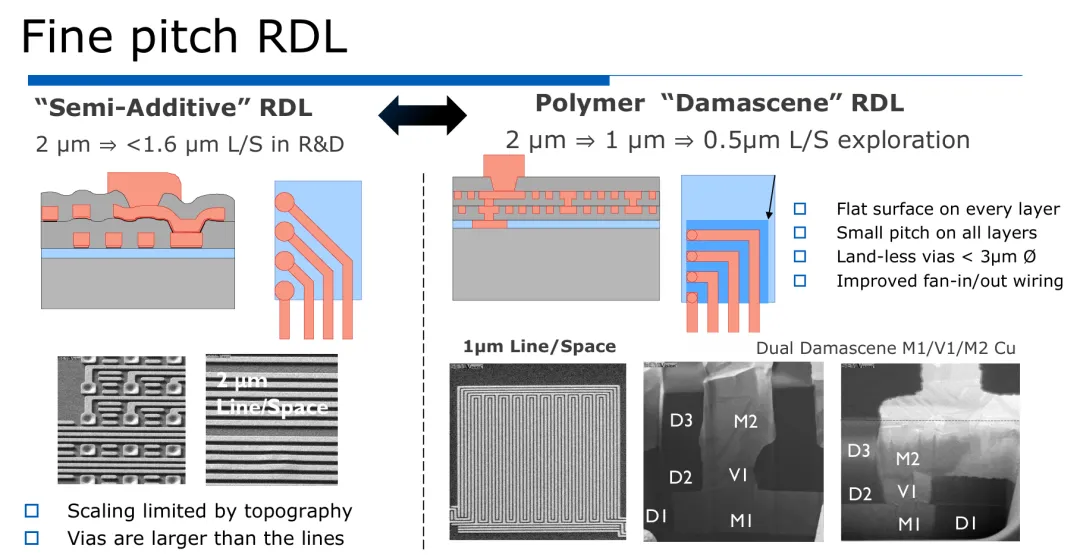
图11:精细间距RDL技术,包括半加成和聚合物"大马士革"方法及其缩放能力。
行业朝向更高三维互连密度的推动需要线间距和面积通孔密度的缩放。半加成RDL,目前在约2μm线宽/间距的行业标准,面临通孔缩小到0.7μm以下的挑战,并需要高分辨率光敏聚合物进一步发展。研究方向旨在改善互连密度(以每立方毫米互连数量衡量)与特征尺寸的关系,目标最终达到线宽/间距低于1μm及相应的通孔缩放。
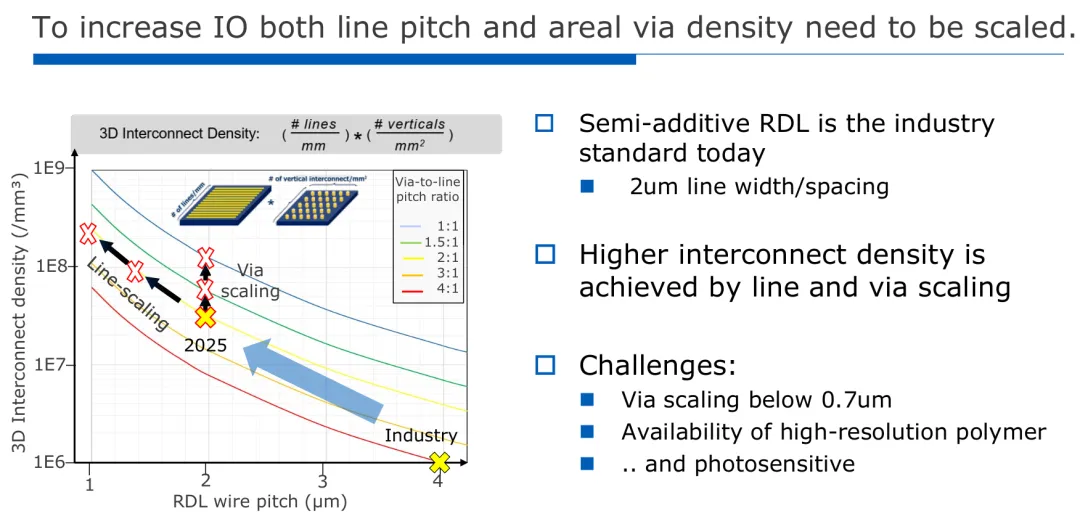
图12:RDL线宽缩放、通孔缩放和三维互连密度之间的关系。
三维垂直集成技术
垂直堆叠技术持续快速发展,通过多种技术方法实现真正的三维集成。
焊料微凸点技术已从早期50μm间距的实现发展到当前约30μm的行业标准。先进研究已证明从40μm、20μm、10μm、7μm到实验室环境中5μm间距的渐进缩放。这种缩放需要材料、工艺和集成技术的根本变化。
工业标准微凸点通常采用回流焊接工艺,凸点高度为25-35μm,间距限制在约30μm,受焊料桥接问题限制。缩放微凸点利用半加成铜凸点形成与晶圆级应用底填充材料,在组装过程中保持凸点间距。最先进的嵌入式微凸点实现大马士革底凸金属化(UBM)和焊盘结构,结合半加成锡微凸点,实现低至7μm的间距,展示四芯片堆叠能力。

图13:从工业标准到缩放和嵌入式方法的芯片到晶圆堆叠技术演进。
焊料凸点技术的缩放策略包括镀镍/锡微凸点和镍/铜焊盘,聚合物凸点嵌入技术与表面平坦化,以及热压芯片到晶圆键合工艺。在低于10μm间距时,挑战包括键合过程中的热膨胀和晶圆对准精度限制。5μm间距的研究演示利用2μm直径微凸点与专用介电嵌入技术。
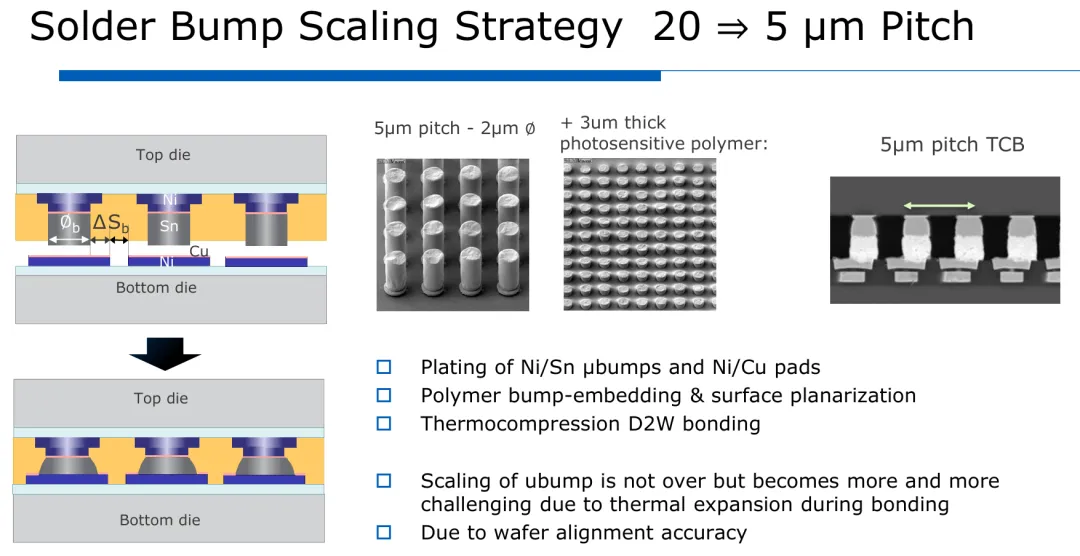
图14:焊料凸点缩放策略,实现5μm间距热压键合。
混合键合技术代表了垂直互连的革命性方法,完全消除焊料材料,转而采用直接铜对铜和介电对介电键合。晶圆到晶圆(W2W)混合键合展示了显著的间距缩放能力,从早期几微米的实现发展到当前低至0.4μm间距的研究演示。
W2W混合键合工艺利用SiCN(碳氮化硅)介电材料围绕铜键合焊盘。晶圆最初在室温下在介电接口键合,随后热退火促进铜扩散,在铜接口创建高质量冶金键合。截面分析显示该技术从2.16μm间距到1.44μm、0.7μm和研究样品中低至0.4μm的发展,研究继续朝向0.2μm间距能力发展。
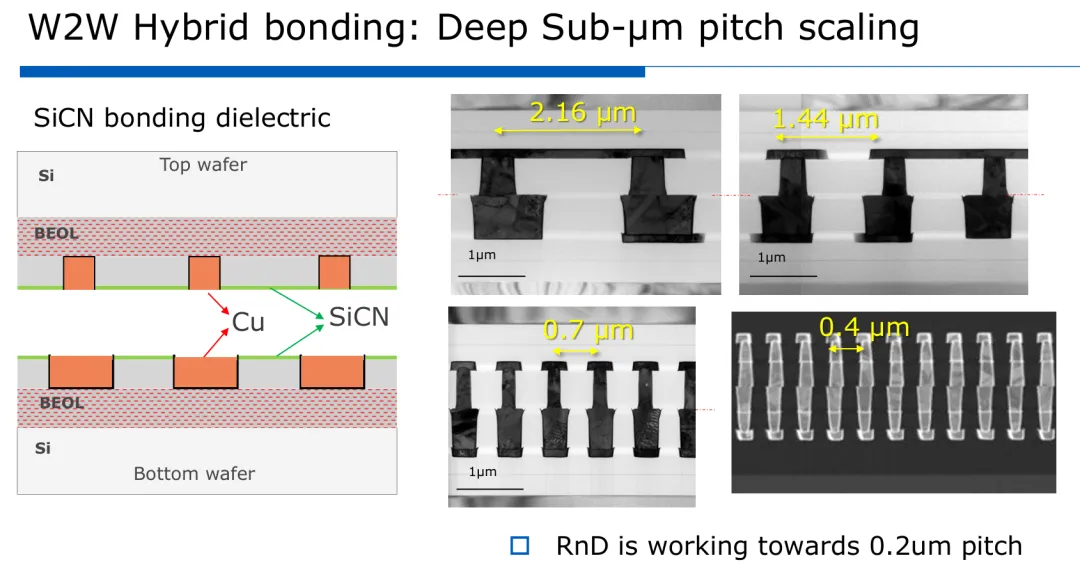
图15:W2W混合键合技术,实现深亚微米间距缩放至0.4μm。
这些精细间距混合键合的电气表征在300mm直径晶圆上展示了一致的电阻性能,400nm间距接触显示在每个连接约5.0-5.5欧姆的良好控制电阻分布。这种一致性对于大规模制造实现至关重要。

图16:400nm间距W2W接触阵列及其电气电阻特性。
芯片到晶圆(D2W)混合键合将相同技术原理扩展到更灵活的芯片级集成领域,但引入了额外的工艺复杂性。目标晶圆必须有精确准备的铜混合键合焊盘,表面高度敏感,而芯片必须经过晶圆变薄和超洁净切割工艺,不影响混合键合表面。这需要专门技术,包括表面保护层、等离子体切割工艺避免机械损伤,以及用于处理薄晶圆和芯片的载体系统。
D2W混合键合工艺流程需要芯片表面活化,使用专用工具精确拾取,高精度洁净放置到目标晶圆上,随后热退火完成混合键合工艺。尽管存在这些挑战,D2W混合键合已在低至2μm间距上得到证明,使其成为需要已知良好芯片选择灵活性与混合键合互连密度优势的应用的宝贵技术。
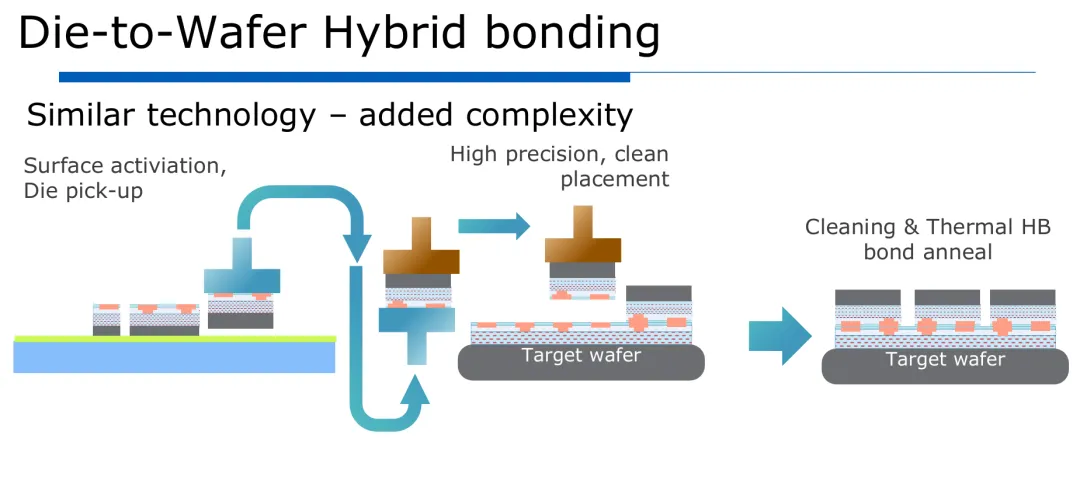
图17:芯片到晶圆混合键合工艺流程,包括表面活化、芯片拾取和放置。
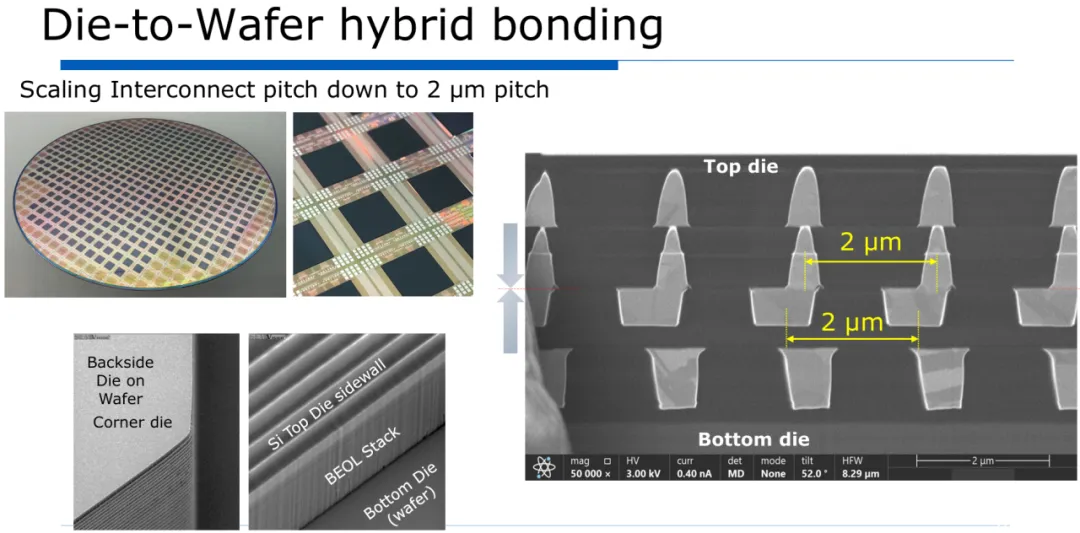
图18:芯片到晶圆混合键合,实现2μm间距互连缩放。
SoC功能分区
三维集成使SoC设计通过功能分区采用新方法,优化系统性能超越传统二维实现可能。
存储-逻辑分区代表最有影响力的方法之一,将存储元素直接垂直堆叠在逻辑电路上。在传统二维SoC中,存储和逻辑模块水平排列,通过复杂片上网络通信,造成延迟和功耗损失。通过转向三维堆叠方法,无论是逻辑/SRAM堆叠还是多层存储配置,存储和计算元素之间的物理距离都大大减少。
这种三维存储-逻辑集成消除了中间接口PHY模块需求,提供无额外电路引起延迟的直接芯片到芯片三维互连,减少最大和总配线长度,从而改善延迟和功耗效率。这些优势不仅适用于高级缓存存储器,也适用于集成更靠近处理元素的低级缓存。

图19:存储-逻辑集成的SoC功能分区方法,比较二维SOC与三维片上系统方法。
商业实现已经证明了这种方法的优势,AMD的三维V-cache技术将SRAM缓存存储器直接堆叠在CPU芯片上,显著增加可用缓存容量,避免与片外存储访问相关的延迟损失。
多核处理器分区扩展了这些概念到全面系统重组。传统二维多核处理器在单一平面上排列存储缓存、处理器核心、通信架构和I/O接口。三维功能分区方法将这些元素分为优化层:专用层的存储缓存,另一层的处理器核心逻辑,第三层的通信架构和外部I/O。
这种方法通过使用针对每层需求优化的工艺技术实现经济制造。存储层可以使用为密集SRAM优化的工艺,逻辑层可以利用先进逻辑工艺获得高性能晶体管,而I/O层可以采用更成熟的工艺节点,具有更高电压能力和更好的模拟特性。
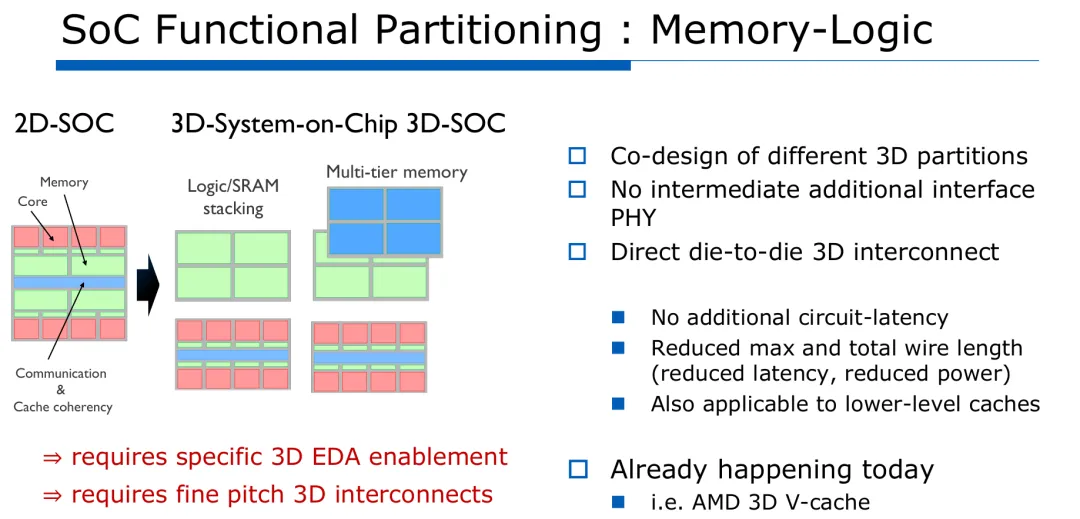
图20:显示多核处理器分区及三维技术要求。
此类分区系统的实现需要复杂技术堆栈,包括用于存储到逻辑接口的晶圆到晶圆键合,用于有效电源分配的背面电源分配网络(PDN)与纳米通过硅通孔(nTSV),以及用于逻辑到I/O接口的芯片到晶圆键合。底部分区的背面TSV连接提供与封装基板的连接,用于外部通信。
电源分配挑战和解决方案
电源分配可能是三维集成系统最关键的挑战,热管理和电源分配都需要创新解决方案。
随着高性能计算中热密度超过100 W/cm²并接近500 W/cm²,热管理已成为限制因素。传统空气冷却技术无法有效散发这种热负载,需要先进方法如三维打印冲击冷却器。
这些专用冷却系统将精确冷却液体喷射(通常为去离子水)直接导向芯片最热区域,创造比传统技术更有效的热传递。实验演示相比先进空气冷却显示超过6.5倍的冷却能力提升,实现在23×23mm芯片面积上高达1千瓦的热管理。该技术继续发展,1mm间距冲击冷却器有望提供更大能力。
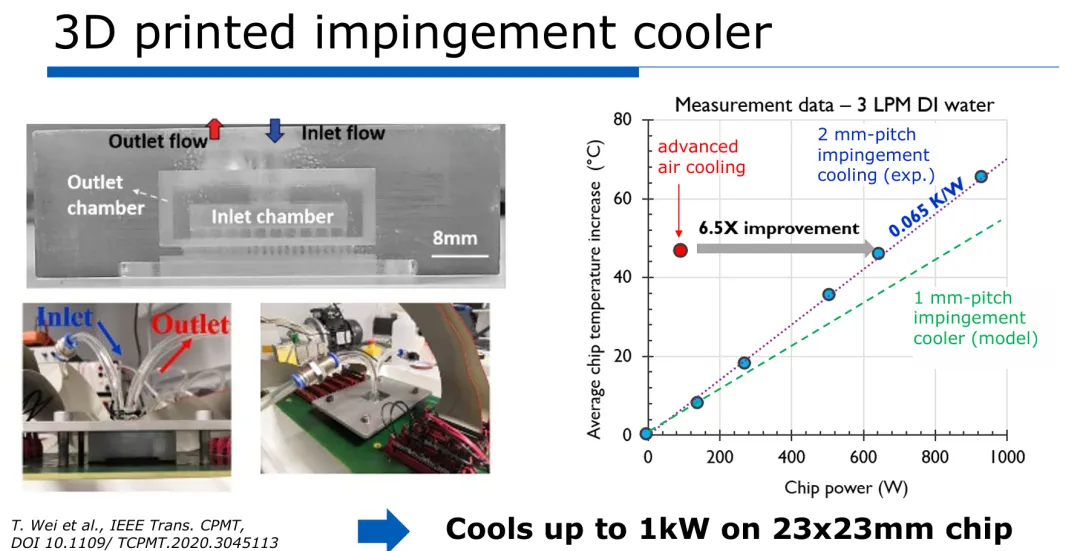
图21:三维打印冲击冷却器技术,性能测量高达1kW冷却能力。
电源分配网络面临互补挑战,为三维堆叠系统中增加的晶体管高效提供电力。在低电压(通常低于1V)运行时,这些系统需要接近每平方毫米安培的高电流密度,具有严格调节容差和快速瞬态响应要求。
解决这些挑战的革命性方法是带有纳米TSV(nTSV)技术的背面电源分配网络(BSPDN)。这种方法将电源分配移到晶圆背面,释放前端金属层用于信号布线。实现利用硅内埋入电源轨(BPR),连接到埋入电源轨的过孔(VBPR),以及连接到背面金属(BSM)电源分配层的纳米级通过硅通孔。
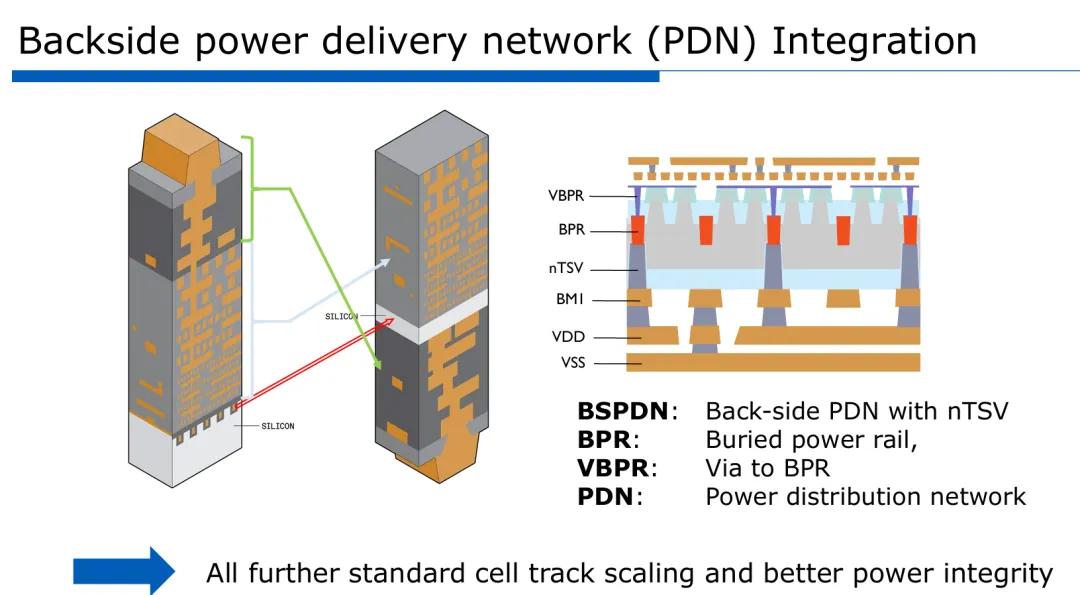
图22:背面电源分配网络集成,包括nTSV、BPR和VBPR。
技术演进从"nTSV-last"方法(在器件制造后创建通孔)发展到"nTSV-first"技术(通孔集成到初始硅处理中)。这些nTSV已从早期90nm直径实现缩放到当前45nm演示,具有精确控制的纵横比和电气特性。电气表征确认背面电源分配器件与传统前端供电器件性能相同,保持相同阈值电压和电流-电压特性。
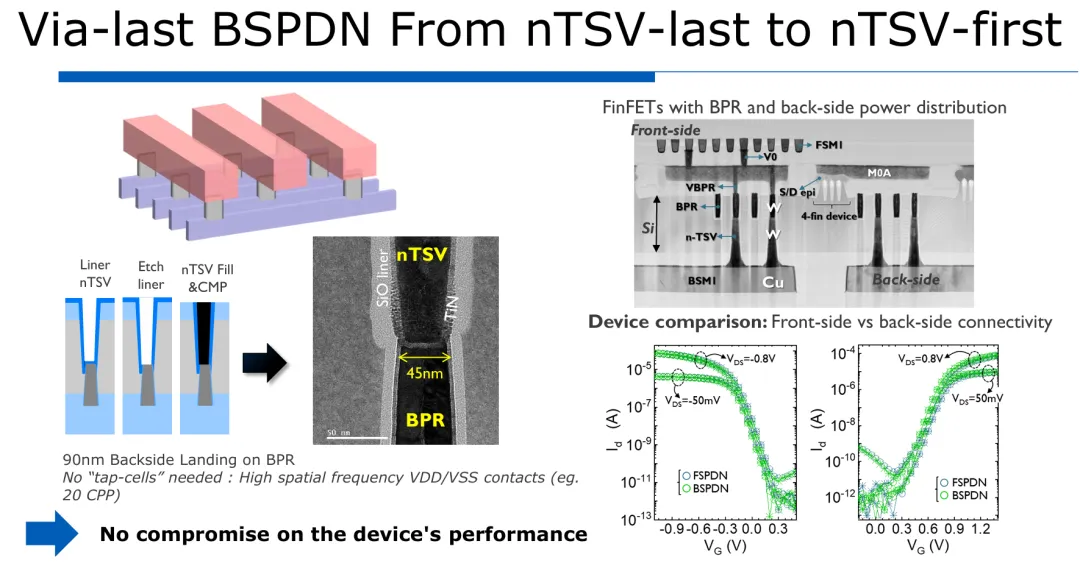
图23:通孔-last BSPDN实现,从nTSV-last到nTSV-first演进及器件性能比较。
这种方法的优势超越电源分配;通过消除传统设计中连接到电网的专用"接头单元"需求,有效逻辑密度可以增加。BSPDN方法实现高空间频率电源连接(例如,每20个接触间距),而不消耗宝贵前端布线资源。
三维互连技术全景和路线图
半导体行业的三维互连技术跨越了从毫米到数百纳米的互连间距和每平方毫米单个到数亿的三维互连密度的非凡范围。
这一技术全景可分为四大类:三维系统封装(3D-SIP),三维堆叠集成电路(3D-SIC),三维片上系统(3D-SOC)和三维集成电路(3D-IC)。每个类别代表集成密度的阶跃增加,实现相应先进应用。
3D-SIP领域包括封装堆叠和多芯片封装方法,相对粗糙的垂直连接间距通常超过100μm。3D-SIC类别包括带微凸点的芯片堆叠(间距10-40μm)和带混合键合的芯片堆叠(间距1-10μm)。3D-SOC水平代表下一个重大进步,晶圆到晶圆混合键合在亚微米间距,而3D-IC方法包括晶圆到晶圆顺序处理和新兴晶体管堆叠技术如互补场效应晶体管(CFET)。

图24:三维互连技术全景,从封装堆叠到晶体管堆叠,互连间距从1mm到100nm。
这些技术的历史演进显示从1990年代传统印刷电路板(PCB)表面贴装技术(SMT)的渐进精炼,到2000年代硅到覆层直接连接,随后在2010年代出现芯片到芯片和芯片到晶圆微凸点堆叠技术。当前十年见证了生产规模的微TSV和晶圆到晶圆混合键合的出现,芯片到晶圆混合键合、用于背面PDN的纳米TSV和晶圆到晶圆顺序技术将在未来几年进入生产。
三维集成路线图显示多种技术的融合路径。芯片到晶圆微凸点技术继续从行业约20-30μm间距实现向研究演示5μm及以下发展。芯片到晶圆混合键合正从当前约10μm间距实现向亚5μm能力缩放。晶圆到晶圆混合键合,研究中已展示亚微米间距,预计在未来几年达到接近100nm的深亚微米尺寸。同时,用于背面PDN的纳米TSV技术正快速缩放以支持标准单元级电源分配所需的极端密度。

图25:三维全景和互连路线图,包括W2W HB、D2W HB、D2W μbump和nTSV技术的行业和研发趋势。
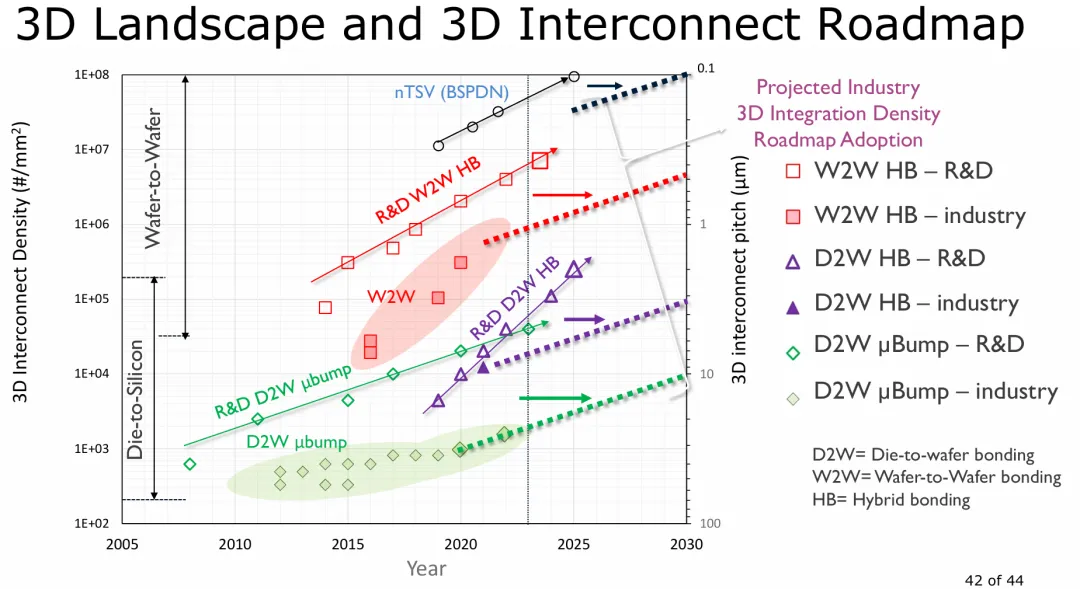
图26:预计的行业三维集成密度路线图,涵盖各种技术的采用。
重大挑战和未来方向
半导体行业面临几个重大挑战,以充分实现三维系统集成的潜力。这些跨学科挑战需要多个技术领域的创新。
热管理代表主要约束,需要高性能热扩散和移除技术来管理三维堆叠系统中的集中热负载。先进冷却解决方案包括微流体通道、直接芯片冷却和相变冷却系统正在开发中以解决这些需求。
电源分配网络架构必须发展以支持先进三维系统的极端电流密度和严格调节要求。这包括封装或中介层内的集成电压调节器、高密度去耦电容,以及带纳米TSV的背面PDN等新型电源分配方法。
通过硅通孔技术继续在多个领域缩放,从用于硅中介层的相对大型TSV(5μm直径×50μm深度),到用于芯片堆叠的微TSV(0.7-3μm直径),到用于背面PDN的纳米TSV的极端缩放(直径小于100nm)。每种尺度在蚀刻、隔离、金属化和可靠性方面呈现独特制造挑战。
垂直堆叠技术在多个方面取得进展。芯片到晶圆堆叠的嵌入式微凸点已在研究演示中从40μm缩放到20μm、10μm、7μm和5μm间距。芯片到晶圆和晶圆到晶圆应用的直接铜对铜键合方法已证明从5μm到400nm的间距,研究针对更精细尺寸。

图27:三维系统集成的重大挑战,包括热管理、电源分配、互连技术和集成方法。
正在开发具有亚微米特征的高密度重分布层(RDL)技术以支持先进芯片到芯片互连。硅中介层技术继续发展,重构晶圆方法实现更大有效尺寸。封装内集成的高速光学I/O模块有望革新长距离连接的芯片到芯片通信。
随着行业继续推进这些技术,异构集成将在超越传统缩放延续摩尔定律中发挥越来越重要的作用,通过在统一的三维架构中结合多种技术的最佳特性,实现新一代高性能、能源高效的电子系统。
参考文献
[1] N. Pantano, "From monolithic 2D to heterogeneous integration: an advanced packaging technologies landscape," in Proc. IEEE Int. Solid-State Circuits Conf. (ISSCC), 2025, pp. 1-44.
END
 微信公众号
 bilibili
 微信视频号