


引言
随着人工智能(AI)和高性能计算(HPC)技术的快速发展,对内存系统的要求不断提高。随着AI模型规模和复杂性的指数级增长,计算能力和内存资源的需求达到了新的高度。本文探讨AI和HPC领域中的关键内存需求和新兴解决方案。
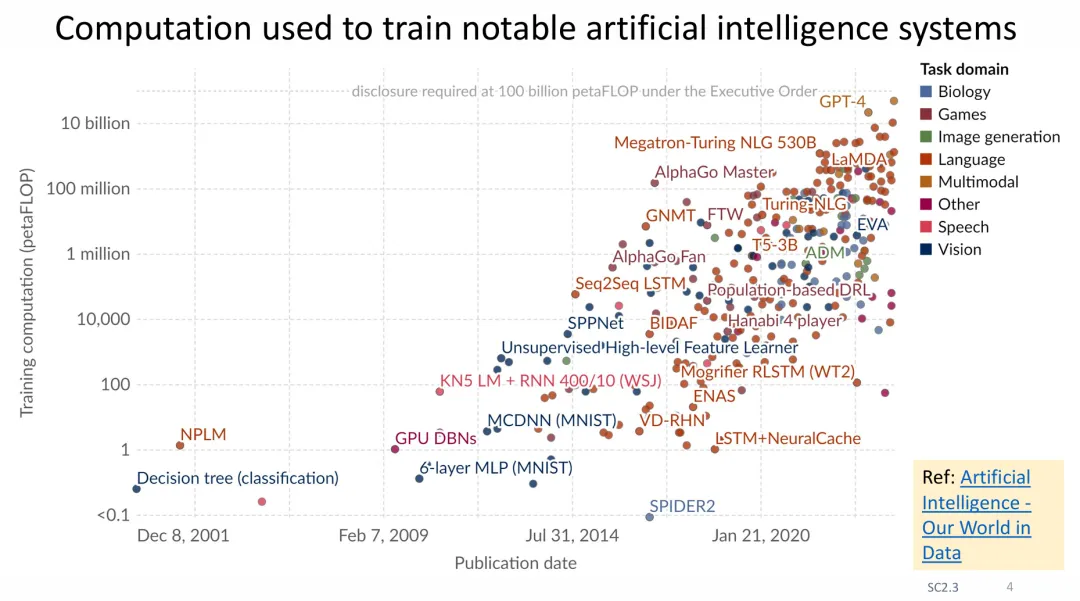
图1:显示了从2001年到2023年不同AI领域计算需求的指数增长,展示了AI训练所需计算量的历史演进。
内存性能需求
在现代计算系统中,性能与计算和内存能力的相互作用密切相关。通过roofline模型可以分析这些组件之间的关系,有助于理解性能限制和优化机会。
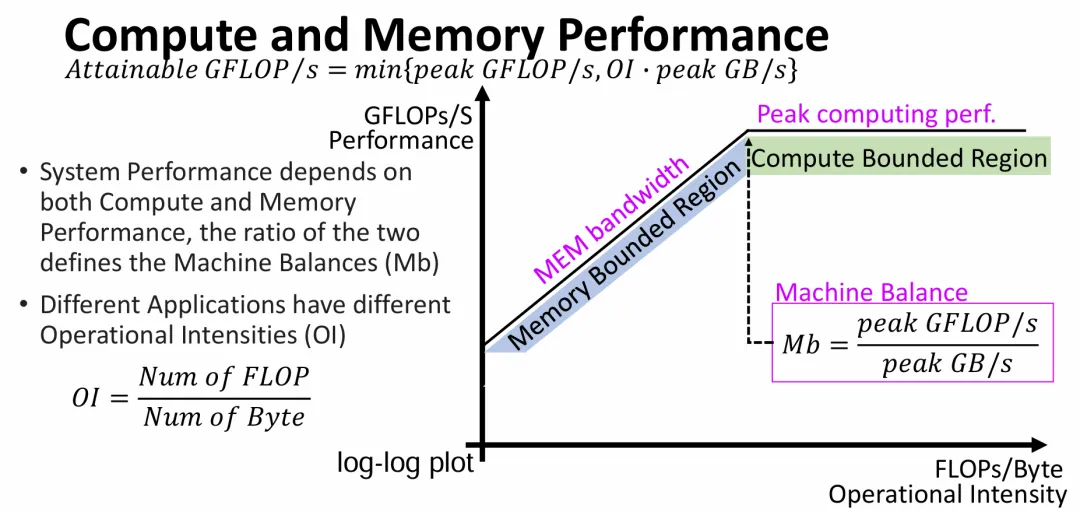
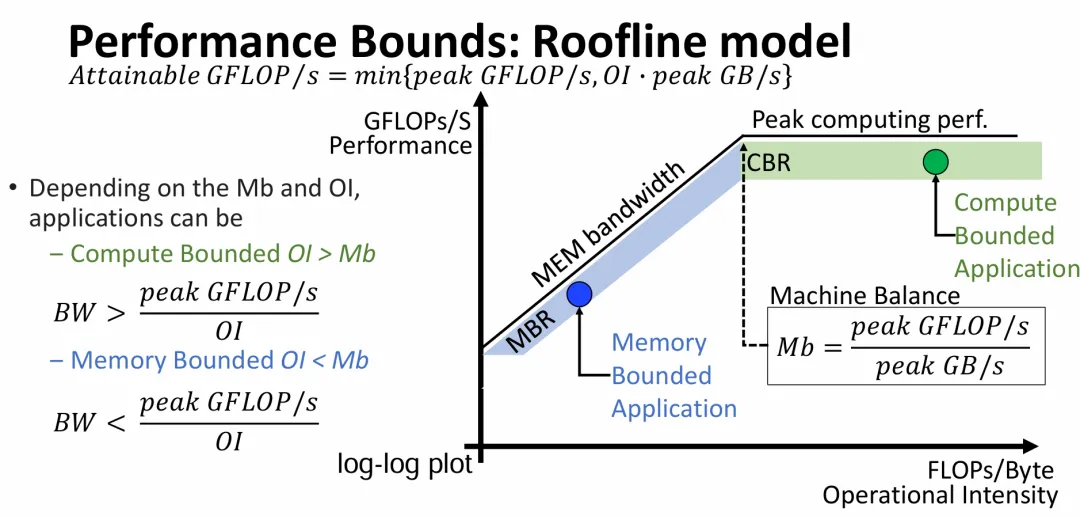
图2:roofline模型展示了运算强度和可达到性能之间的关系,显示了计算受限和内存受限区域。
计算系统的性能取决于计算能力和内存带宽。这两个因素之间的比率定义了机器平衡(Machine Balance, Mb),而不同应用程序具有不同的运算强度(Operational Intensity, OI)。运算强度的计算公式为:
OI = 浮点运算数量 / 字节数
对于内存受限的应用(OI < Mb),性能受内存带宽限制。相反,对于计算受限的应用(OI > Mb),性能受计算能力限制。
内存架构演进
内存解决方案经历了显著发展,主要沿着两条路径发展:面向CPU的DDR演进和面向GPU的HBM演进。
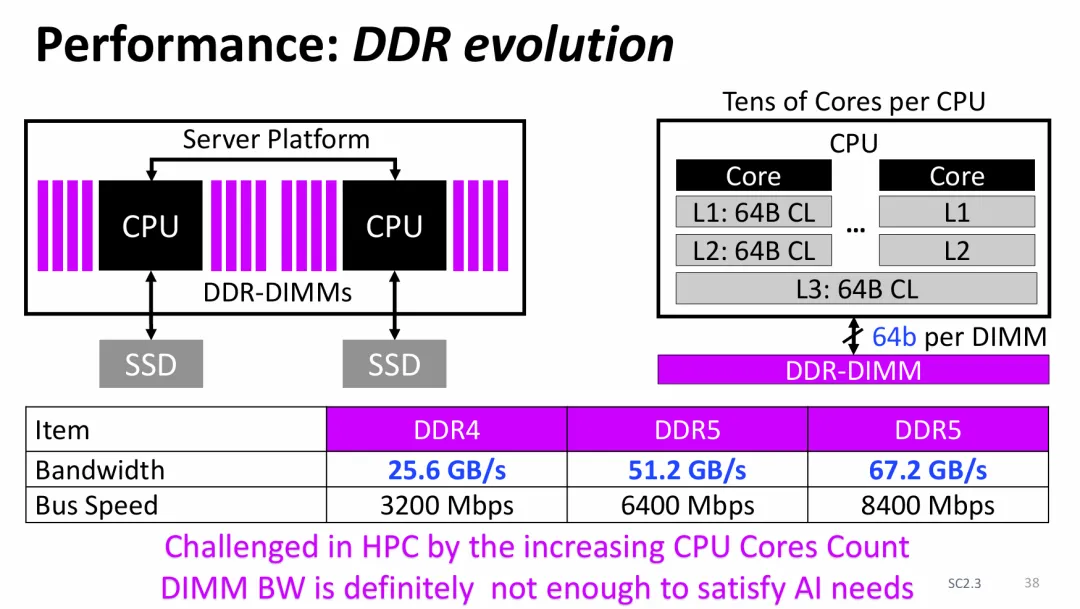
图3:DDR内存技术的演进,展示了从DDR4到DDR5的带宽和总线速度的提升。
DDR技术从DDR4发展到DDR5,带宽有显著提升:
DDR4:3200 Mbps下带宽达25.6 GB/s
DDR5:8400 Mbps下带宽可达67.2 GB/s
同样,HBM技术也取得了显著进展:
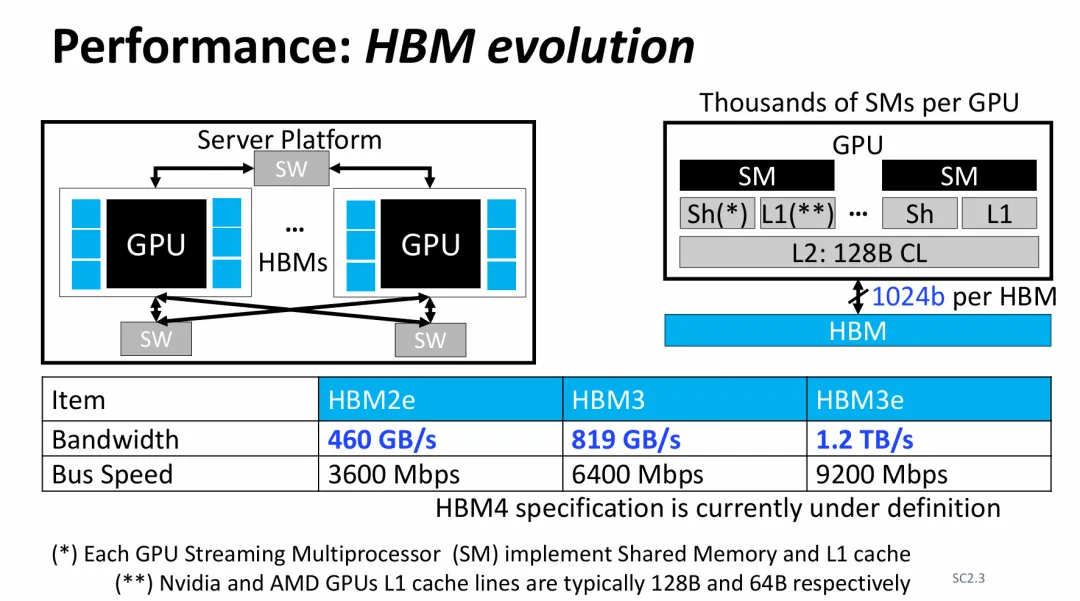
图4:HBM演进时间线,展示了从HBM2e到HBM3e的带宽能力提升。
HBM技术从HBM2e发展到HBM3:
HBM2e:带宽460 GB/s
HBM3:带宽819 GB/s
HBM3e:带宽1.2 TB/s
可靠性考虑
随着系统扩展到数千个组件,可靠性变得越来越重要。在分布式系统中,内存中的单个不可纠正错误可能影响数千个GPU。
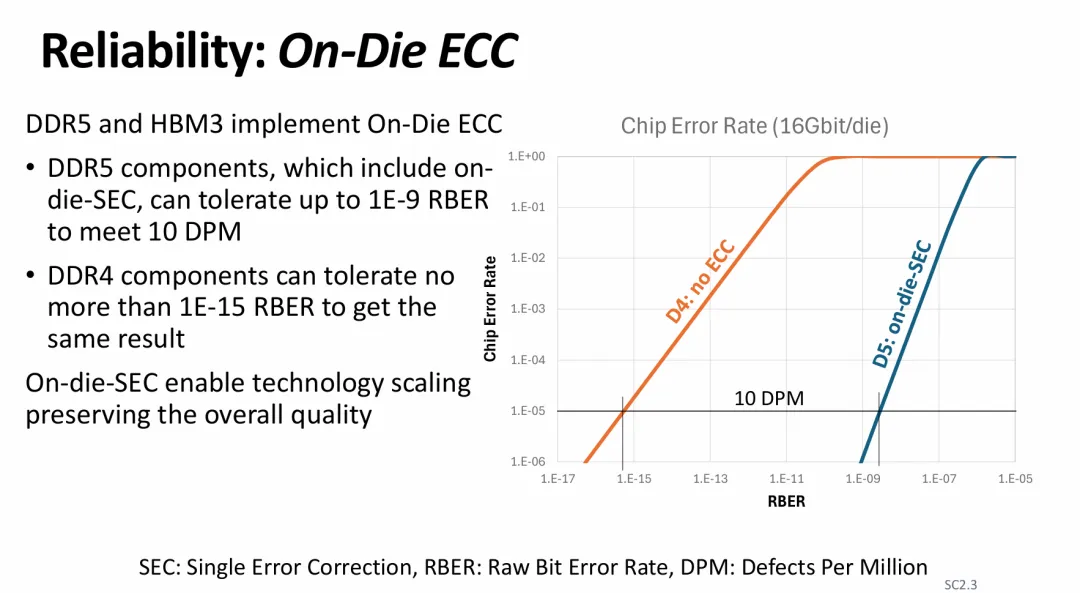
图5:芯片内ECC对内存可靠性的影响,展示了现代ECC实现在错误容忍度方面的显著提升。
现代内存系统实现了多种可靠性特性:
芯片内ECC:在DRAM器件内实现的错误纠正
Chipkill:能够处理完整芯片故障的高级错误纠正
错误预测:主动识别潜在故障
巡查擦除:持续进行内存扫描以检测错误
未来方向和先进解决方案
AI和HPC的内存系统未来正在向更复杂的解决方案发展,结合多种技术和方法。
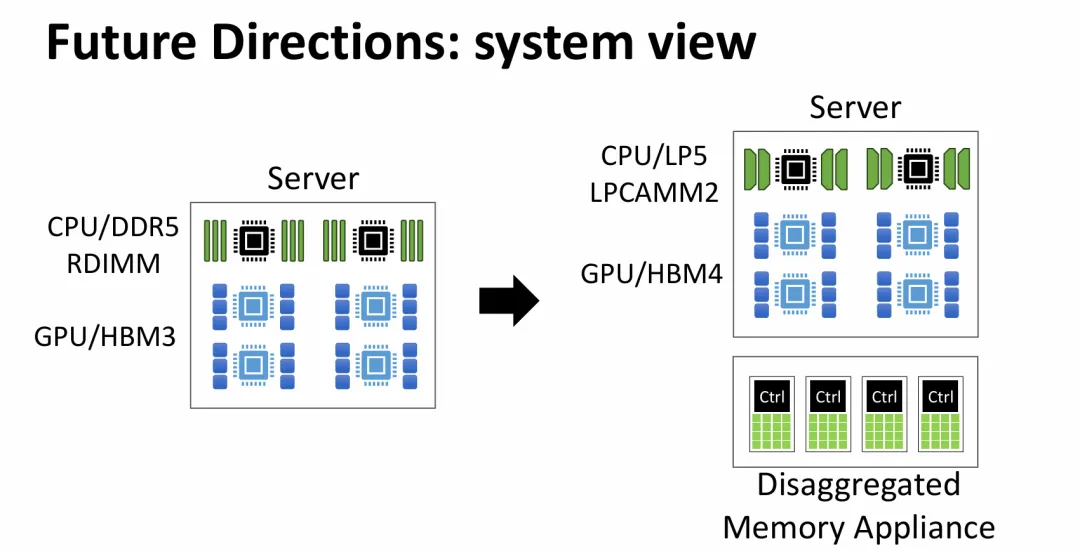
图6:服务器架构演进,展示了从传统到未来内存配置的转变,包含了分解式内存解决方案。
主要发展包括:
通过CXL技术实现内存分解
用于提高密度和性能的先进封装解决方案
在单个系统中集成多种内存技术
近内存计算能力
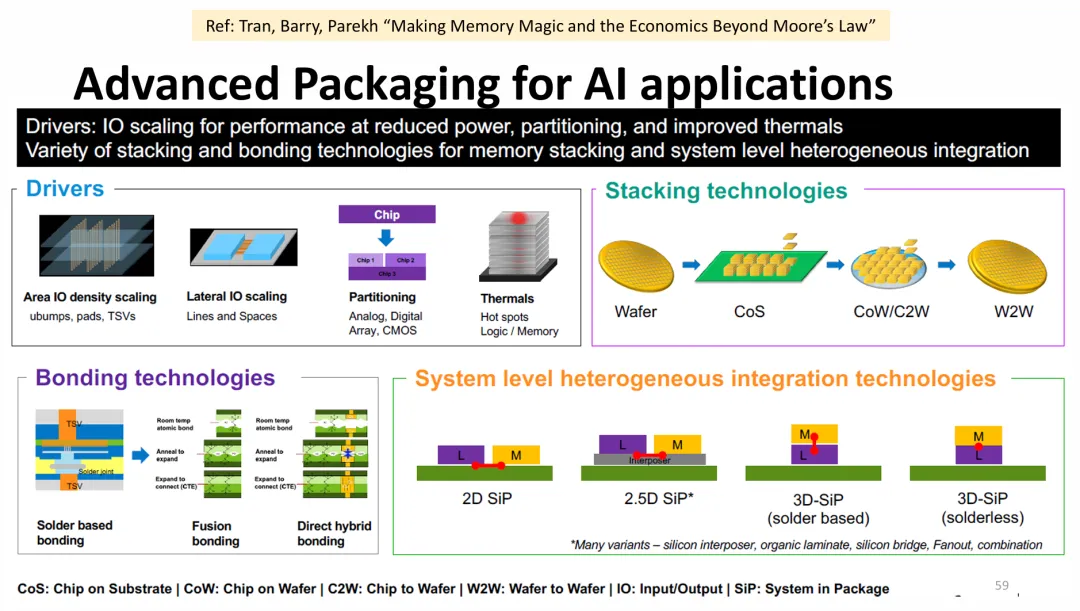
图7:支持下一代内存解决方案的先进封装技术,展示了各种堆叠和键合方法。
行业正在积极开发新的封装技术,以实现:
通过先进堆叠提高IO密度
改进散热管理
更好的系统级集成
通过新型互连解决方案提升性能
结论
内存系统的发展继续受AI和HPC应用需求的推动。满足这些挑战需要多种方法的平衡:
集成包含HBM、DDR和新兴技术的异构内存解决方案
实施稳健的可靠性特性以确保系统稳定性
开发先进的封装和互连解决方案
采用内存分解和近内存计算策略
随着AI模型继续增长,HPC应用变得更具挑战性,行业必须继续创新,在保持系统平衡和可靠性的同时提供必要的内存能力。
参考文献
[1] E. Confalonieri, "Memory Needs and Solutions for AI and HPC," in IEDM 2024 Short Course on AI Systems and the Next Leap Forward, Short Course 2.3, 2024.
END
 微信公众号
 bilibili
 微信视频号