


引言
随着现代计算系统日益复杂,多chiplet架构已成为构建大规模系统的重要解决方案。通过连接多个较小的chiplet来替代制造单个大型芯片。然而,设计chiplet之间的高效互连网络仍面临挑战,特别是在维持高性能和无死锁路由方面[1]。
网络架构与接口设计
在基于chiplet的系统中,基本构建模块通常是每个chiplet内部的二维网格片上网络(NoC)。此架构将节点分为两类:用于外部连接的边缘节点(接口节点)和用于功能模块的内部节点(核心节点),如CPU或AI核心。
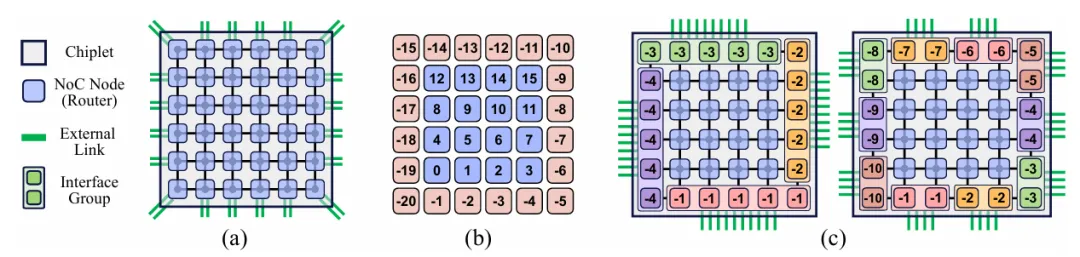
图1:chiplet上的网络架构示意图,展示了(a) 6x6二维网格中的36个NoC节点,(b)节点标记方案,以及(c)具有radix-4和radix-10配置的接口分组方法。
为有效利用chiplet接口,采用接口分组方法,将相邻的边缘节点聚集成抽象接口。这种方法使chiplet的连接基数和带宽分配更加灵活。
高基数互连拓扑
多个chiplet可以通过不同拓扑结构互连形成更大的系统。常见配置包括:
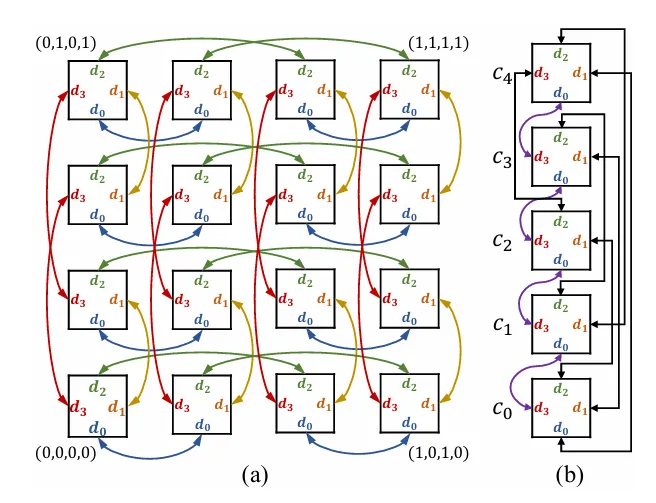
图2:互连拓扑示例,展示了基于相同chiplet基础构建的(a)超立方体和(b)蜻蜓网络配置。
超立方体配置:
每个chiplet沿不同维度与其他chiplet连接
提供平衡的连通性,直径随节点数呈对数增长
支持高效的路由算法
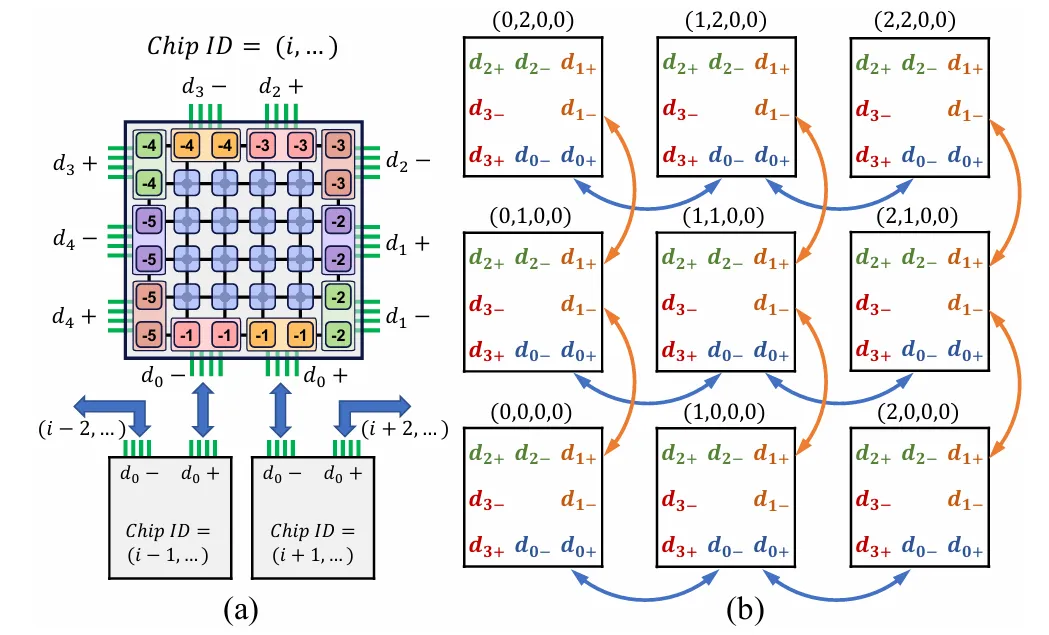
图3:chiplet互连细节,展示了(a)5D网格的连接和标签排列,以及(b)4D网格中d0-d1平面的连接概览。
路由方法
路由设计采用负优先路由(MFR)算法确保无死锁运行。这种方法要求数据包在通过正向通道之前必须先通过负向通道,防止循环依赖。
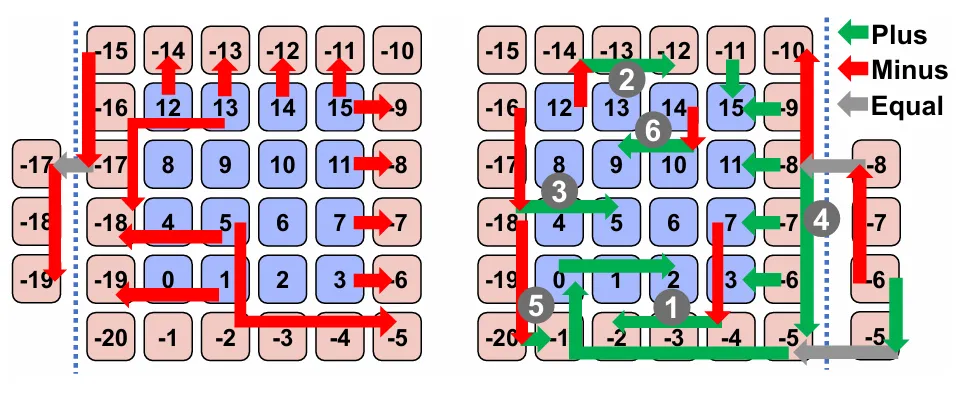
图4:路由系统中通道类型(正向、负向和相等)概览,展示了不同路由路径之间的关系。
网络交错
为最大化带宽利用率,网络交错技术在抽象接口组内的多个物理接口间分配流量。实现了两种主要方法:
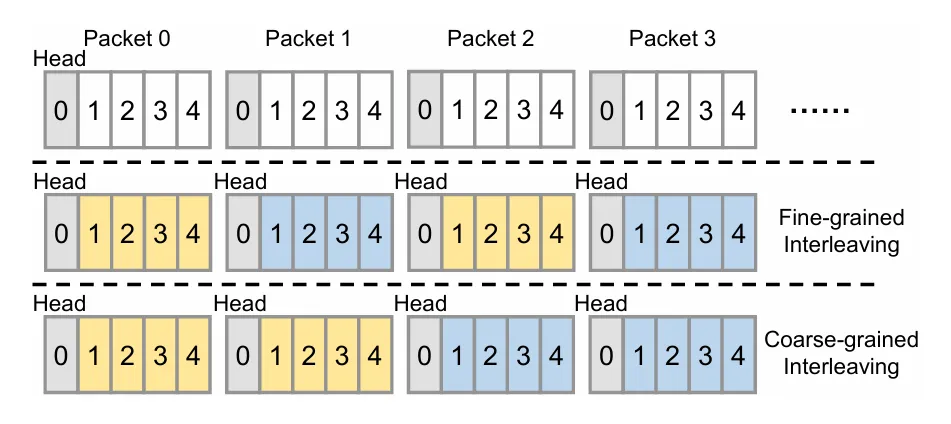
图5:细粒度和粗粒度交错方法的比较,展示了不同的数据包分配策略。
1. 性能分析
系统性能在各种流量模式和配置下进行了评估:
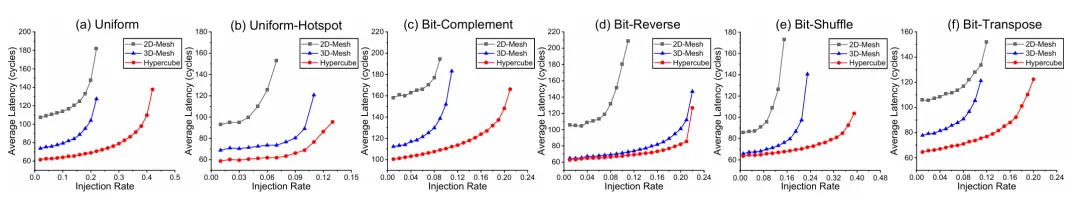
图6:不同流量模式下的性能评估结果,展示了延迟与注入率的关系:(a)均匀分布,(b)均匀热点,(c)位互补,(d)位反转,(e)位重排,(f)位转置。
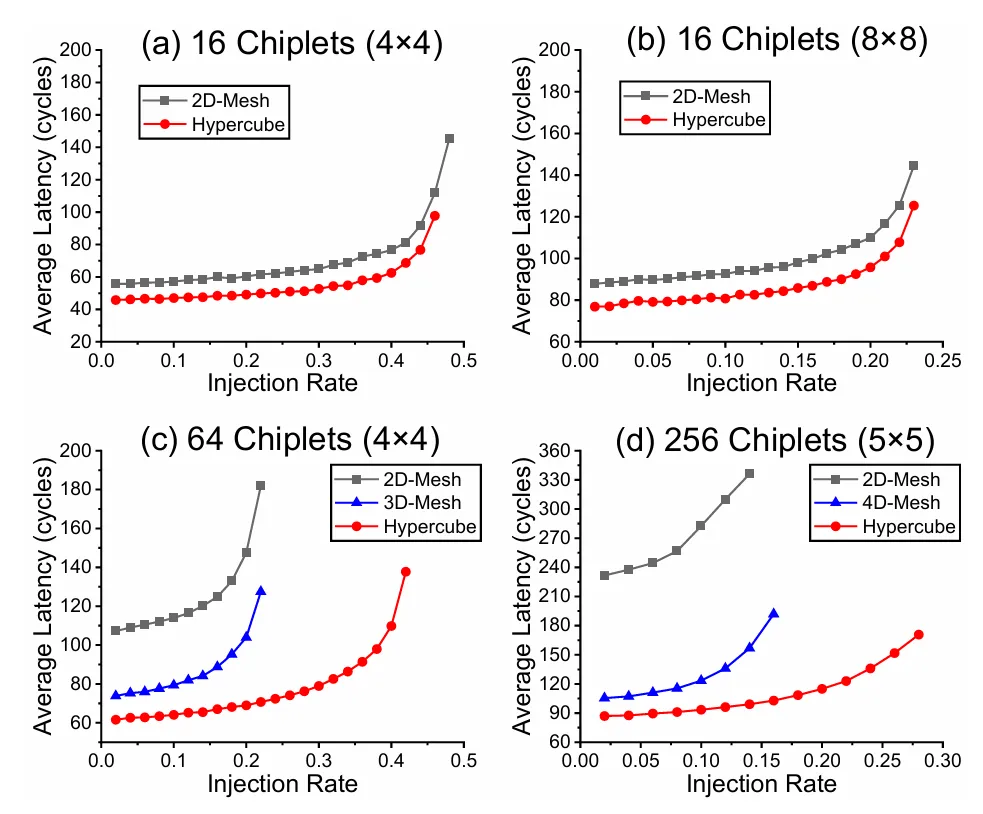
图7:不同系统规模在均匀流量下的平均延迟评估结果,展示了架构的可扩展性。
与传统二维网格系统相比,结果显示显著改进:
最大注入率提升达2倍
平均延迟减少高达45%
随着chiplet数量增加,扩展性更好
2. 能效分析
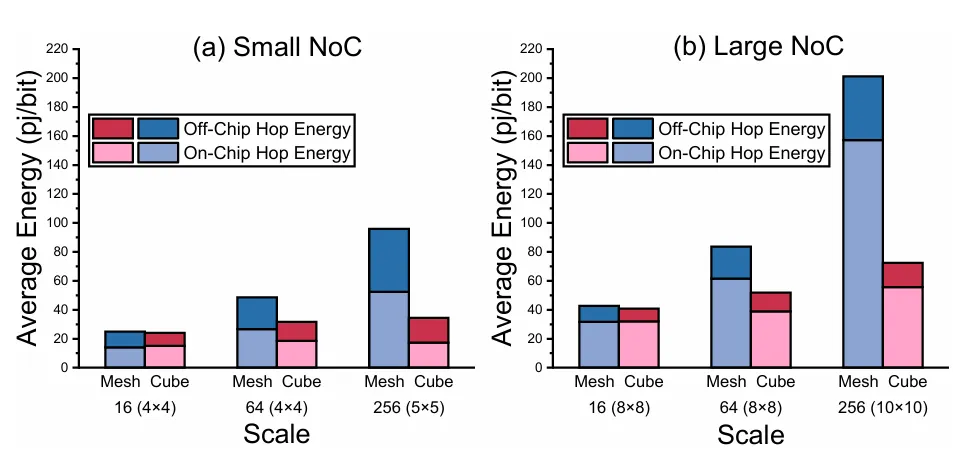
图8:二维网格和超立方体配置在不同规模和NoC大小下的能耗比较。
建议的架构显示出显著的节能效果,特别是在大型系统中。对于256-chiplet配置,与传统二维网格设计相比,功耗降低约60%。
结论
所述方法为设计高效chiplet互连网络提供了完整解决方案。通过结合接口分组、自适应路由和网络交错,系统实现了优于传统方法的性能和可扩展性。该架构的灵活性使其能够适应各种系统规模,同时保持高效率和无死锁运行。
结果表明,这种方法在大规模系统中特别有效,网络直径减小和带宽利用率提高的优势更加明显。该方法为构建具有最佳通信能力的新一代多chiplet系统提供了实用框架。
参考文献
[1] Y. Feng, D. Xiang, and K. Ma, "A Scalable Methodology for Designing Efficient Interconnection Network of Chiplets," in 2023 IEEE International Symposium on High-Performance Computer Architecture (HPCA), Seoul, Korea, Republic of, 2023, pp. 1059-1071, doi: 10.1109/HPCA56546.2023.10070981.
 微信公众号
 bilibili
 微信视频号