


核心架构进展
AI加速器的基础架构经过多代硬件实现已显著发展。现代加速器采用张量核心、高带宽存储器和专用互连的复杂组合。架构通常采用分层存储系统,具有多级缓存以优化数据移动并减少能耗。
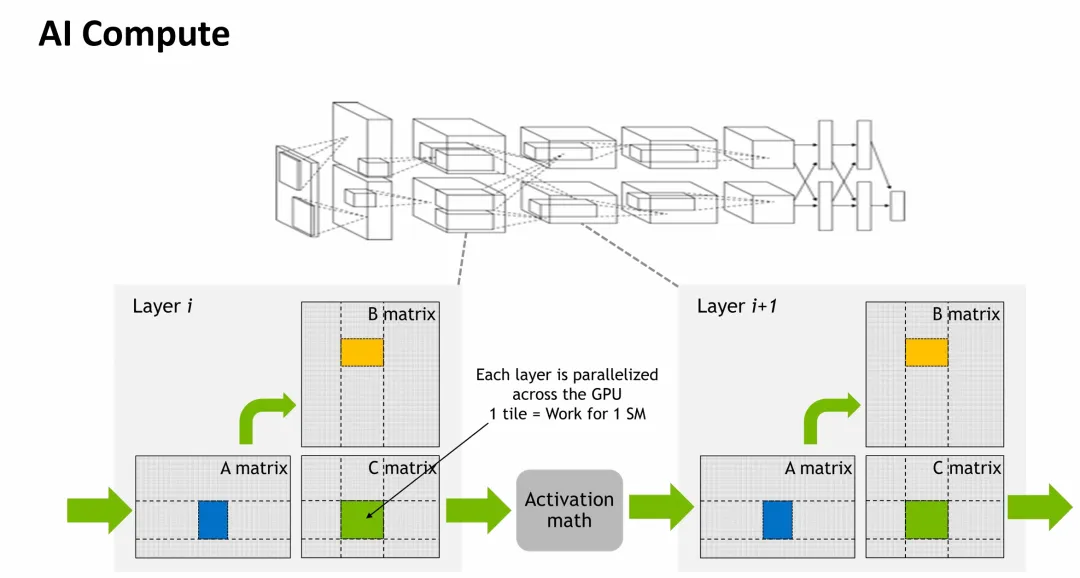
图1:矩阵乘法流水线和多个处理单元的激活函数的AI计算架构详细分解图。
这些加速器的计算核心基于张量核心架构。这些核心专为混合精度矩阵运算设计,实现FP16和INT8计算路径。最新一代的张量核心(如NVIDIA Blackwell中使用的)采用微张量缩放浮点格式,在保持数值稳定性的同时实现更高效的计算。
先进的量化技术
量化已成为AI加速器的关键优化技术。VS-Quant(向量缩放量化)方法在这个领域代表了重要进展。该技术采用两个不同的缩放因子:
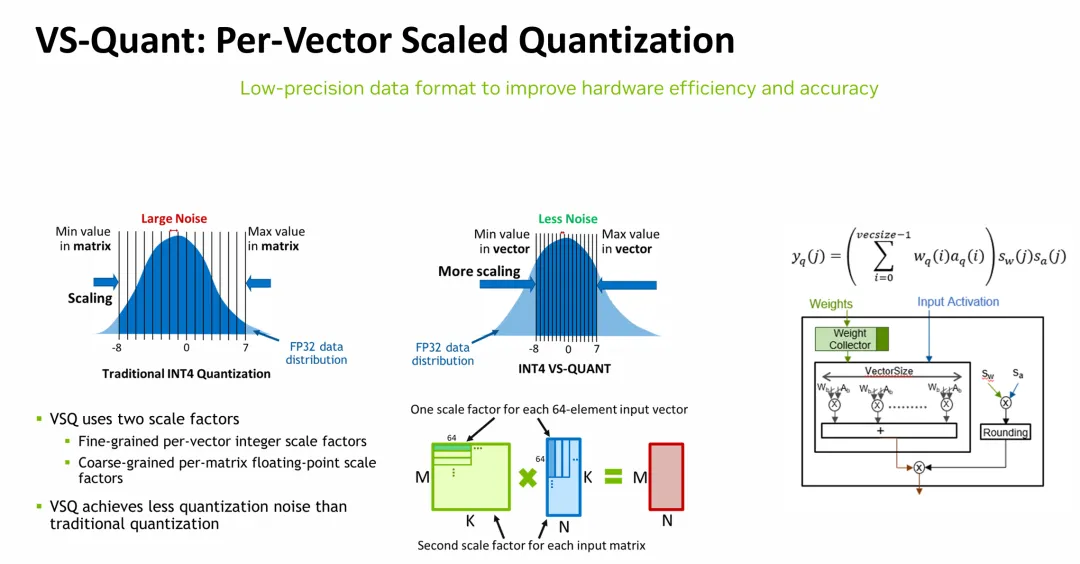
图2:VS-Quant架构展示了细粒度每向量整数缩放因子和粗粒度每矩阵浮点缩放因子的双缩放因子方法。
实现使用细粒度每向量整数缩放因子,结合粗粒度每矩阵浮点缩放因子。这种双缩放方法与传统方法相比显著降低了量化噪声。VS-Quant的数学基础可以表示为:
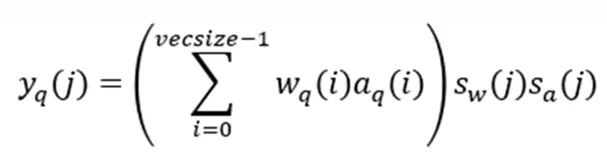
其中wq和aq表示量化权重和激活,而sw和sa是相应的缩放因子。
存储系统架构
现代AI加速器的存储层次结构实现了复杂的多级系统。在最高层,HBM3e存储器提供高达8 TB/s的带宽。存储系统包括:
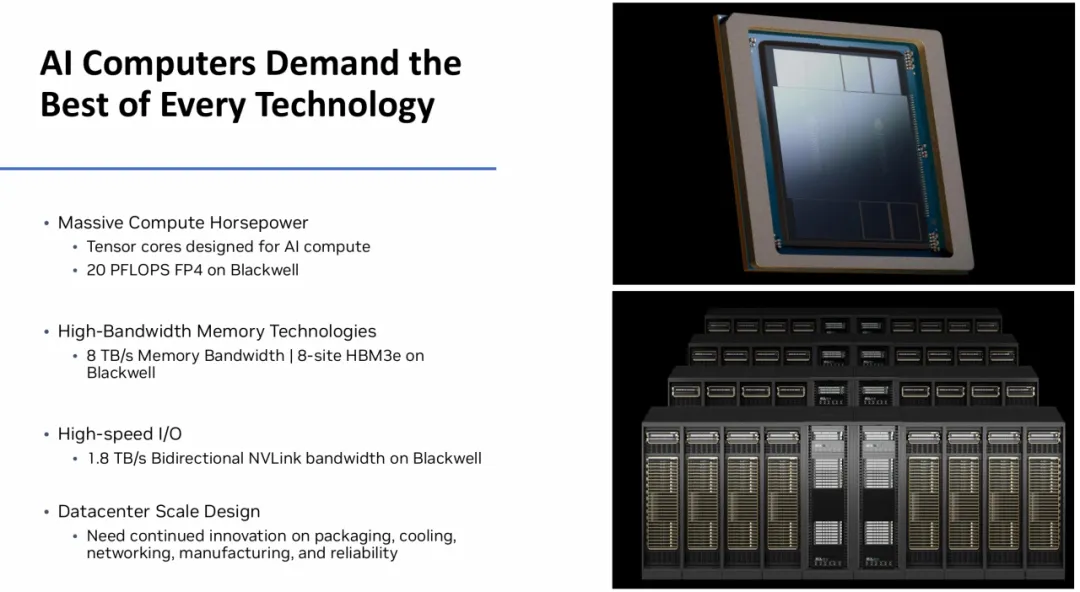
图3:HBM3e和片上存储系统集成的AI加速器存储层次结构详细视图。
内部存储架构使用多级缓存,具有专用的权重和激活暂存存储器。这种层次结构方法最大限度地减少了数据移动,这占系统能耗的很大一部分。通过精心编排数据移动模式,近期实现已接近理论极限的存储带宽效率。
并行化和扩展
现代AI加速器在多个维度实现了复杂的并行化策略。3D并行方法结合了:
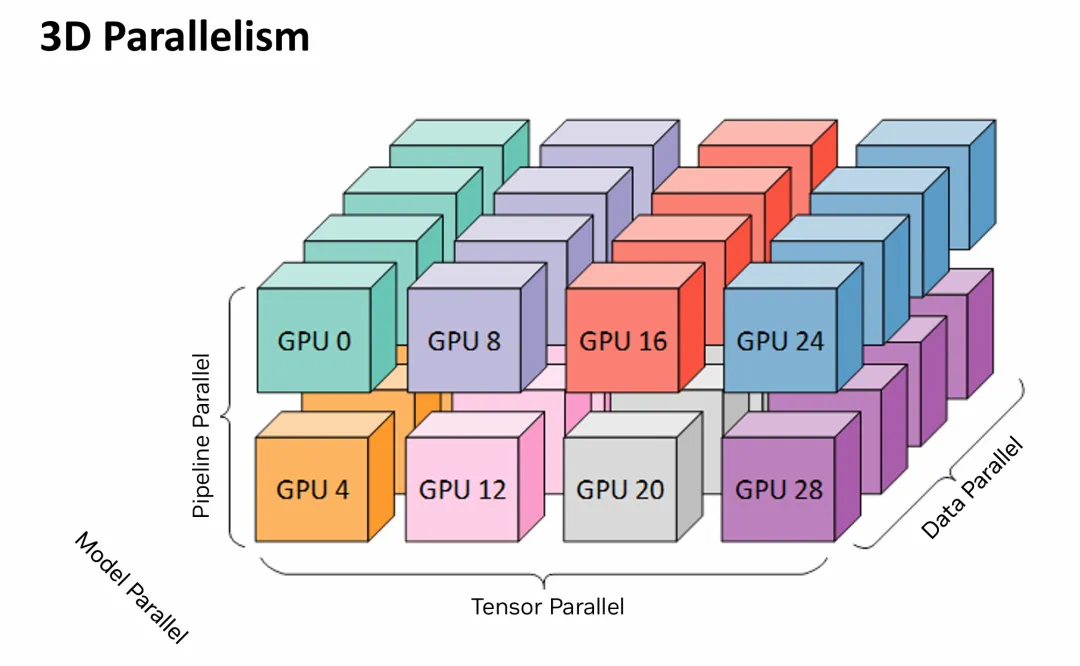
图4:张量、流水线和数据并行执行模式之间交互的3D并行化图示。
张量并行维度将单个操作分散到多个处理单元。流水线并行将神经网络分段到不同的加速器单元,而数据并行在多个设备上复制模型。这种多维方法实现了对非常大模型规模的高效扩展。
功率和热管理
随着AI加速器突破硅技术边界,先进的功率管理变得极其重要。现代设计实现细粒度功率门控和动态电压频率调节。热设计必须处理超过400W/cm²的功率密度,需要复杂的散热解决方案。
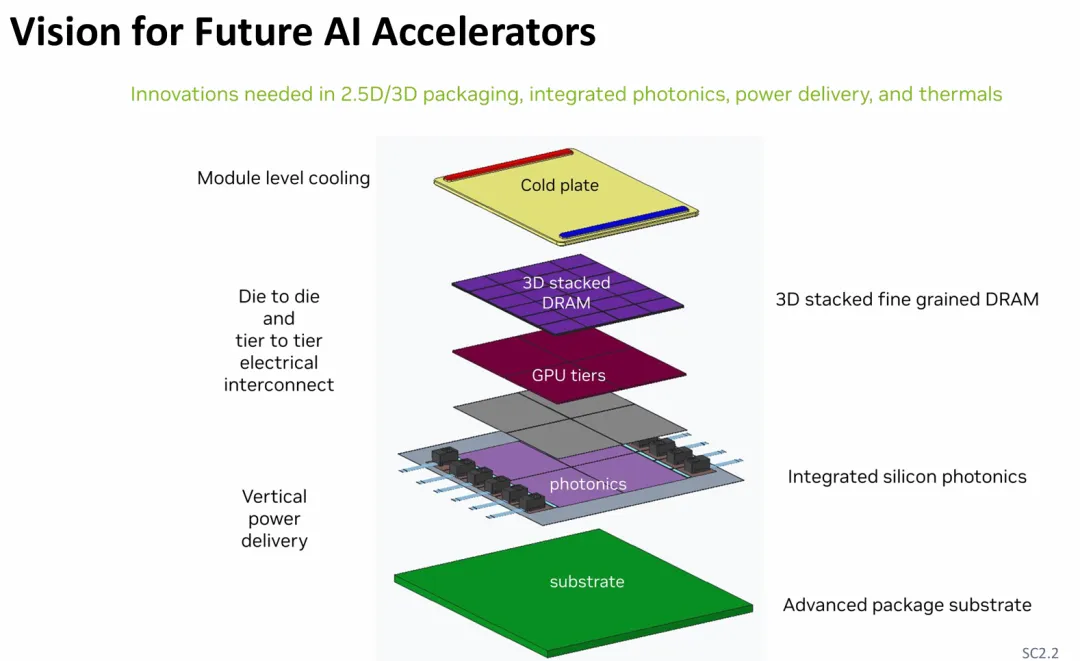
图5:先进热管理系统和供电网络集成的下一代散热和供电架构。
电源分配网络实现多层优化,包括:
改进的封装基板设计,用于提高电流传输
集成电压调节器,用于降低功率分配损耗
先进的导热界面材料,用于增强散热
下一代技术
AI加速器的未来在于多项新兴技术的集成。硅基光电子集成提供了显著提高互连带宽和能效的潜力。这些技术的实现需要仔细的协同设计,先进的封装技术将实现异构芯片技术的集成,将高性能逻辑与密集存储结构相结合。这些组件的垂直集成需要复杂的热管理和供电解决方案。
性能扩展和效率
AI加速器的性能演进显著,过去十年显示出指数级的改进:
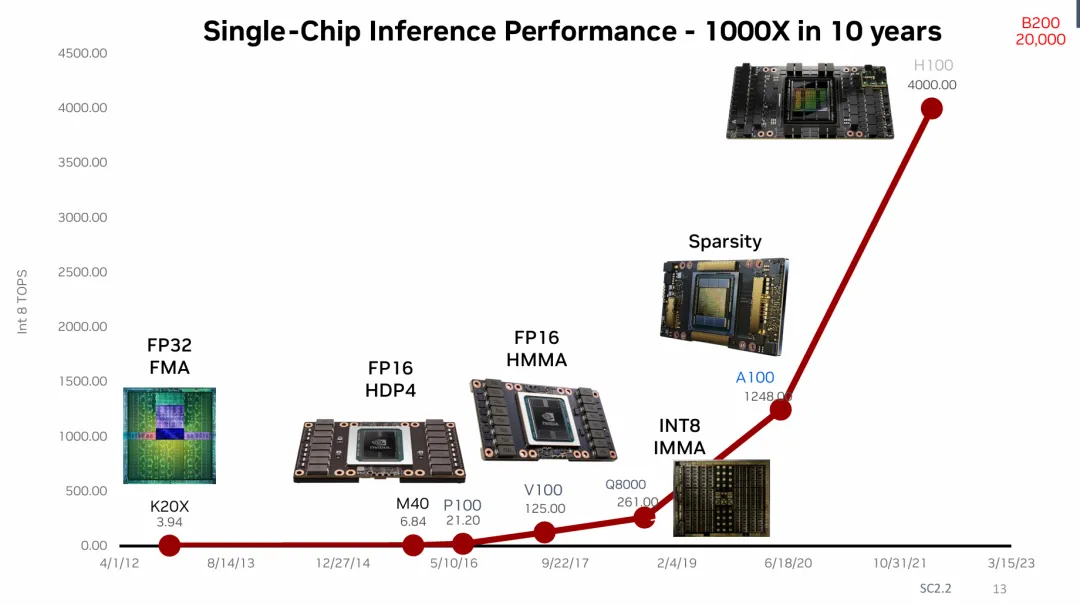
图6:展示从早期实现到当前最先进设计的AI加速器性能演进图。
近期实现已在INT8运算中实现超过95 TOPS/W的计算效率。这种效率通过硬件和软件的精心协同优化实现,包括先进的量化技术和复杂的工作负载调度算法。
结论
AI加速器硬件通过多项技术创新的集成持续进步。先进架构、复杂量化技术和新兴制造技术的结合实现了持续的性能扩展。未来发展需要从器件物理到系统架构的多个领域进行精心协同优化,以保持当前的性能提升轨迹。
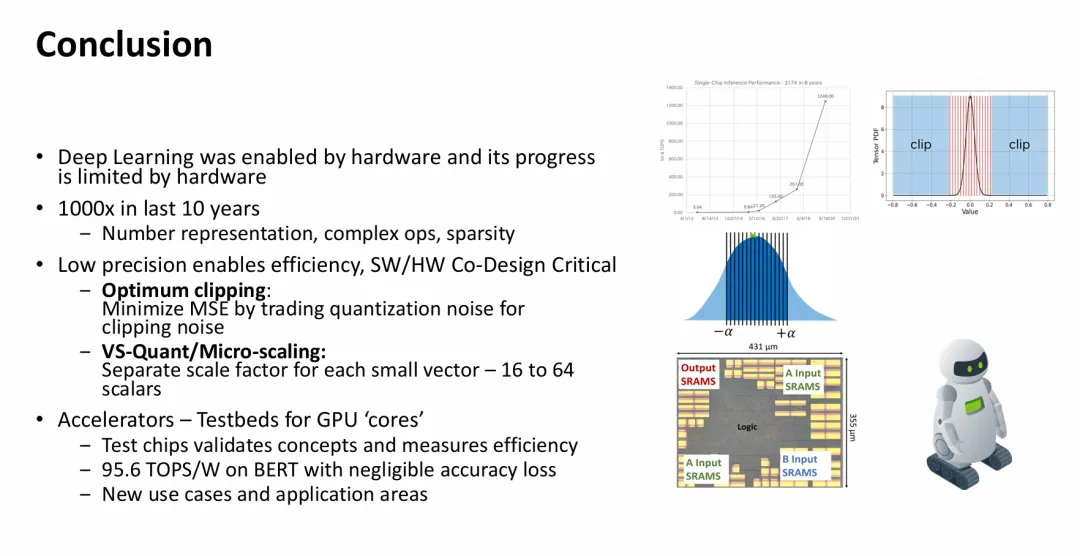
图7:总结AI加速器发展中的关键技术进展和未来挑战。
参考文献
[1] B. Khailany, "AI Accelerator Hardware Trends and Research Directions," in IEEE International Electron Devices Meeting (IEDM) Short Course, SC2.2, Dec. 2024.
END
 微信公众号
 bilibili
 微信视频号