随着人工智能(AI)应用日益普及,推动着全球经济的发展并影响着社会,对更大型、更高效的机器学习(ML)模型的需求也在迅速增长。为了加速这些人工智能工作负载,未来的计算结构必须以指数级方式扩展 I/O 带宽,实现更长距离的传输以支持更大的加速器集群,并实现更高效的资源利用架构,如GPU 分解和内存池。使用铜线的传统电气 I/O 可以提供高带宽密度和低功耗,但只能在 1 米左右的极短距离内实现。目前的可插拔光收发器可以提高传输距离,但其成本和功耗水平无法满足人工智能所需的大规模扩展。英特尔开发了革命性的解决方案--光计算互连(OCI)芯片组 [1] 。OCI chiplet 英特尔的 4 Tbps 双向 OCI chiplet 是基于其内部硅基光电子技术的完全集成的光 I/O 解决方案。它包括1. 集成了激光器的硅基光电子芯片 (PIC)
2. 带有射频硅通孔(TSV)的电子集成电路
3. 集成可拆卸/可重复使用光学连接器的路径
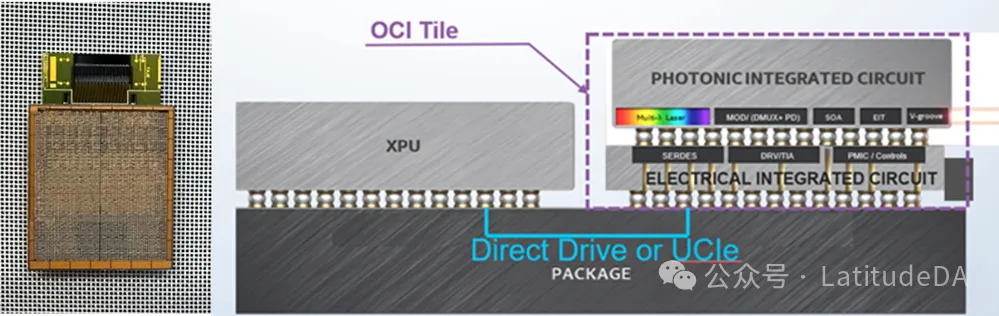 图 1. 英特尔 4 Tbps 光计算互联(OCI)芯片组
该 OCI 芯片可与下一代 CPU、GPU、IPU 和其他高带宽 SOC 共同封装。首个实施方案可提供:- 4 Tbps 双向带宽(与 PCIe Gen5兼容)- 64 个通道,每个方向 32 Gbps数据传输速率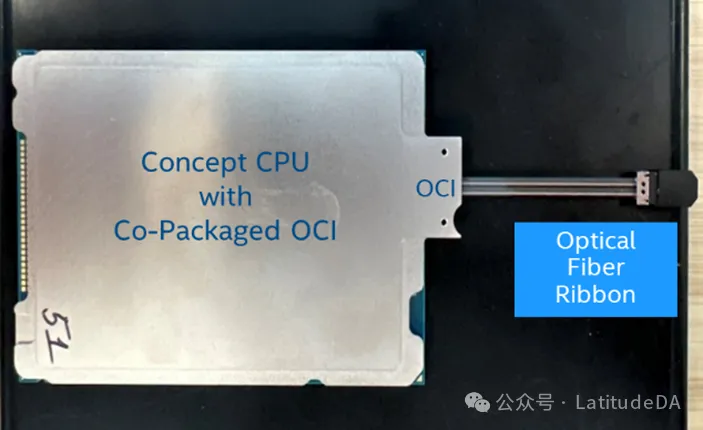 图 2. 采用联合封装 OCI 的概念英特尔 CPU
在 OFC 2024 上,英特尔展示了第一代 OCI 芯片组,与英特尔 CPU 原型共同封装,通过光纤运行实时、无差错的流量。该平台的路线图是实现 32 Tbps OCI 芯片。硅基光电子技术创新 OCI芯片组的核心是英特尔开创性的硅基光电子技术。通过集成以下功能,单个 PIC 可支持高达 8 Tbps 的双向带宽: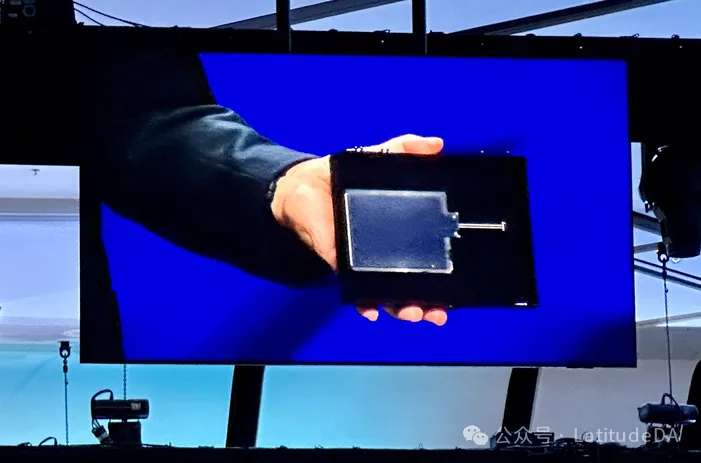 图 3. OCI 发射器: 一根标准单模光纤上 8 个波长的光学光谱
与传统的 InP 激光器相比,这种集成方法的可靠性要高出几个数量级。英特尔已经出货了 800 多万个这样的 PIC,在用于数据中心网络的可插拔光收发器中集成了 3200 万个激光器。OCI 的一个主要优势是使用标准的、广泛部署的单模光纤 (SMF-28),而不是偏振保持光纤 (PMF),后者因振动/光纤移动问题影响性能而很少部署。实现无处不在的人工智能 通过结合英特尔在芯片、光学、封装和平台集成方面的优势,OCI 芯片组提供了一个完整的下一代计算解决方案。其前所未有的带宽、效率、覆盖范围和可扩展性将通过以下方式帮助实现无处不在的人工智能:OCI 充分体现了英特尔如何在整个计算堆栈中提供创新技术,推动人工智能的未来发展。人工智能的指数级增长需要革命性的互连解决方案,而 OCI 正是英特尔的开创性解决方案。[1] C. Urricariet,"英特尔®在OFC2024上展示了与CPU共同封装的OCI光I/O Chiplet,目标是爆炸性的人工智能扩展",英特尔社区,2024年3月21日。[在线]。可登录 https://community.intel.com/t5/Blogs/Tech-Innovation/Artificial-Intelligence-AI/Intel-Shows-OCI-Optical-I-O-Chiplet-Co-packaged-with-CPU-at/post/1582541。


 微信公众号
 bilibili
 微信视频号