ISSCC2024|AMD报告基于硅基光电子技术的光收发器以及光电融合设计
人工智能(AI)模型的指数级增长推动了对超高带宽、低功耗、低延迟和长距离数据链路的需求。如图 1 所示,最大人工智能模型的规模大约每 4 个月翻一番。急剧的扩展需要高度并行和分布式计算架构来处理巨大的计算需求。由于信号完整性问题,传统的电气链路在数据传输速率超过 100 Gbps 时面临严重的传输距离限制,从而导致成本上升。硅基光电子技术可实现高性能、高能效的光收发器,并可与人工智能加速器芯片集成在同一封装内,从而提供了极具吸引力的解决方案。在IEEE国际固态电路会议 (ISSCC)上,来自AMD的Mayank Raj博士报告Silicon Photonics-Based High-Throughput Optical Transceivers,让我们来领略其内容。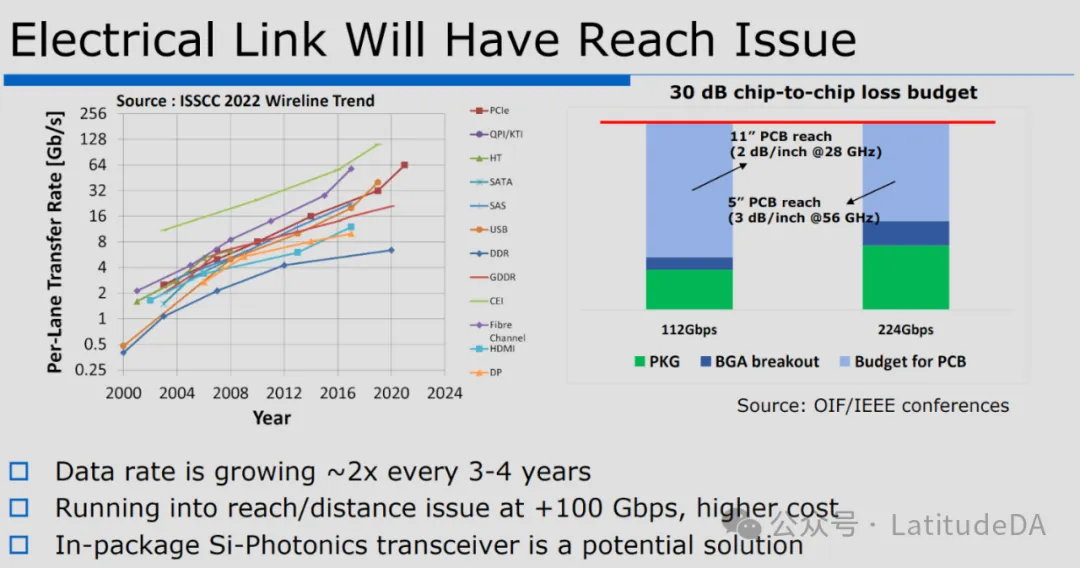 图 1. 电连接将出现的问题
硅基光电子技术利用成熟的 CMOS 制造工艺,将调制器、波导和光电探测器等光子器件集成到硅基板上。与传统的电子信号相比,这种技术具有以下优势:1.更高的带宽密度:硅波导可通过波分复用(WDM)支持多种波长,从而在单根光纤内实现每秒百万兆位的总带宽。2.功耗更低:与电子链路相比,光链路每比特的功耗更低,尤其是在数据传输速率更高、传输距离更长的情况下。3.减少信号完整性问题:光信号不受电磁干扰和串扰的影响,无需复杂的均衡技术即可实现长距离无差错传输。4.无缝集成:硅基光电子器件可与 CMOS 电路进行单片集成,从而在与处理芯片相同的封装内实现紧凑、高性能的收发器。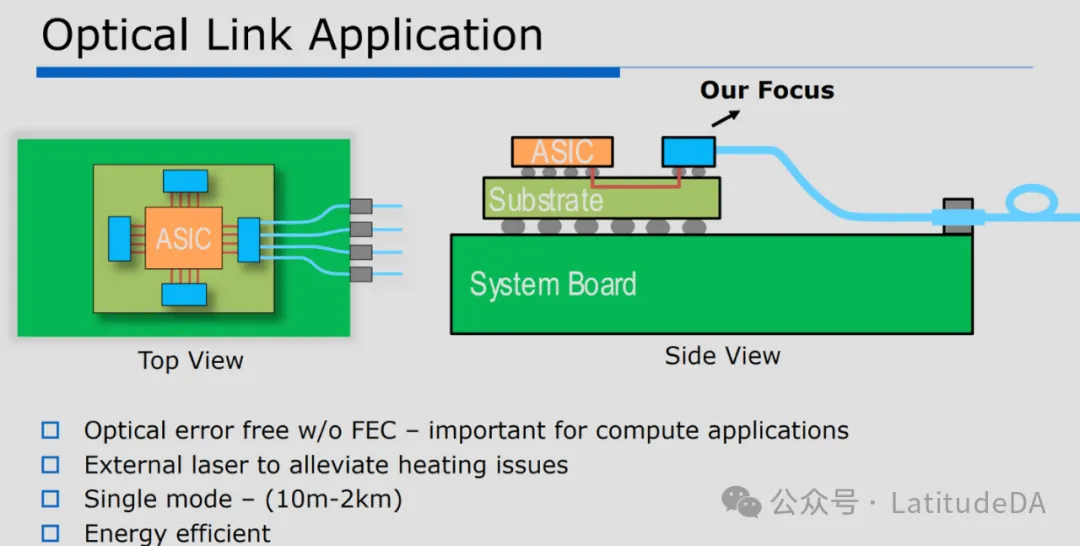 图 2. 光链路应用
对于人工智能应用,基于硅基光电子技术的光链路的目标规格非常严格。所需的总带宽超过 10 Tbps,能效目标为 2.5 pJ/bit。边缘带宽密度应大于 1 Tbps/mm,以实现紧凑的外形尺寸。此外,比特误码率 (BER) 必须保持在 1e-12 以下,以确保在无前向纠错 (FEC) 的情况下无差错运行。光子集成电路的关键构件是用于发射器(TX)的微环调制器(MRM)和用于接收器(RX)的级联环谐振器(CRR)滤波器。图 3 展示了 PIC 架构,其特点是在六个组中每个组有 16 个波长,波长间距为 1.5 nm,总共可提供 96 个波长。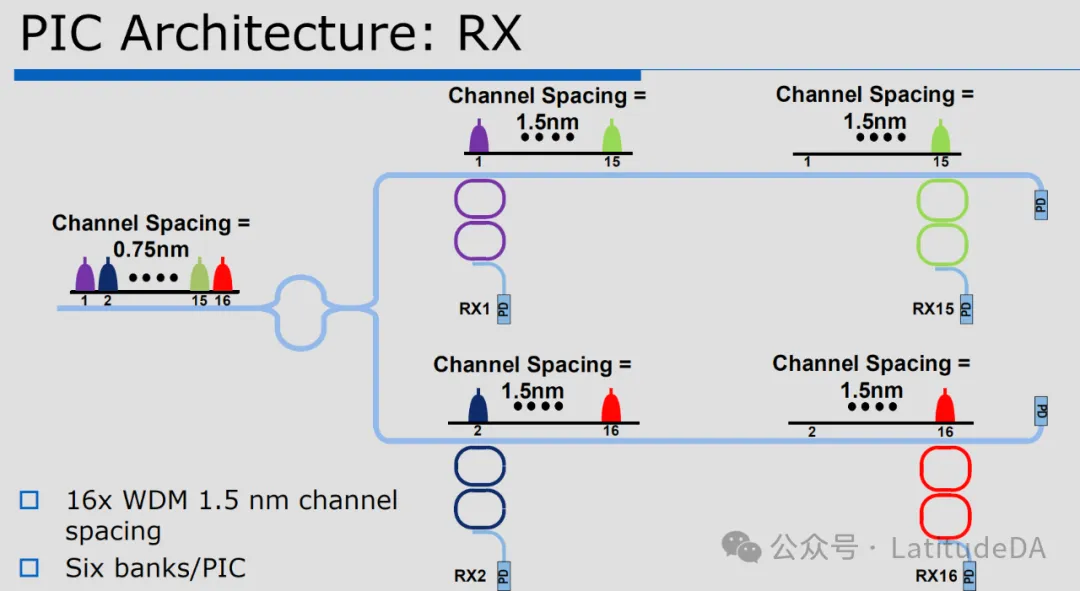 图 3. PIC 架构: RX
MRM 是结构紧凑的高能效调制器,可利用硅中的等离子体色散效应来调制光学相位。如图 10 所示,MRM 由一个与波导耦合的环形谐振器组成。通过改变施加在环上的电压,硅的折射率就会被调制,从而移动谐振波长并调制波导中的光功率。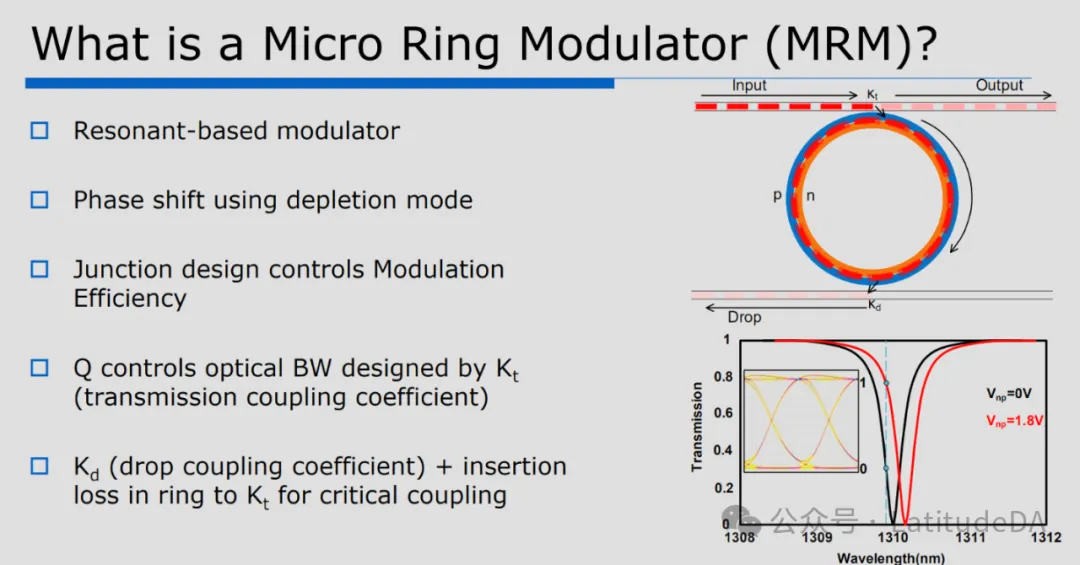 图 4. 微环调制器
微环调制器有两种结点设计:横向和纵向。垂直结点设计能更好地与光学模式重叠,因此调制效率比横向设计高出约 1.5 倍。通过临界耦合设计,使 25% 传输点的斜率最大化,从而优化了 MRM 的传输函数。这样就能在给定波长偏移的情况下最大限度地提高光调制幅度(OMA)。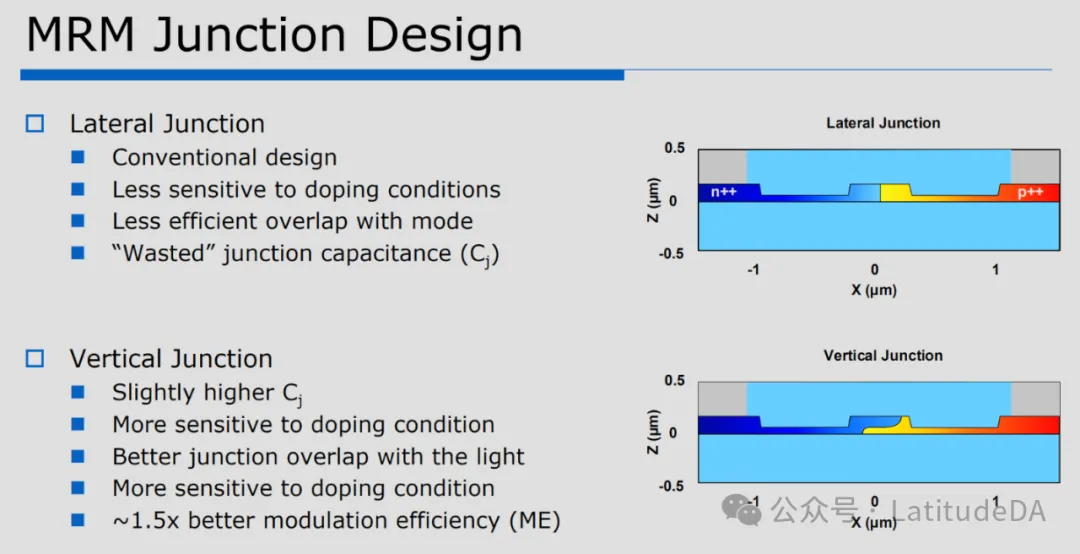 图 5. MRM junction设计
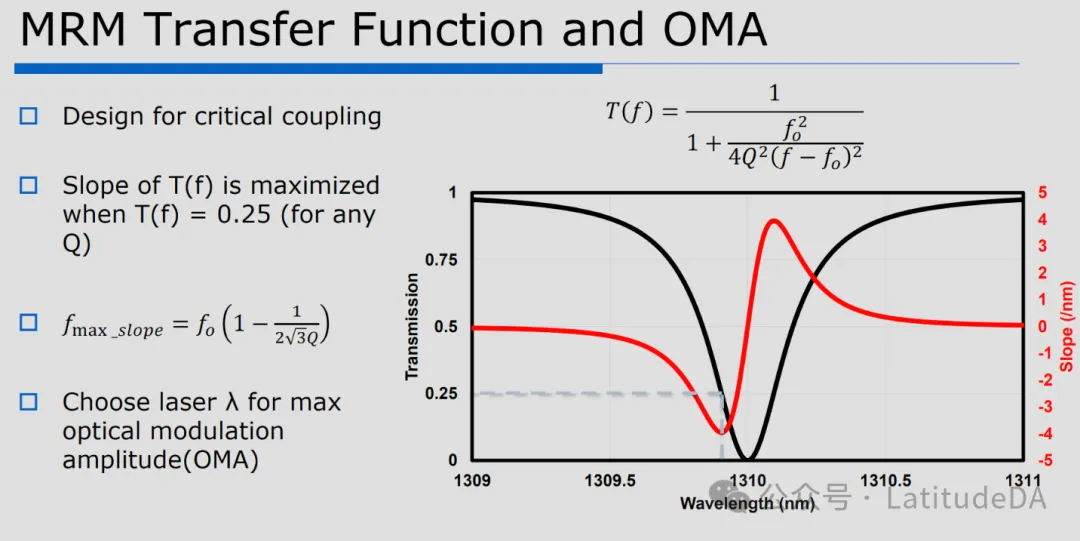 图 6. MRM 传输函数和 OMA
为了补偿工艺变化和温度波动,采用了加热器环路来稳定 MRM 的谐振波长。如图 9 所示,反馈回路通过跟踪端口功率下降来调整加热器电流,以保持所需的 OMA。RX 路径中的 CRR 滤波器充当 WDM 解复用器,将输入波长分离到各个光电探测器上。如图 7 和图 8 所示,与单环谐振器相比,CRR 的通带更平坦,通道隔离度更高(>40 dB/衰减),对波长偏差的容差也更大。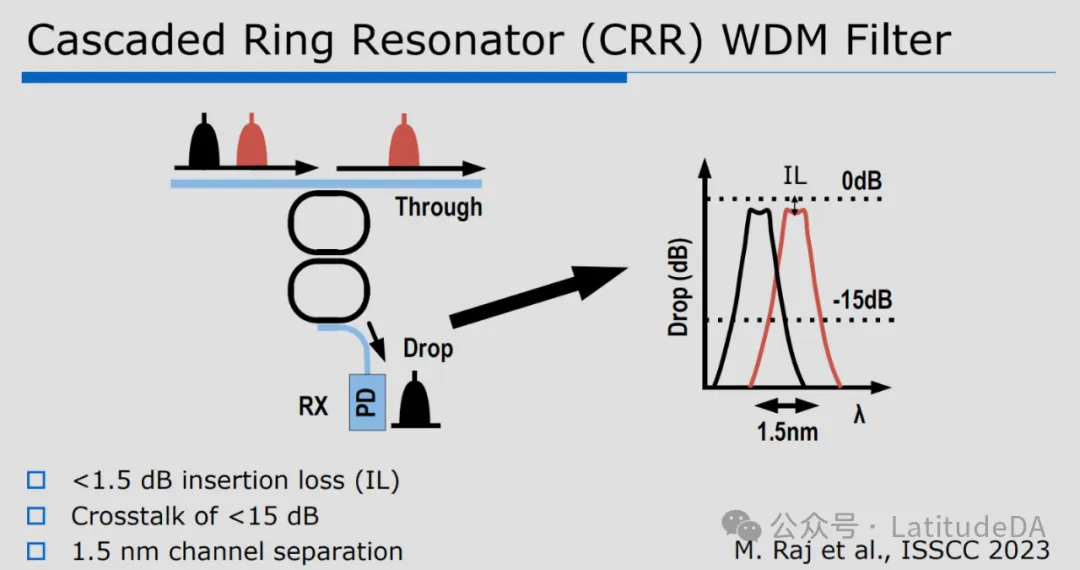 图 7. CRR 波分复用滤波器
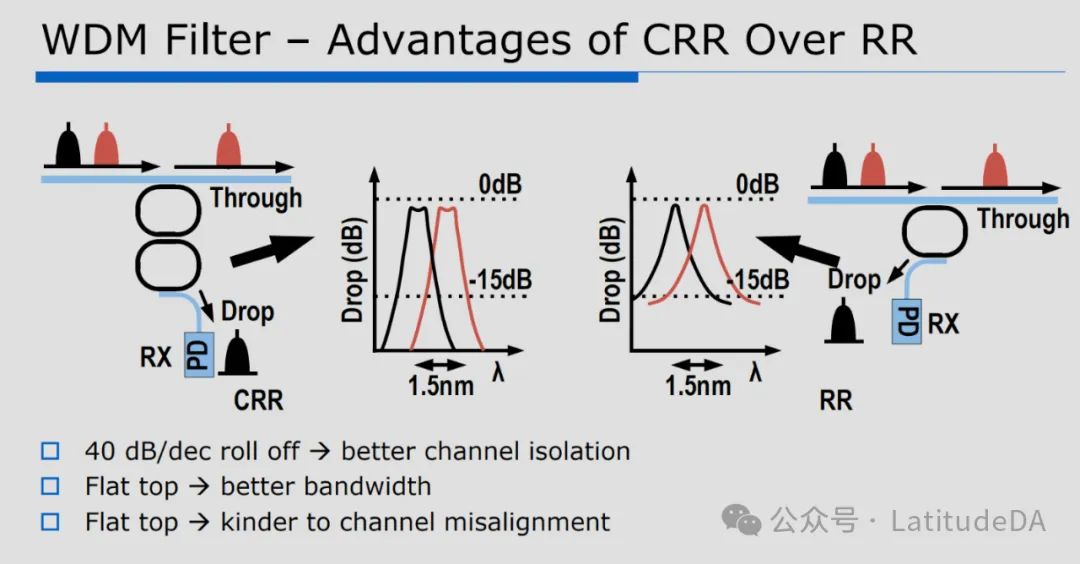 图 8. 波分复用滤波器 - CRR 相对于 RR 的优势
与 MRM 类似,CRR 滤波器也采用了加热器环路,以在工艺变化和温度变化时稳定滤波器特性。然而,由于滤波器的形状更为复杂,因此需要对每个 CRR 进行单独调整,如图 9 所示。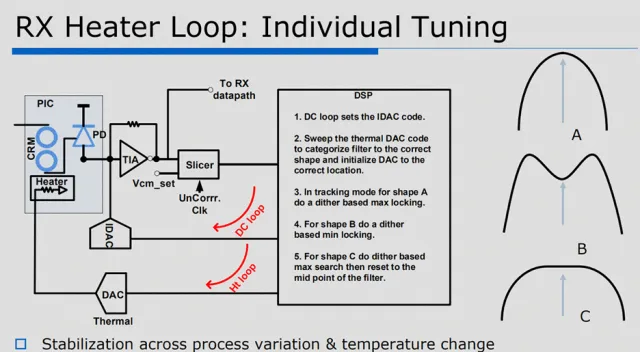 图 9. RX 加热器回路
为提高制程均匀性,CRR 滤波器采用了赛道设计,允许更宽的耦合间隙和垂直间隔,以控制通道间距,如图 10 所示。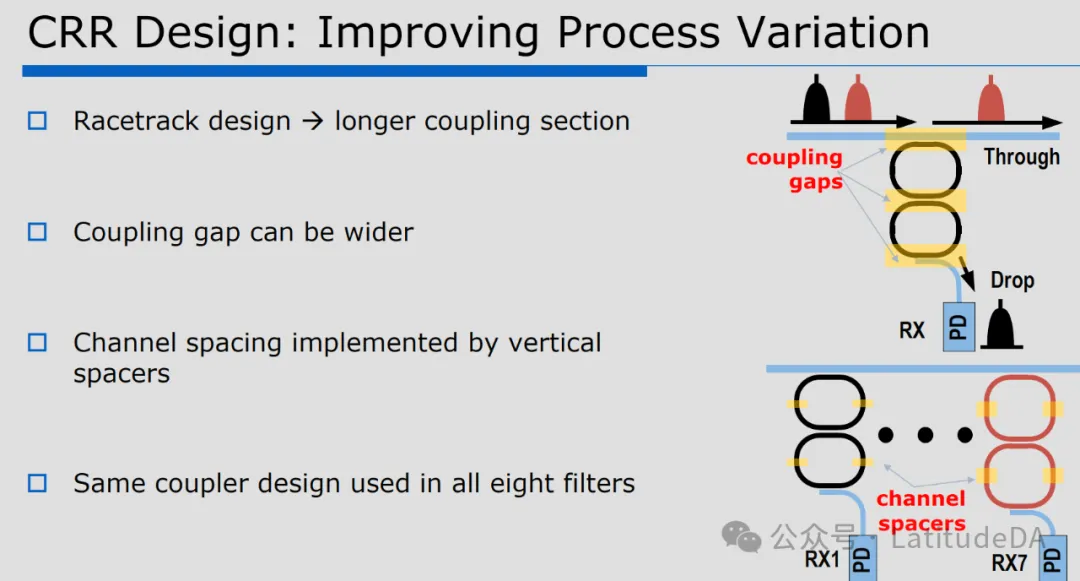 图 10. 用于改善工艺变化的 CRR 设计
电子集成电路采用 7 纳米 FinFET 工艺制造,包括发射器和接收器电路以及时钟发生和数据恢复模块。一个 EIC 芯片有 48 个发送/接收通道,分为三组,每组 16 个通道,以实现 2.544 Tbps 的总带宽。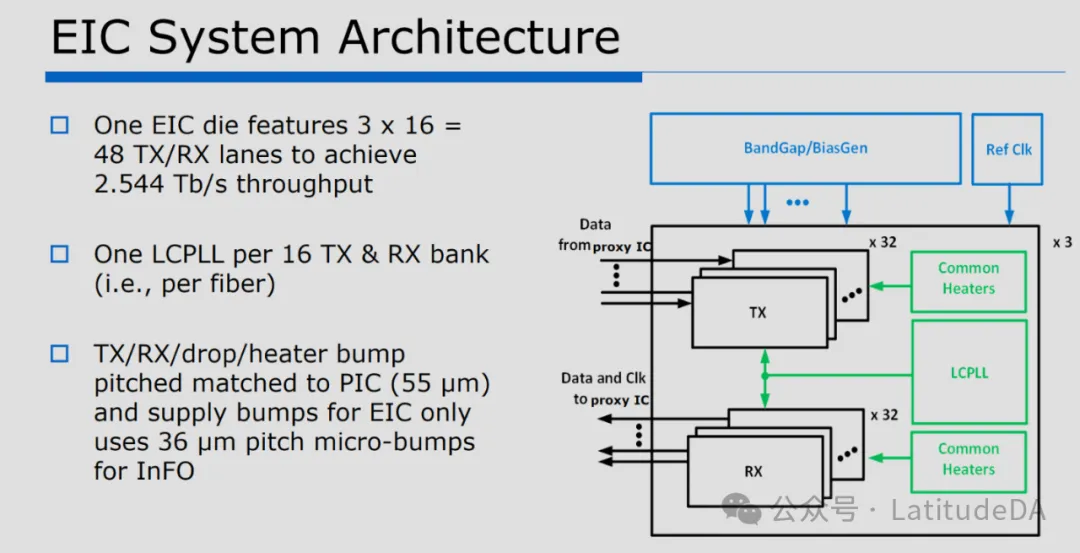 图 11. EIC 系统架构
图 12 所示的发射机输出驱动器采用带 T 型线圈的级联拓扑结构,以提供高频提升并减轻自负载效应。图 25 所示的 T 型线圈结构是通过堆叠顶部的两个金属层实现的,可达到约 90 千兆赫的高自谐振频率 (SRF) 以及奈奎斯特频率下大于 5 的品质因数 (Q)。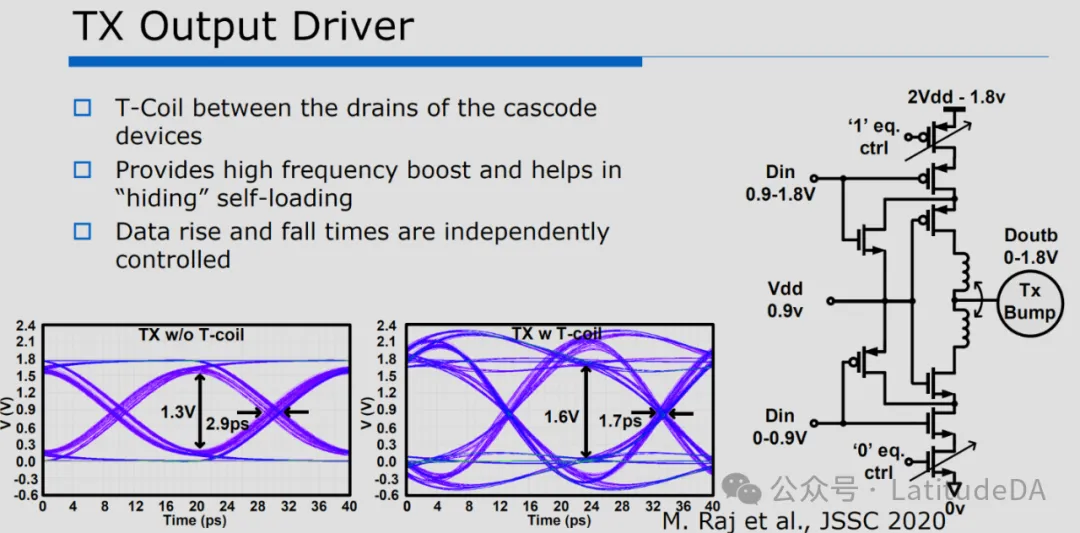 图 12. 发射机输出驱动器
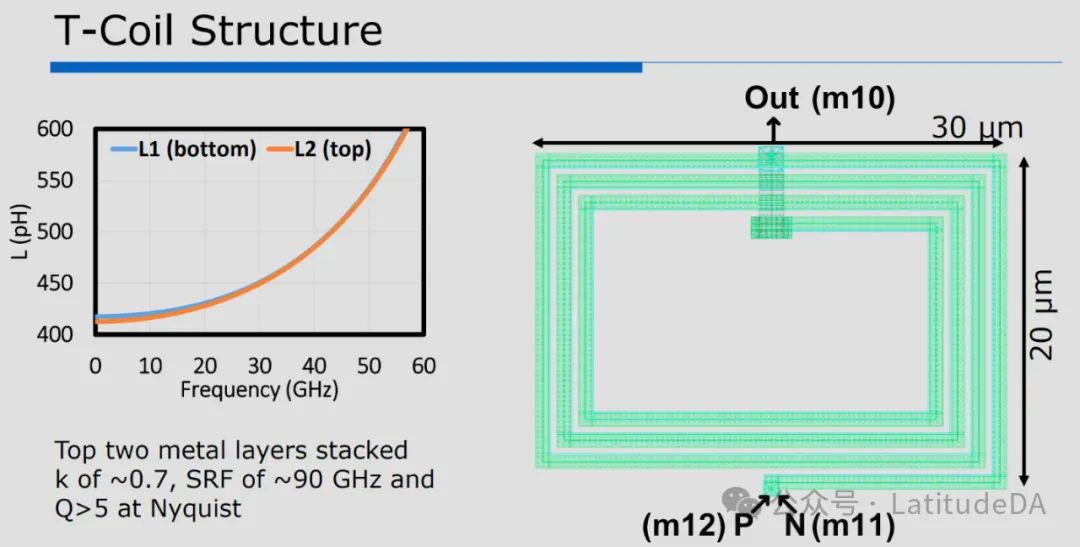 图 13. T 型线圈结构
如图 14 所示,为了适应级联驱动器所需的电压摆幅,使用了基于锁存器的数据电平转换器,将逻辑电平从 0-0.9V 上移到 0.9-1.8V。与无源交流耦合不同,这种交流耦合锁存器解决方案对与代码无关的延迟 (CID) 不敏感,并提供了一个存储元件。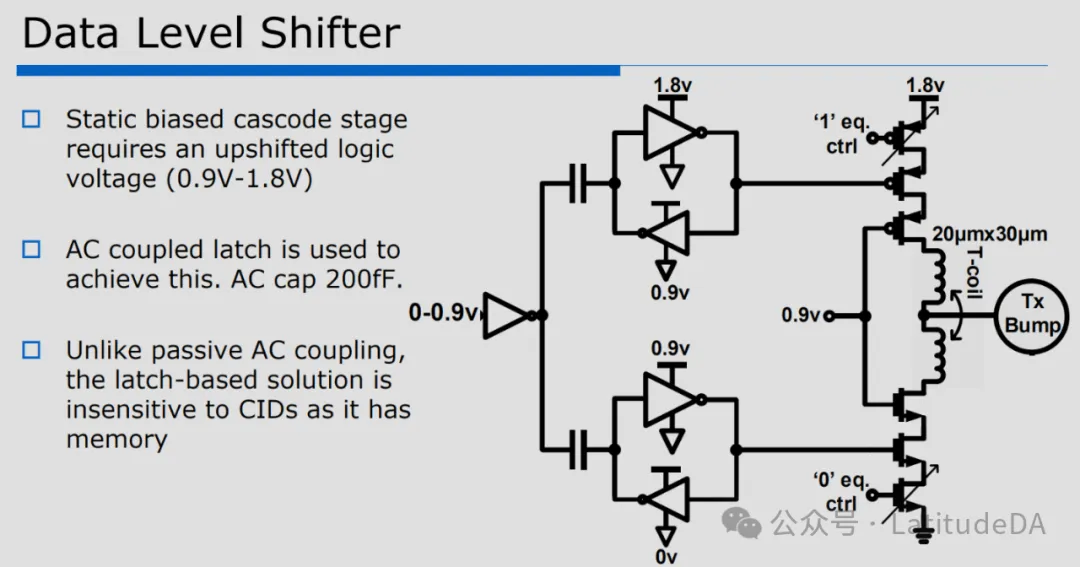 图 14. 数据电平转换器
发射机架构还包括 128:1 串行器、PRBS 发生器和可编程子 UI 预加重,以补偿信道损耗和反射。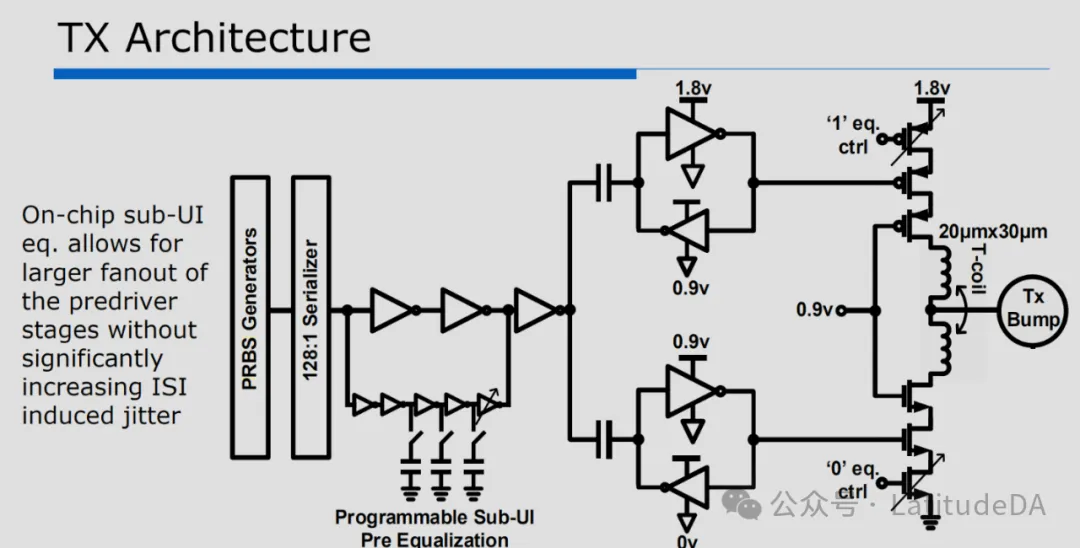 图 15. 发射机架构
如图 16 所示,RX 采用基于反相器的单端互阻抗放大器 (TIA),利用 gm/C 缩放实现低噪声和高带宽。T 型线圈用于提供峰值并减少增益级数,从而节省功耗。基于 NMOS 的可编程电阻器可实现增益和带宽调整。 图 16. TIA 架构
为了最大限度地降低噪声,通过使用基于波导的光电探测器和避免在凸点下进行电网布线,减少了输入电容 (Cin)。如图 17 所示,TIA 采用 0.9V 的低电源电压,在不显著增加 Cin 的情况下提高了跨导 (gm)。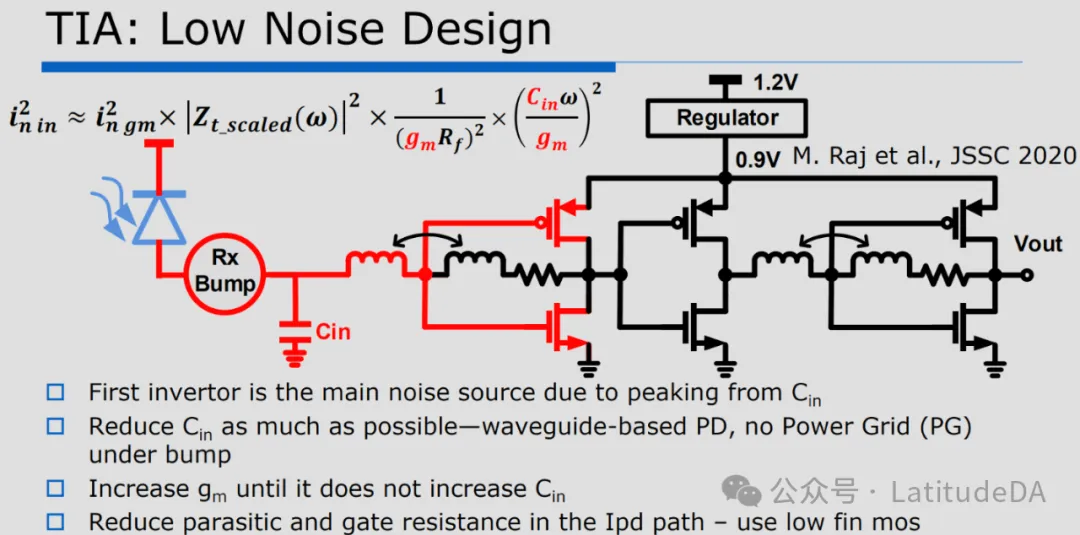 图 17. TIA: 低噪声设计
如图 18 所示,带有直流回路和共模发生器的稳压电源提高了差分电源抑制比 (PSRR)。TIA 输出直接馈送至四个数据切片器和一个误差切片器,共模和输出节点上有回退匹配。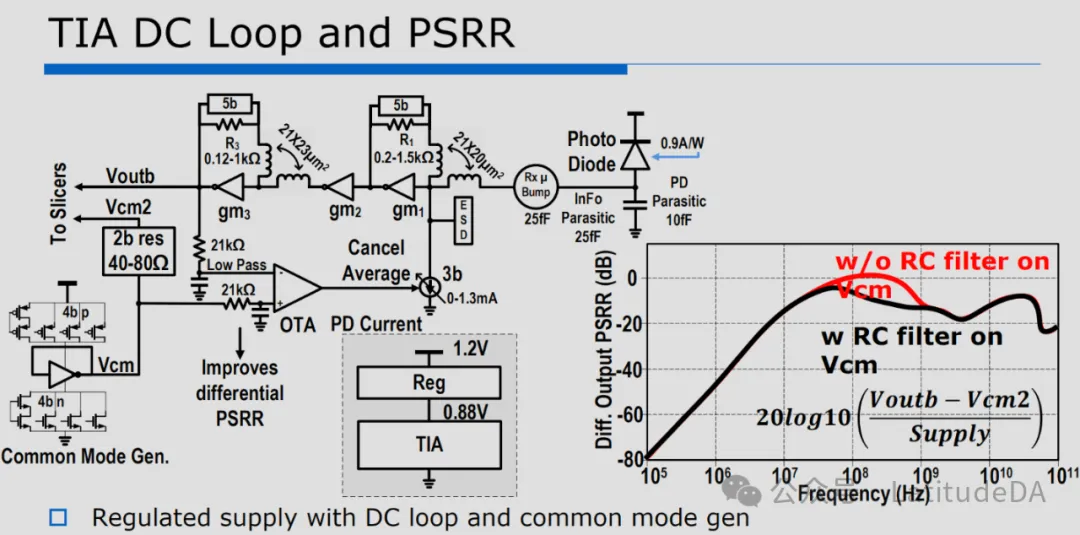 图 18. TIA 直流回路和 PSRR
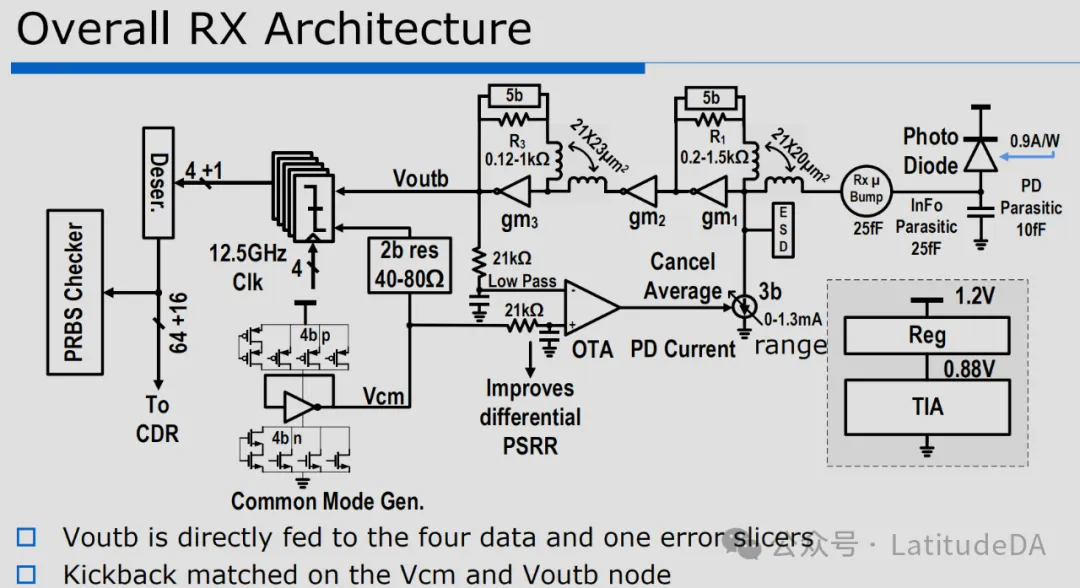 图 19. 整体 RX 架构
如图 20 所示,EIC 采用通用 CDR 架构,以节省功耗和面积。参考通道跟踪百万分之一 (ppm) 的变化,而时间交错 CDR 则更新每个通道的本地偏移。CDR 采用具有 ILO-PI-ILO 拓扑的波特率架构和正交锁定环路 (QLL) 来纠正 I/Q 失配并产生电源电压,如图 21 所示。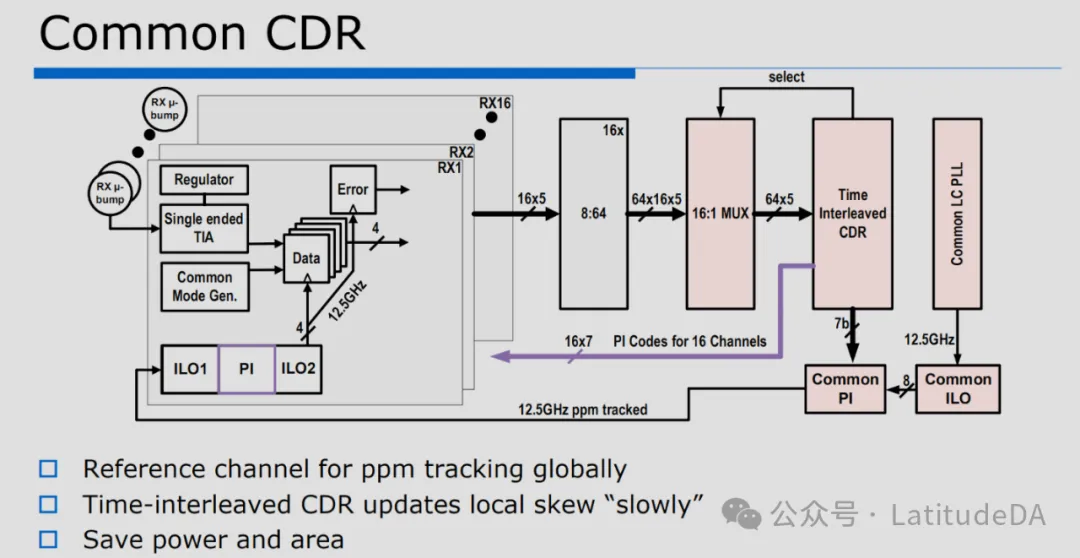 图 20. 通用型的 CDR
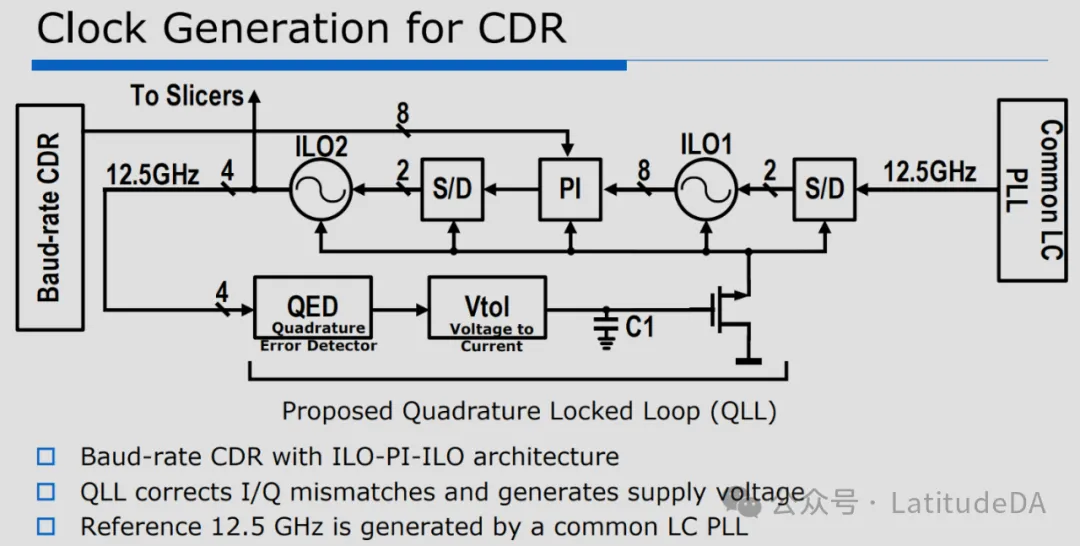 图 21. CDR 时钟生成
硅基光电子收发器采用混合集成方法制造,EIC 采用 7 纳米 FinFET 工艺,PIC 采用 45 纳米 SOI 工艺。图 22 和图 23 显示了芯片显微照片和测量设置。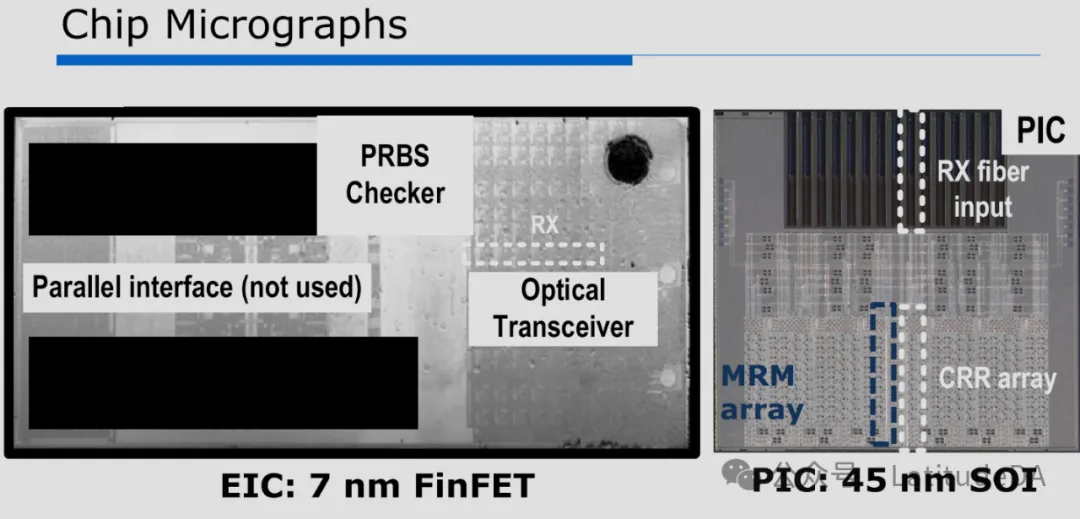 图 22. 芯片显微照片
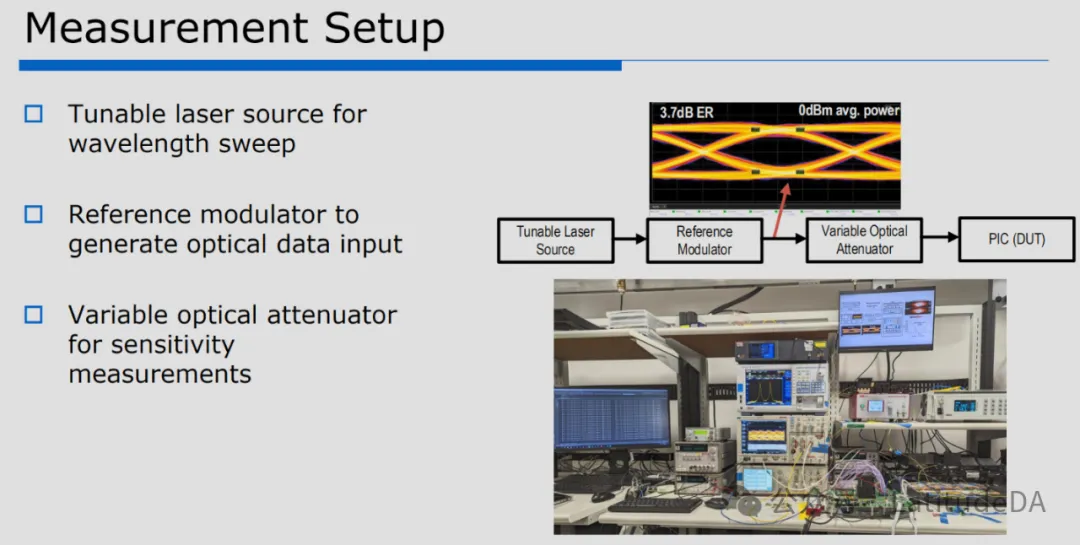 图 23. 测量设置
图 24 所示的 RX 灵敏度测量结果表明,七个 RX 通道的灵敏度中值为 -11.1 dBm OMA。RX4 和 RX1 灵敏度降低的原因是 CRR 滤波器的插入损耗较高。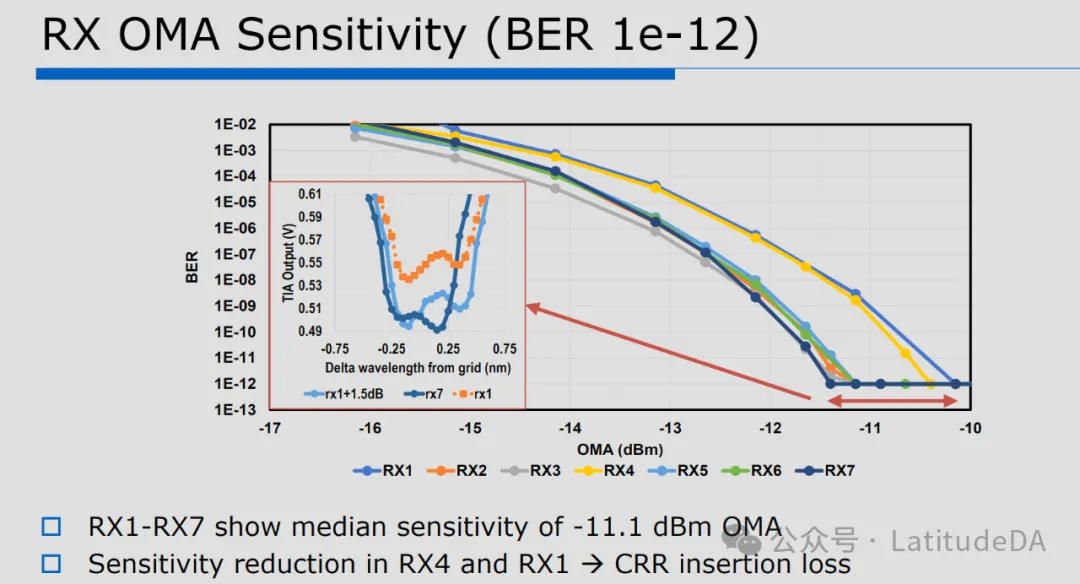 图 24. RX OMA 灵敏度
图 40 所示的误码率浴缸测量结果表明,即使链路裕度为 1 dB,所有七个 RX 信道在没有 FEC 的情况下也能实现无差错运行(误码率 < 1e-12)。如图 25 所示,尽管 RX5 的波长因工艺变化而发生了 200 pm 的偏差,但所有通道的水平和垂直开眼都很正常。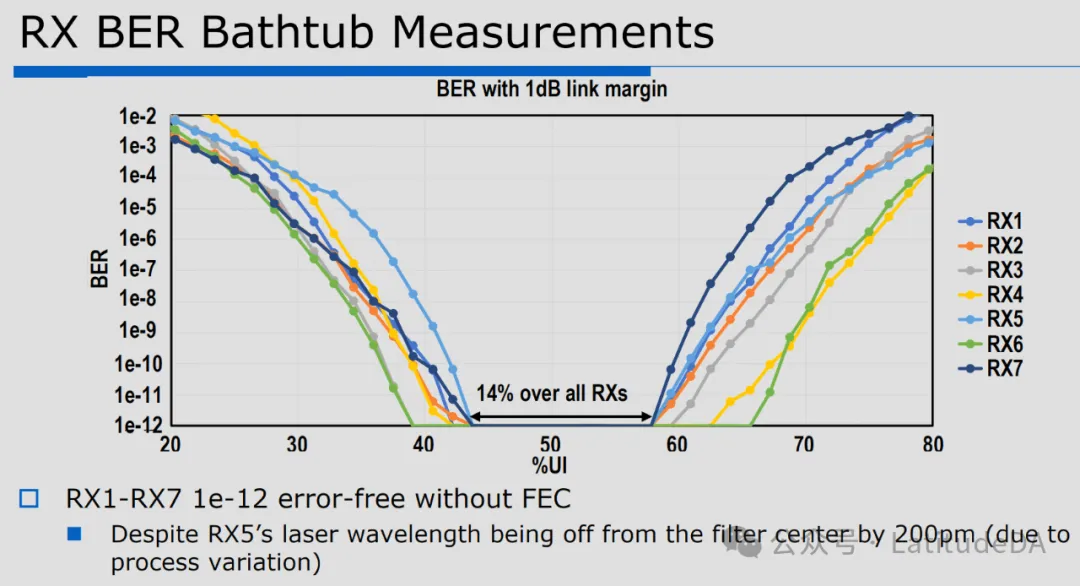 图 25. RX 误码率浴缸曲线测量
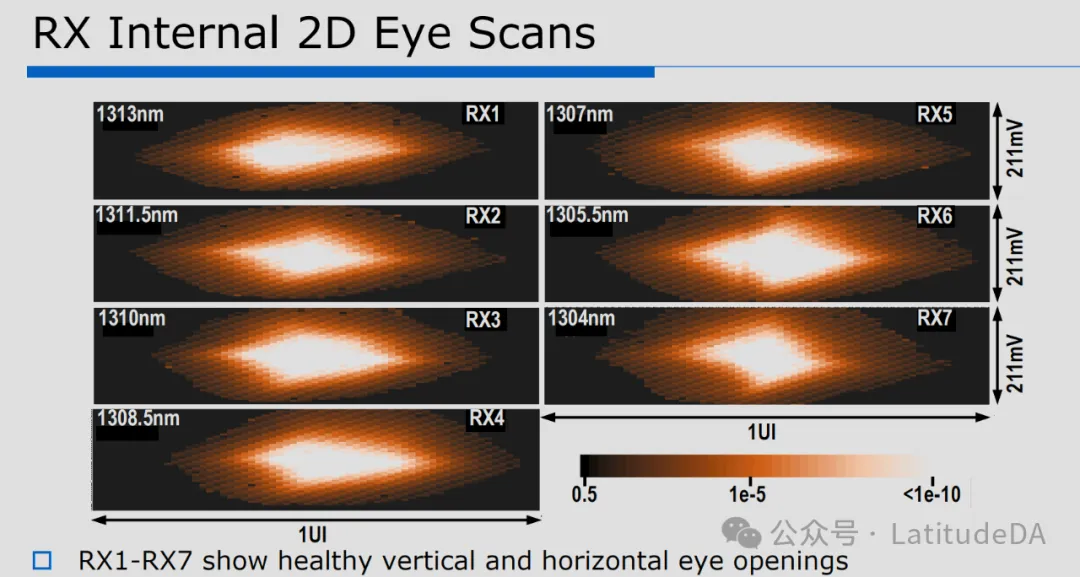 图 26. RX 内部二维眼图扫描
如图 27 所示,相邻通道(RX2 和 RX3)之间的串扰测量显示对垂直和水平眼缘的影响极小。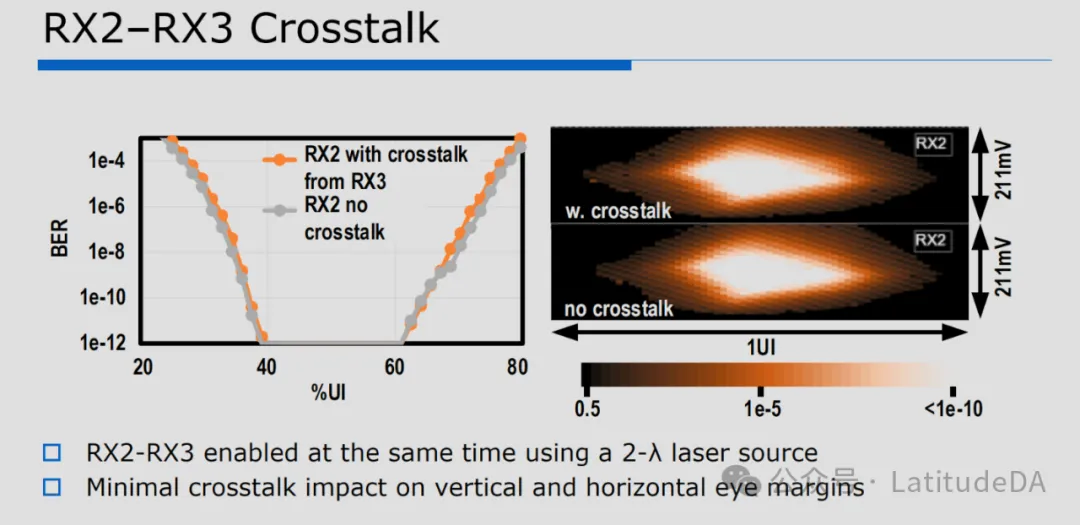 图 27. RX2-RX3 串扰
图 28 显示了 50 Gb/s 速率下的 TX 光眼图,显示了 3 dB 消隐比。图 29 中的完整链路演示展示了利用两个波长在单根光纤上实现 424 Gbps 的无差错运行。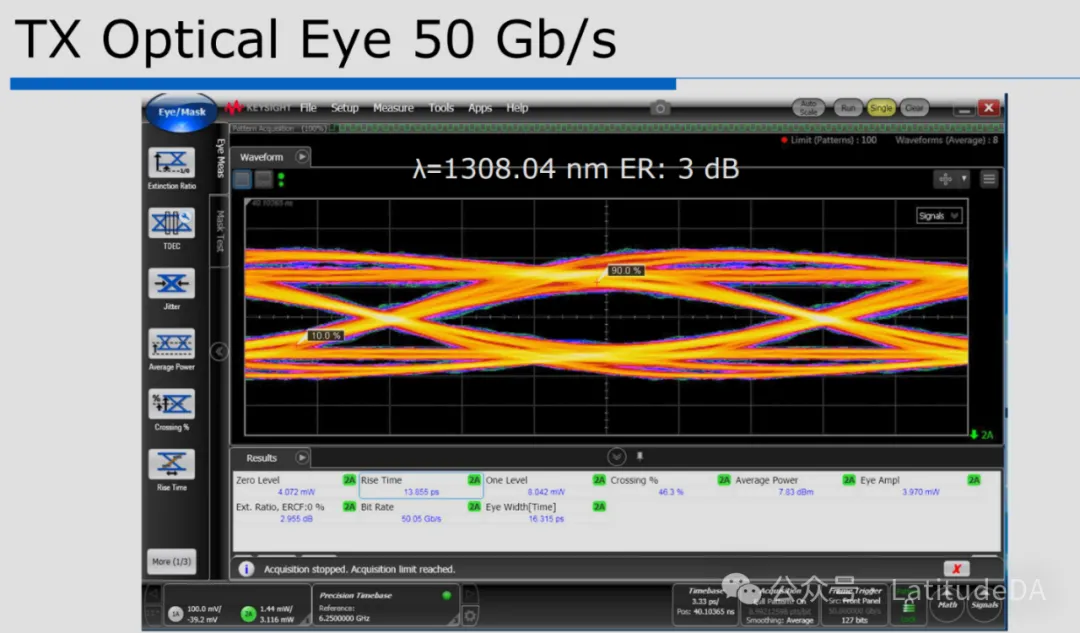 图 28. 发送光眼图 50Gb/s
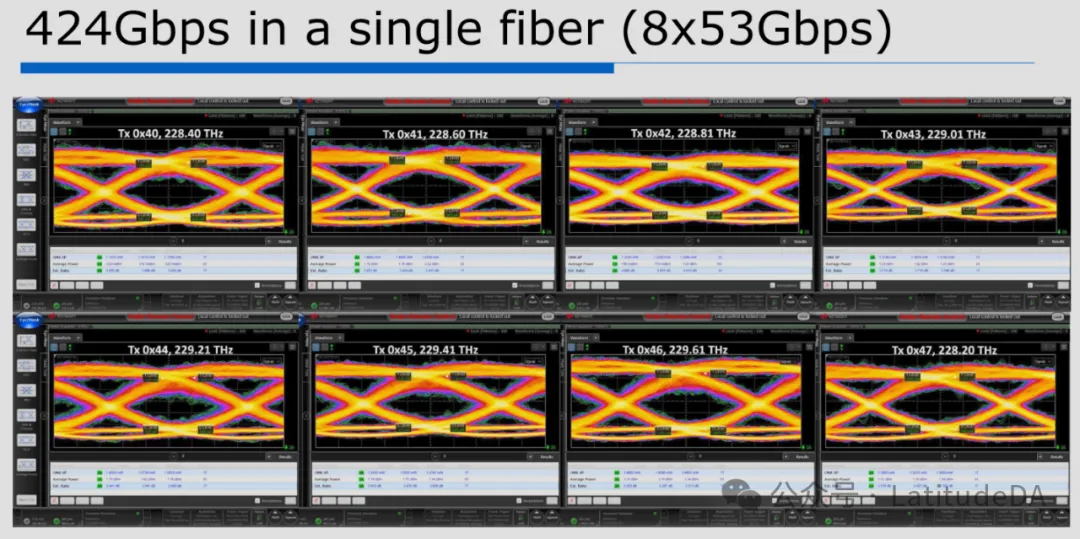 图 29. 单根光纤中的 424Gbps
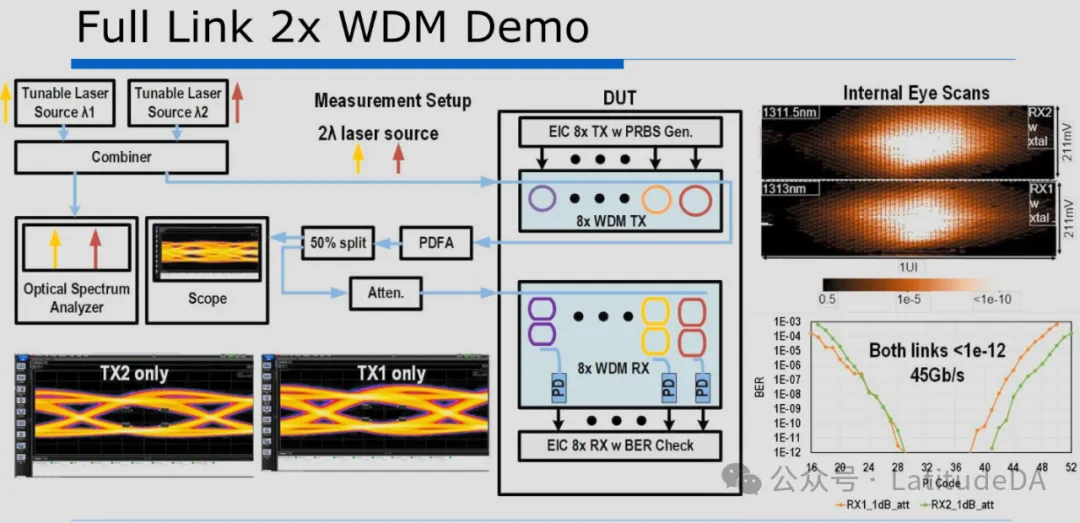 图 30. 全链路 2x 波分复用器演示
本文介绍了AMD基于硅基光电子技术的高吞吐量光收发器,能够在单根光纤中提供 424 Gbps 的总带宽,并且在无 FEC 的情况下实现无差错运行(误码率 < 1e-12)。混合集成方法结合了 7 纳米 EIC 和 45 纳米 PIC,充分利用了两种工艺的优势。EIC 的能效低于 1.6 pJ/bit,每个 RX 和 TX 信道仅占 0.031 mm^2 的面积。采用 MRM 和 CRR 滤波器的 PIC 实现了波分复用操作,7 个通道的中值 RX 灵敏度为 -11.1 dBm OMA。这项工作展示硅基光电子技术在满足下一代人工智能和高性能计算应用对带宽、功耗和延迟的苛刻要求方面的潜力。然而,在开发多波长 O 波段激光器和改进制造工艺以进一步提高这些集成光子收发器的性能和产量方面仍存在挑战。[1] M. Raj," Silicon Photonics-Based High-Throughput Optical Transceivers",IEEE ISSCC,2024.


 微信公众号
 bilibili
 微信视频号