


简介
由于传统的半导体扩展和摩尔定律面临重大挑战,业界正在探索将不同芯片和技术集成到单个封装中的新方法。Chiplets设计和异构集成封装通过将传统的片上系统(SoC)拆分成更小的芯片组,然后利用先进的封装技术将其集成在一起,从而重新设计传统的片上系统。这样就能利用最合适的工艺节点和技术优化系统的不同组件。
本文将介绍Chiplets设计和异构集成的基础知识,讨论其主要优缺点,并提供领先半导体公司的实例。
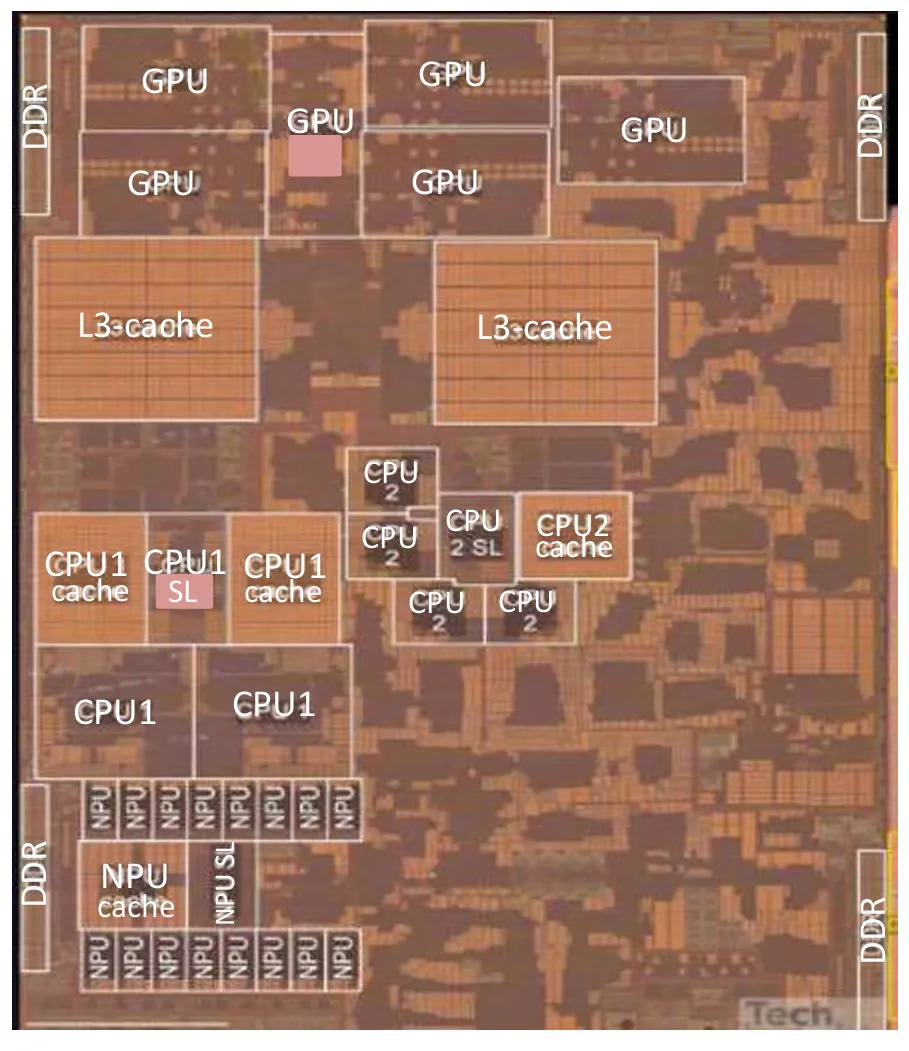 图 1 片上系统 (SoC)
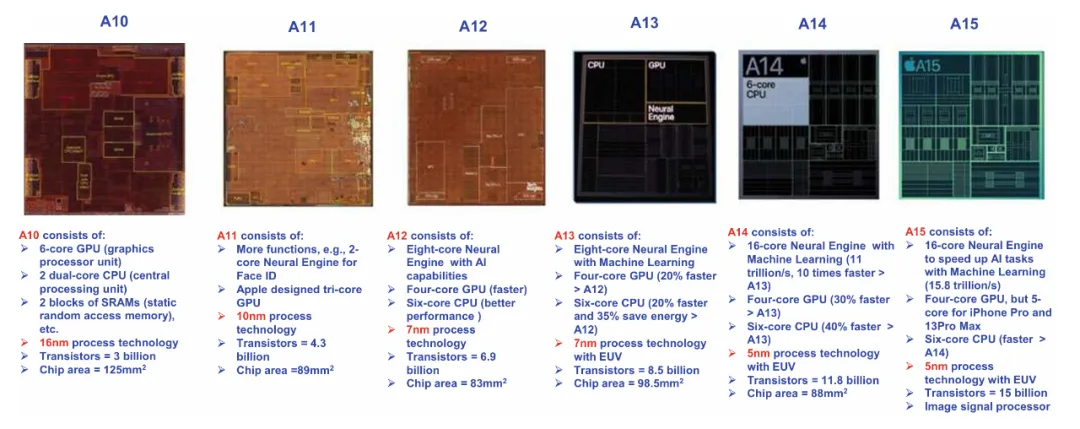 图 2 苹果公司的应用处理器 (AP):A10-A15
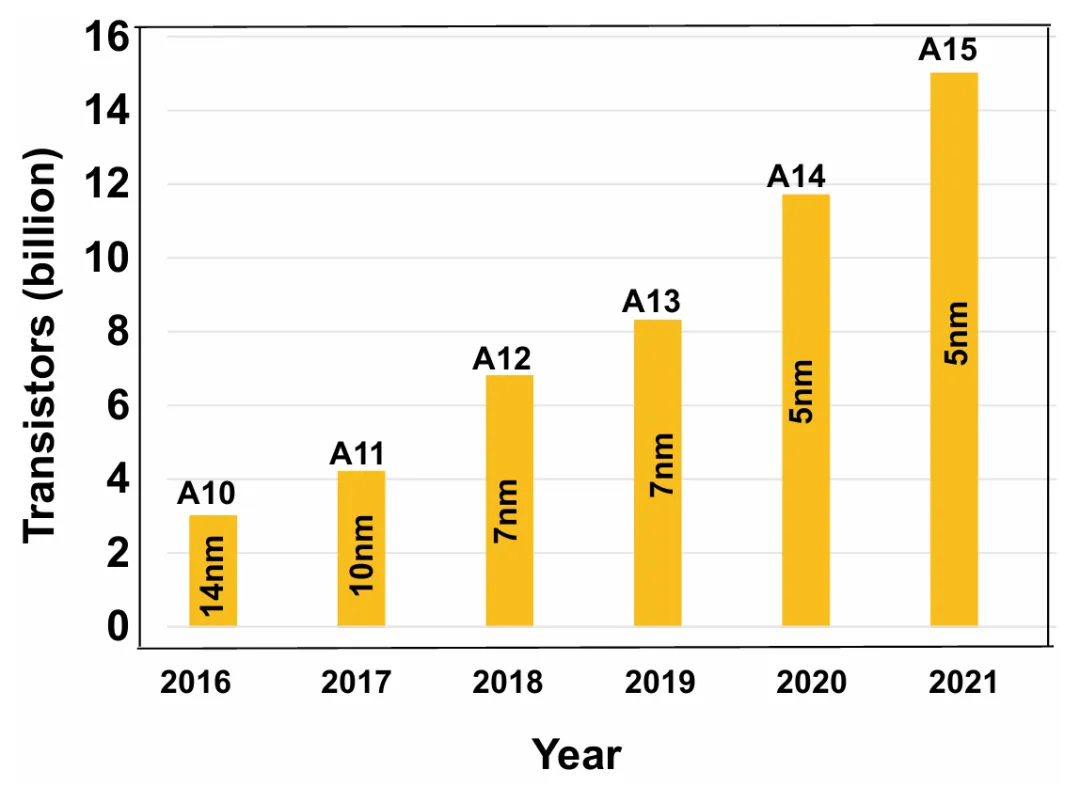 图 3 苹果的应用处理器:晶体管与 A10-A15 在处理技术和年份方面的比较
DARPA 的努力和 SoC 挑战
过去 15 年来,美国国防部高级研究计划局(DARPA)与英特尔、Cadence 和佐治亚理工学院等公司合作,一直是推动异构集成工作的先驱。DARPA 的主要项目包括将磷化铟晶体管与硅 CMOS 集成在一起的 COSMOS,以及用于创建基于chiplet的模块化计算机体系结构的 CHIPS。
传统的 SoC 设计面临着扩展和成本方面的重大挑战。如图 4 所示,先进的设计成本呈指数增长,预计 5 纳米设计仅设计成本就将超过 5 亿美元。此外,高产能制造开发的成本超过 10 亿美元。
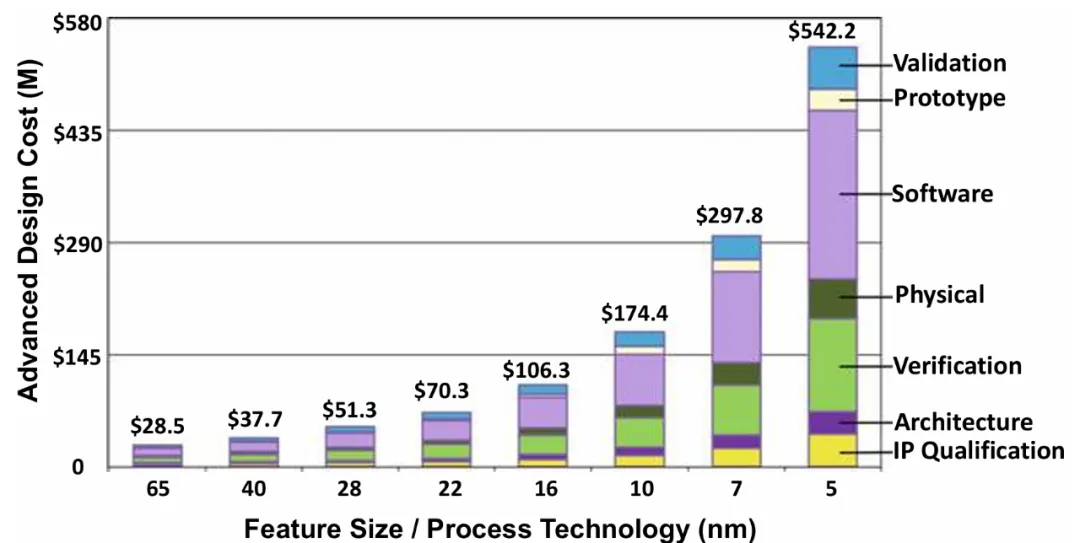 图 4 半导体芯片的高级设计成本与特征尺寸(加工技术)的关系
Chiplets设计和异构集成
Chiplets设计和异构集成封装将大型 SoC 分成较小的芯片组,然后使用针对每个chiplet功能优化的不同技术将其集成到高级封装中。图 5 展示了芯片异构集成,SoC 按照功能被分割成逻辑芯片和 I/O 芯片。图 6 展示了芯片分割异构集成,即一个大型逻辑芯片按照成本和产能被分割成较小的逻辑芯片。
如图 7a-c 所示,还有多种使用silicon interposer的系统异构集成方法,从内置基板上芯片的 2.1D 集成到使用硅通孔 (TSV) 内插件的 2.5D/3D 集成。
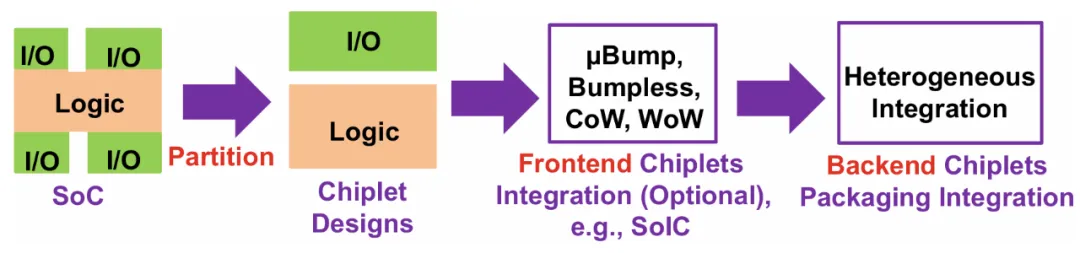 图 5 由成本和技术优化驱动的芯片分割和异构集成
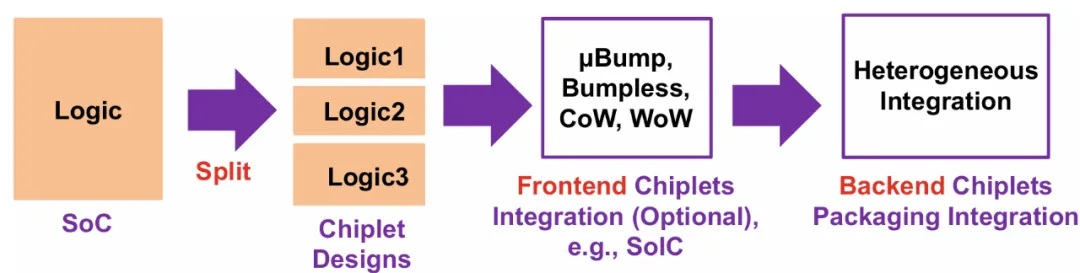 图 6 由成本和半导体制造产量驱动的芯片分割和异构集成
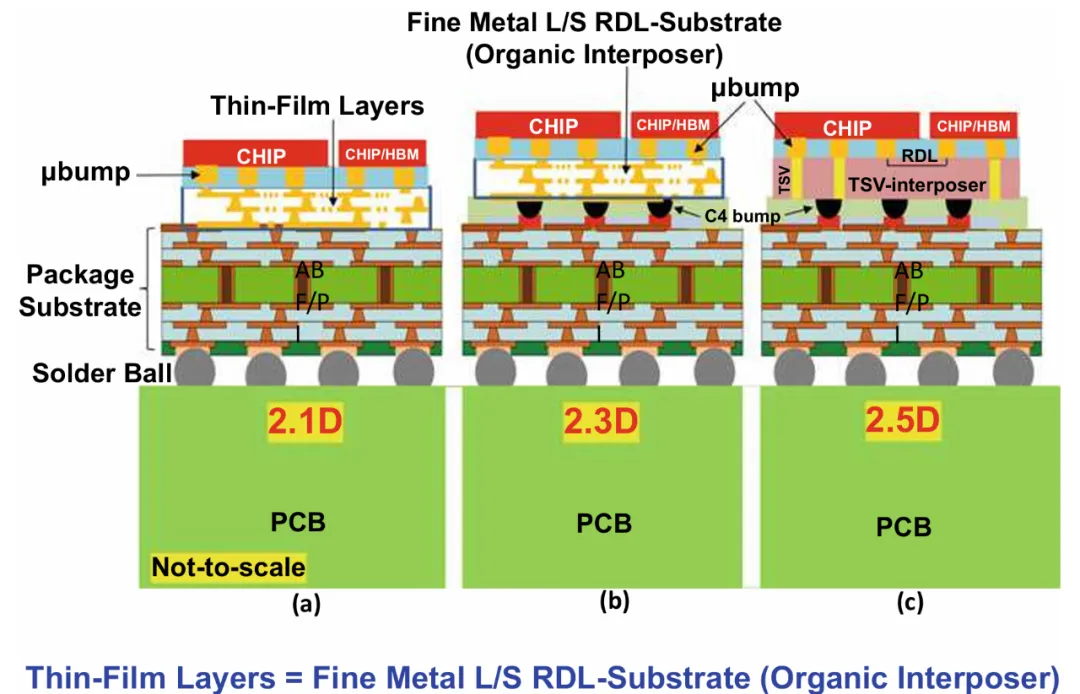 图 7 多系统和异质集成 a 2.1D 集成电路集成 b 2.3D 集成电路集成 c 2.5D/3D 集成电路集成
优缺点
芯片设计的主要优势(如图 8 所示)是,与单片系统级芯片设计相比,其制造良率有可能显著提高,尤其是在芯片尺寸较大的情况下。这直接降低了成本。
其他优势包括:
通过重复使用成熟的 IP 模块,加快产品上市速度 降低 CPU 内核的设计成本 分布式芯片具有更好的散热性能 能够使用最合适的工艺节点优化每个芯片组
主要缺点是芯片到芯片接口的面积增加、封装成本提高、设计复杂性增加,以及现有 EDA 工具在芯片设计方面的局限性。
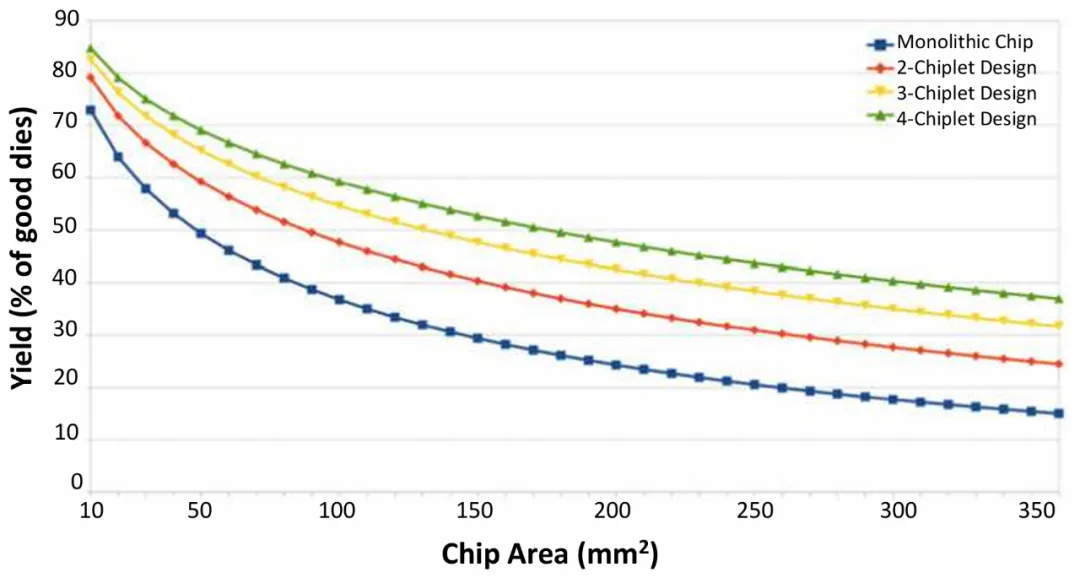 图 8 不同chiplets设计和单片芯片的产量与芯片面积对比
行业实例
赛灵思在 2013 年推出了 28 纳米 Virtex-7 FPGA 系列,成为基于芯片的异构集成的先驱。如图 9 和 10 所示,使用台积电的 CoWoS(Chip-on-Wafer-on-Substrate,基片上芯片)2.5D 封装技术,将一个大型 FPGA 分拆为四个较小的芯片。
 图 9 Xilinx/TSMC 的chiplet设计和异构集成封装
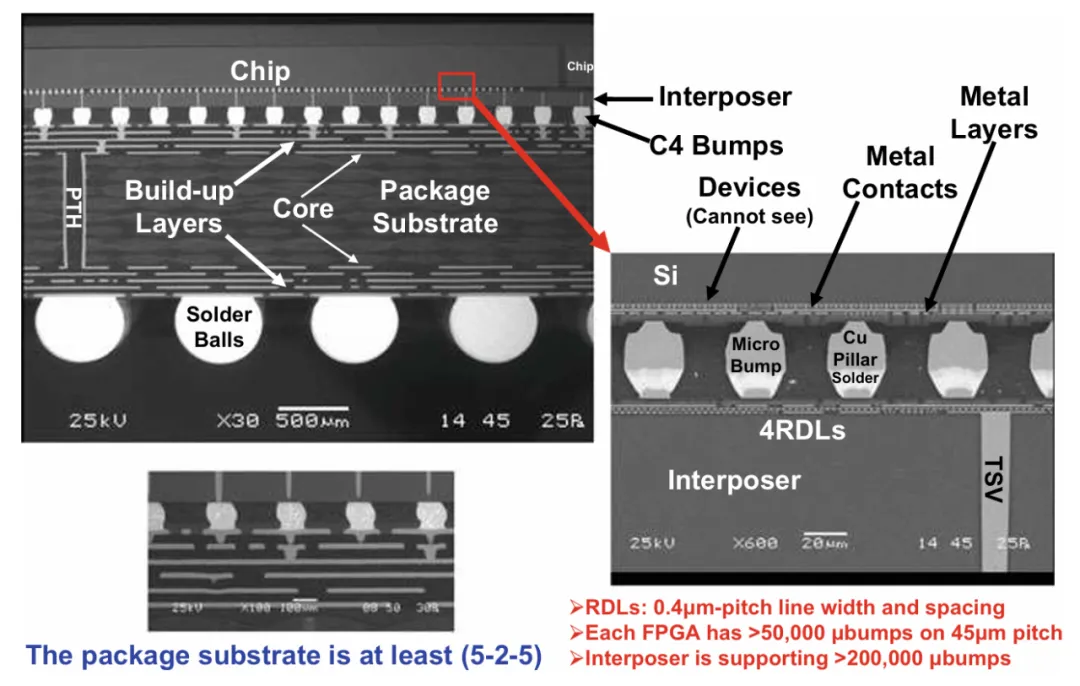 图 10 Xilinx/TSMC 的chiplet设计和异构集成封装的 SEM 截面图
AMD 在其 CPU/GPU 产品线中迅速采用了芯片组设计。图 11-15 展示了 AMD 的chiplet封装从使用二维有机基板平台的第二代 EPYC 服务器 CPU 到未来的三维有源内插设计的演变过程。图 16-19 中的创新 3D V-Cache 技术采用铜铜混合直接键合技术,将 64MB 堆叠 L3 高速缓存键合到 Zen 3 CPU 上。
 图 12 AMD 带chiplets的第二代 EPYC 服务器和台式机处理器


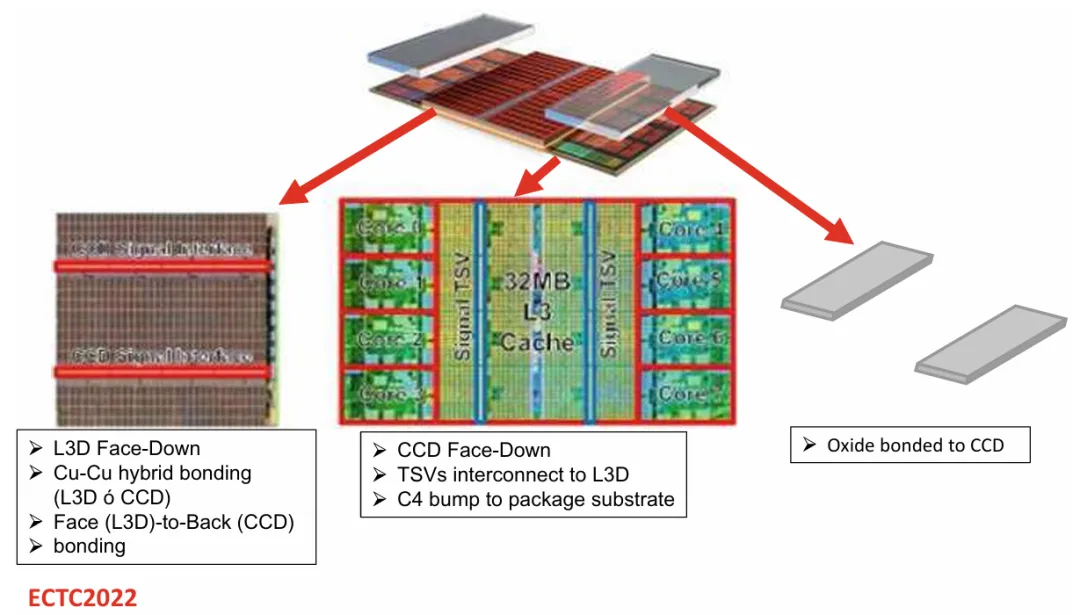

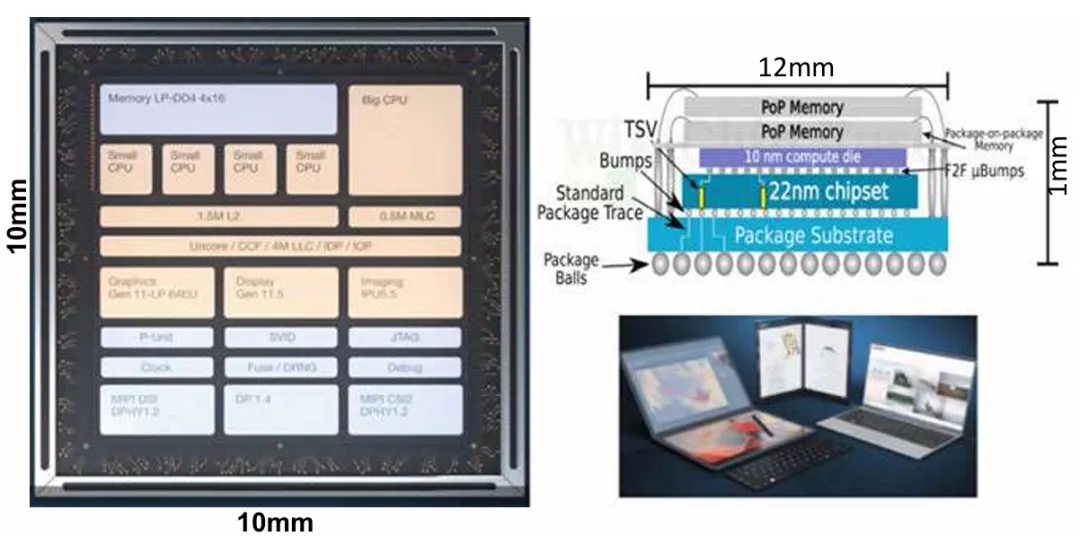
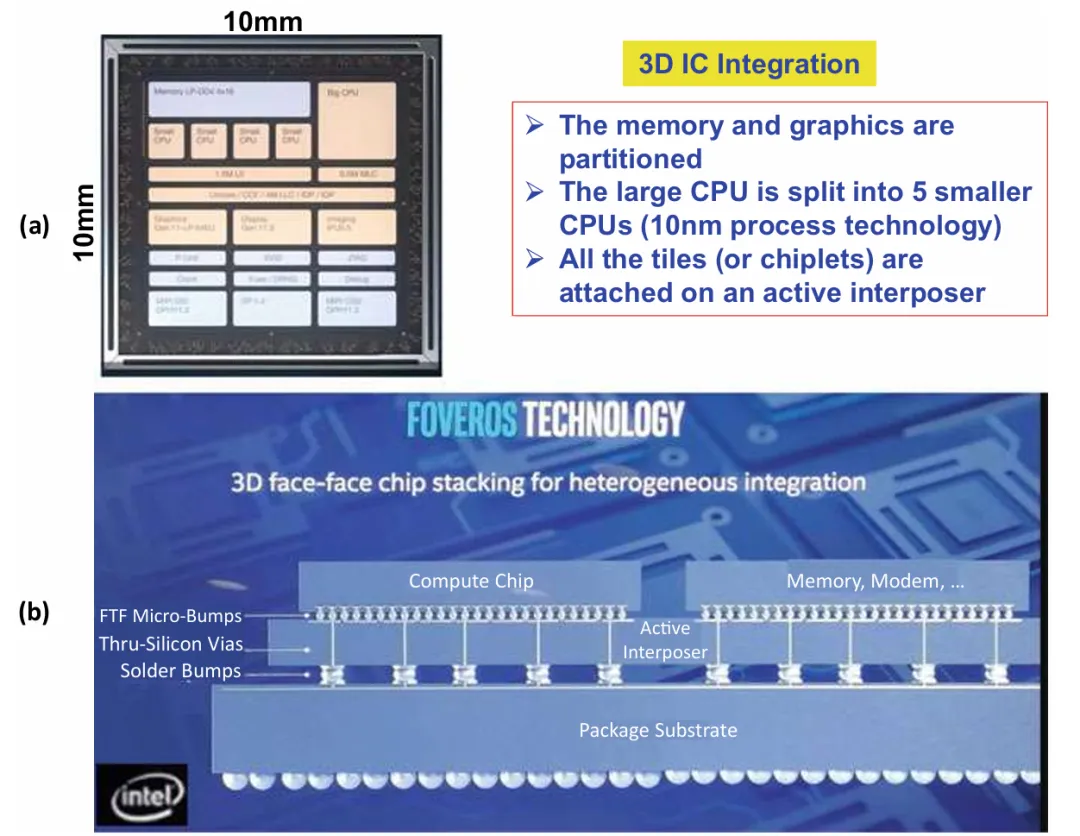
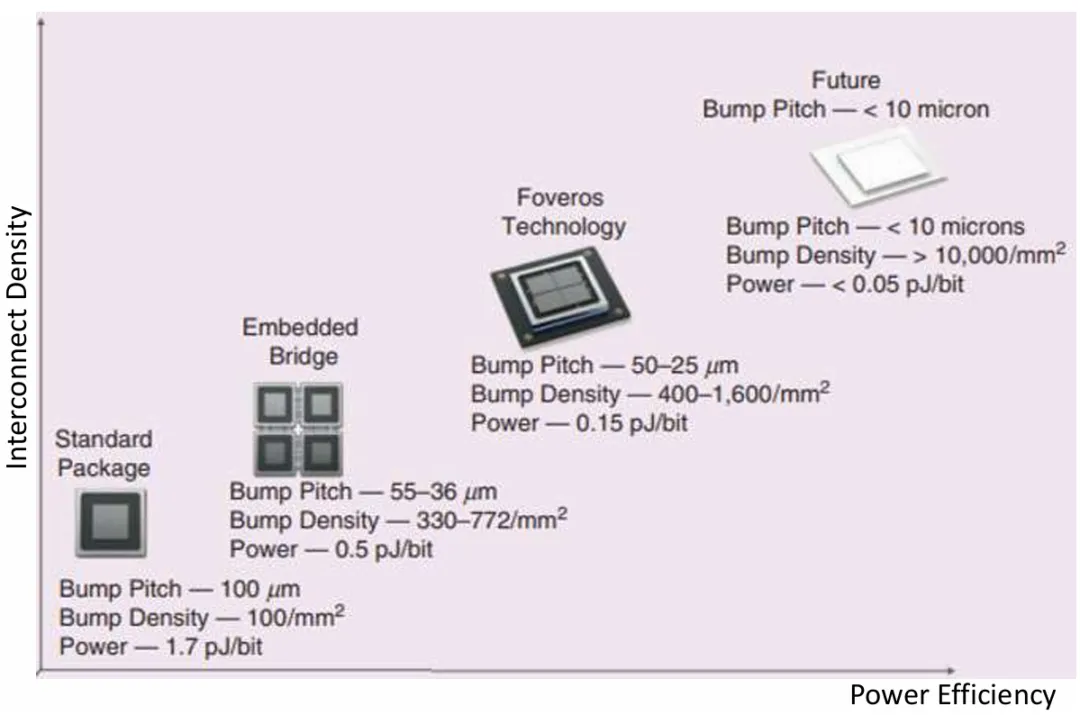
英特尔的chiplet工作包括在active interposer上使用 FOVEROS 3D 堆叠技术的 Lakefield 移动处理器(图 20-23),以及使用 EMIB 和微凸块技术集成了 47 个芯片的大型 Ponte Vecchio GPU(图 25-30)。图 31 所示的路线图以小于 10um 间距的铜铜混合键合技术为目标,以提高互连密度。
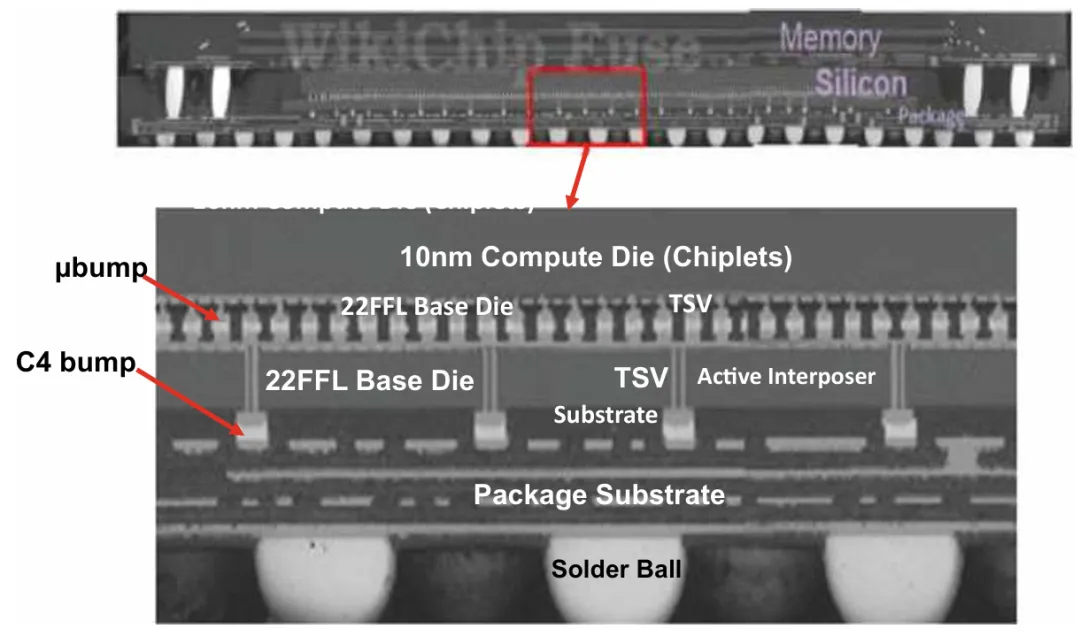
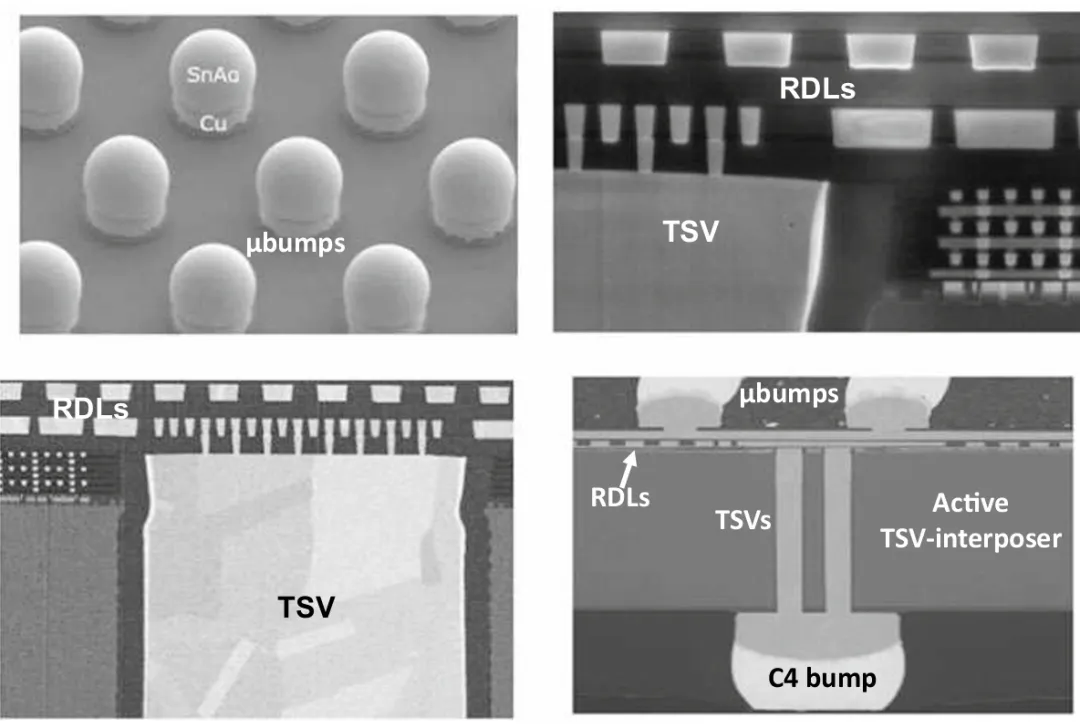
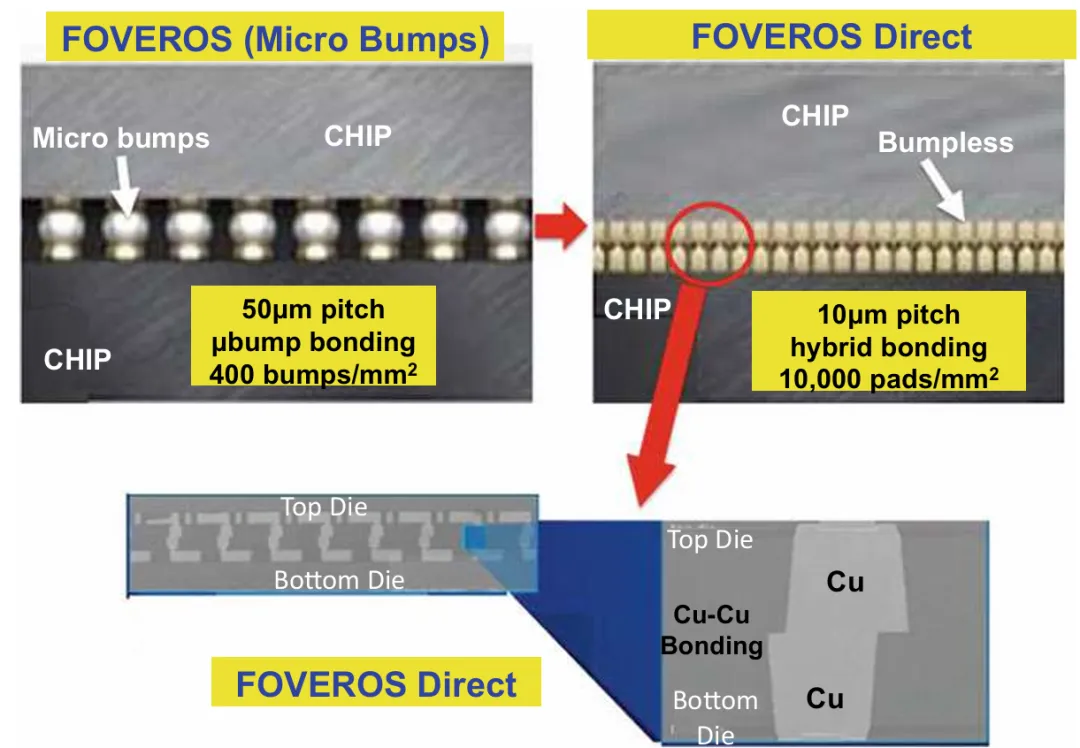
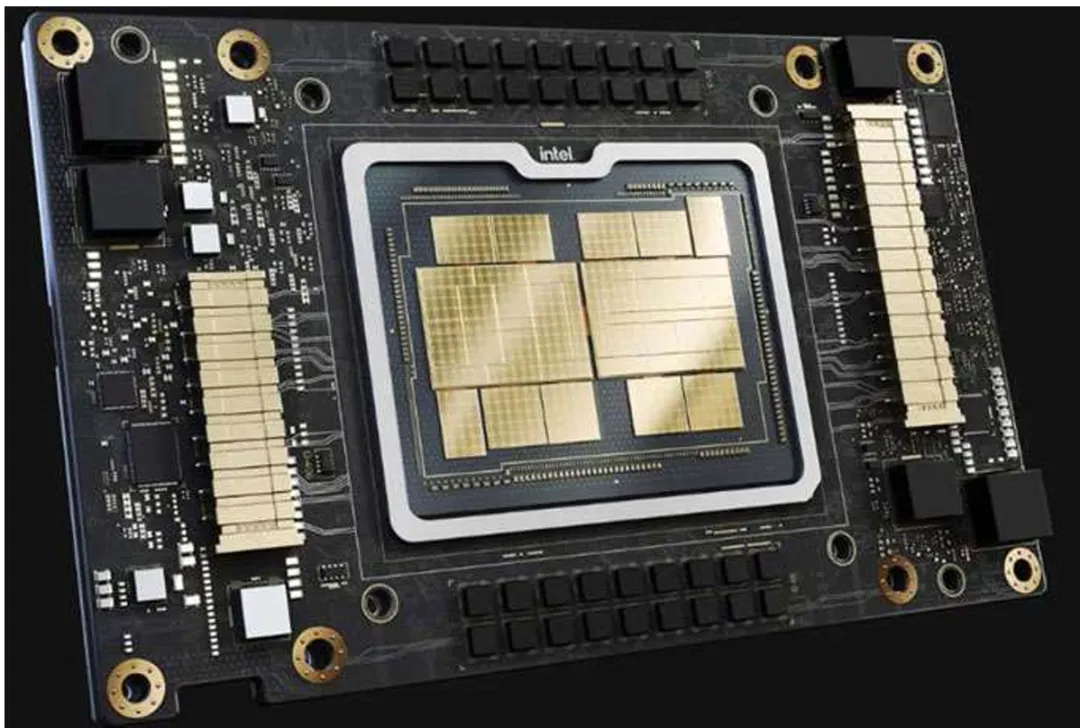
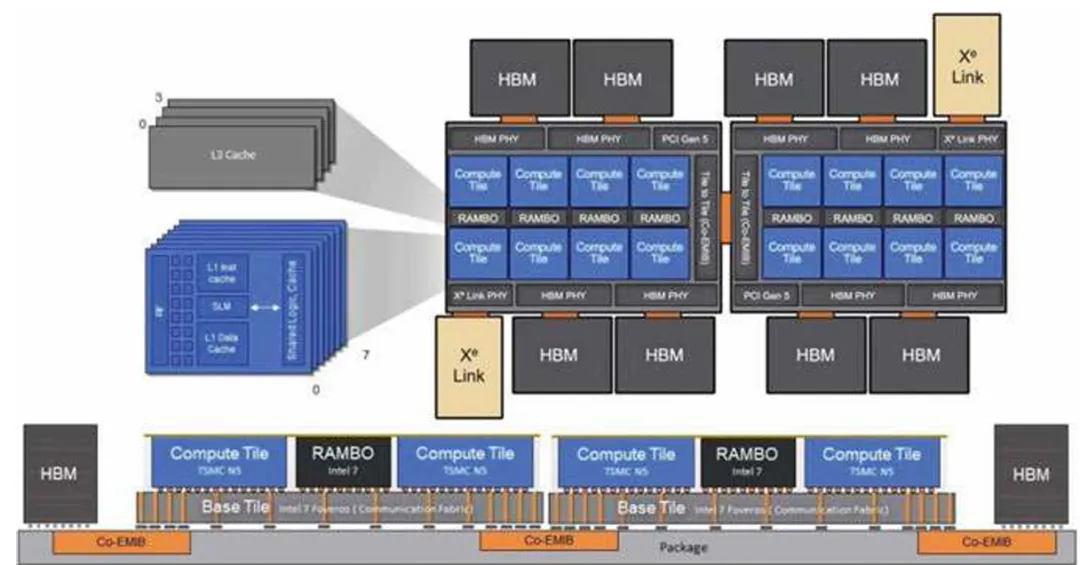
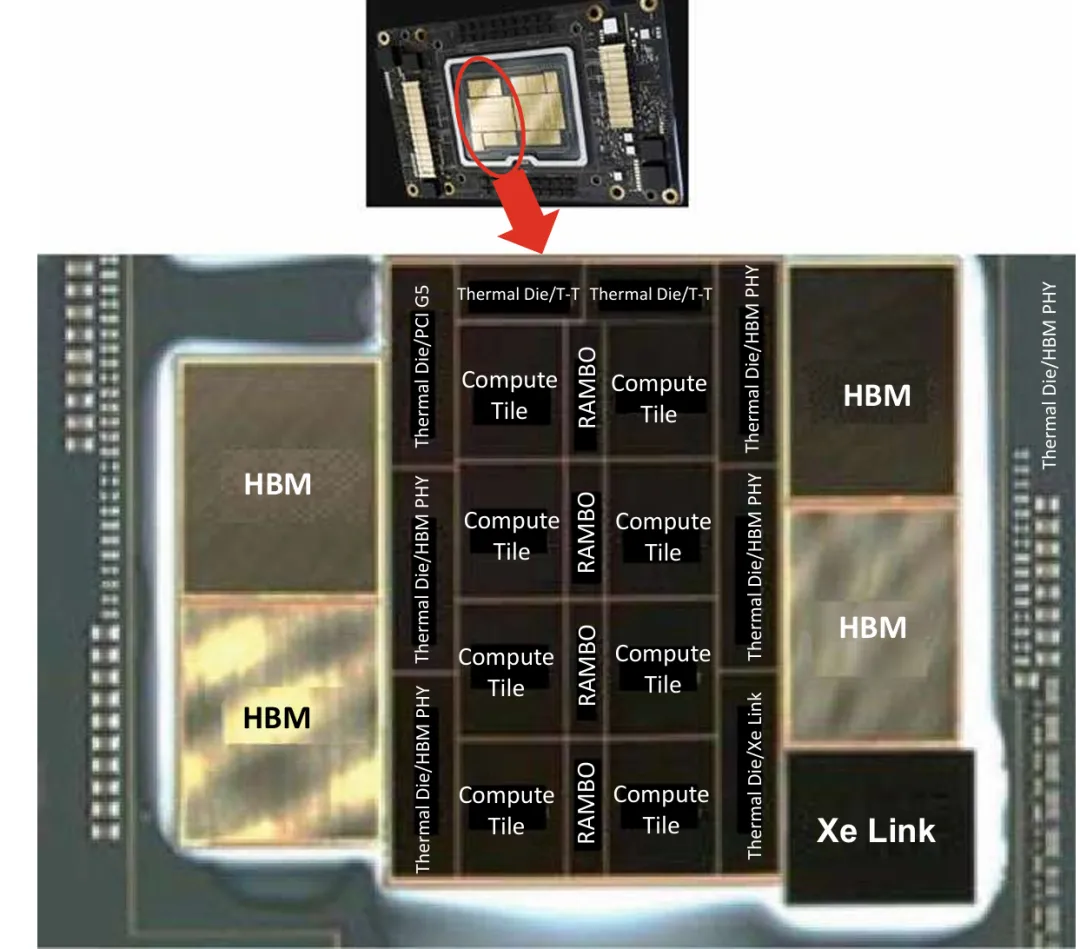

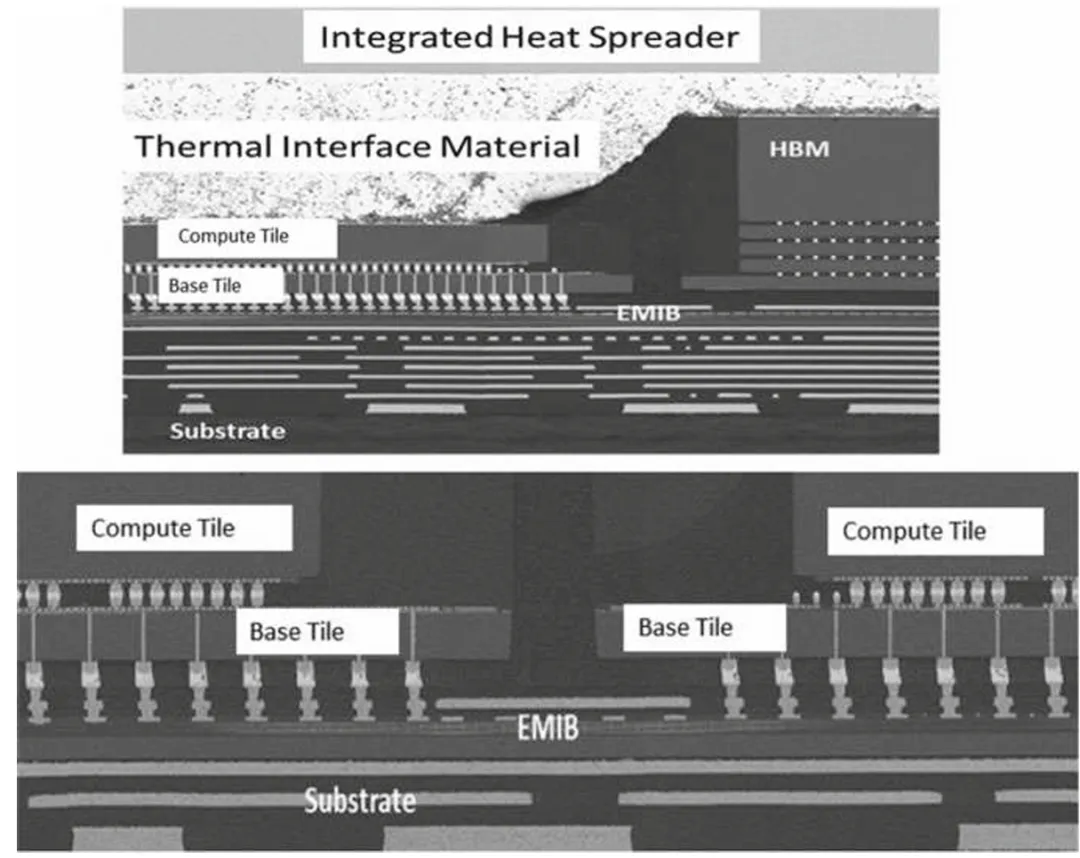
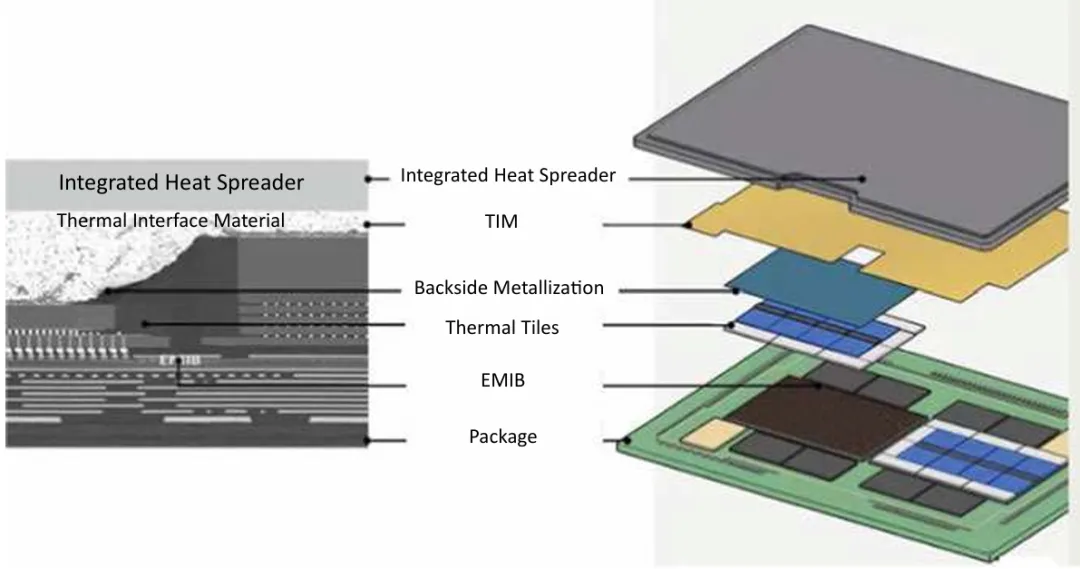
台积电开发了 3DFabric chiplet集成平台,将用于 3D 堆叠的正面 SoIC 混合键合(图 32-35)与使用 CoWoS 和 InFO 封装的背面 2.5D 集成(图 36)相结合。他们的 SoIC 技术实现了 AMD 的 3D V-Cache 产品。
其他chiplet实例包括 Graphcore 的晶圆上集成 IPU 处理器(图 37-39)
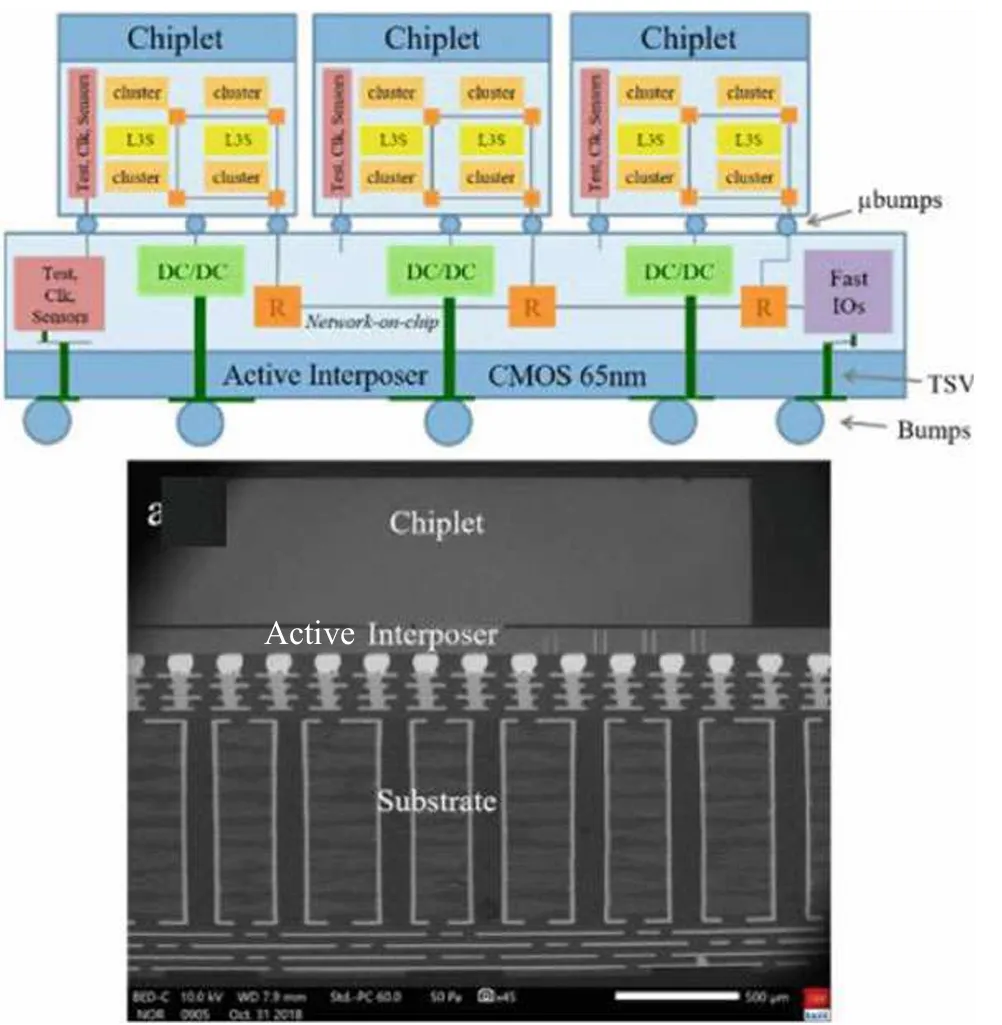
和 CEA-Leti 的 INTACT active interposer芯片(图 40-41)。
为了推动chiplet标准生态系统的发展,AMD、英特尔、三星、台积电等公司成立了通用芯片互连 Express(UCIe)联盟。
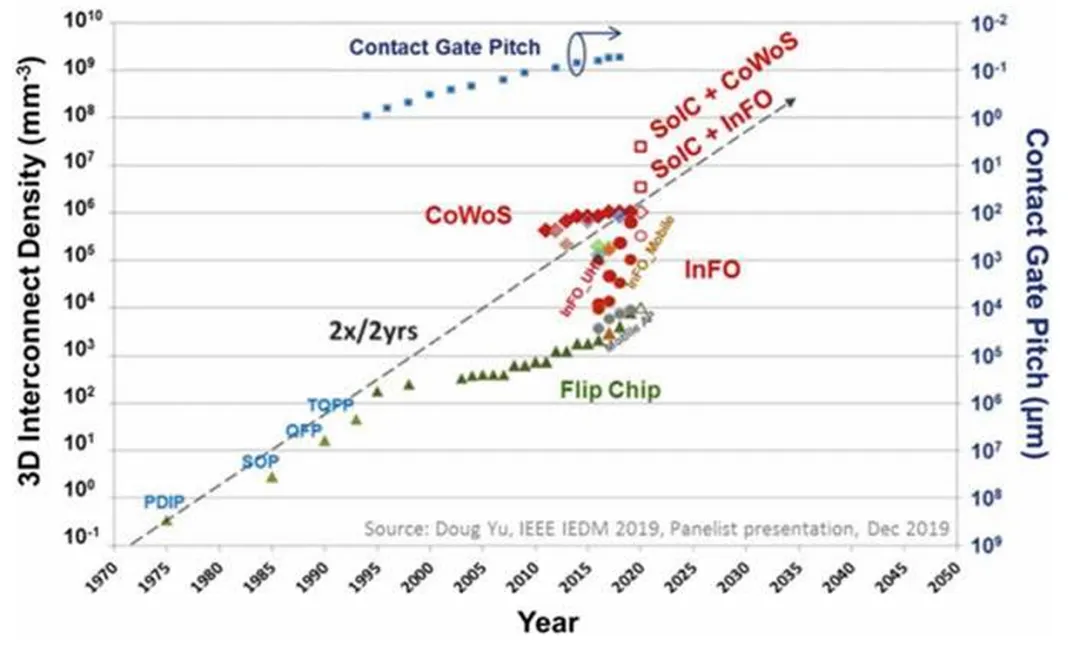
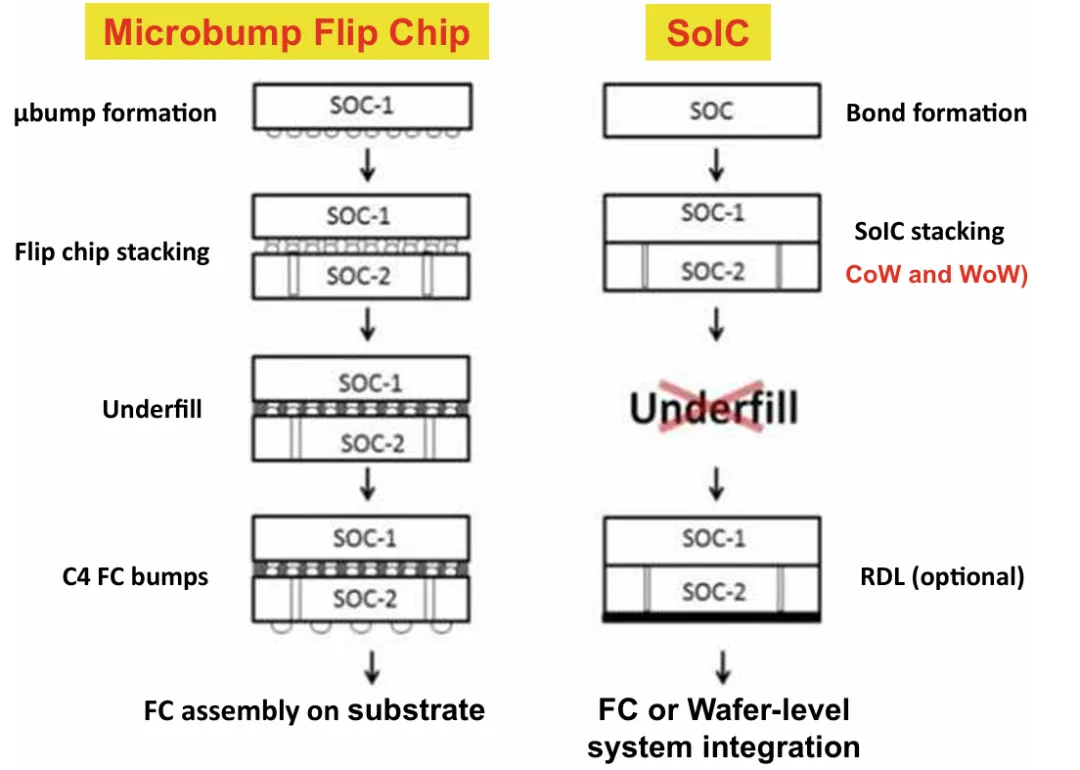 图 33 台积公司的 SoIC(系统集成芯片)技术
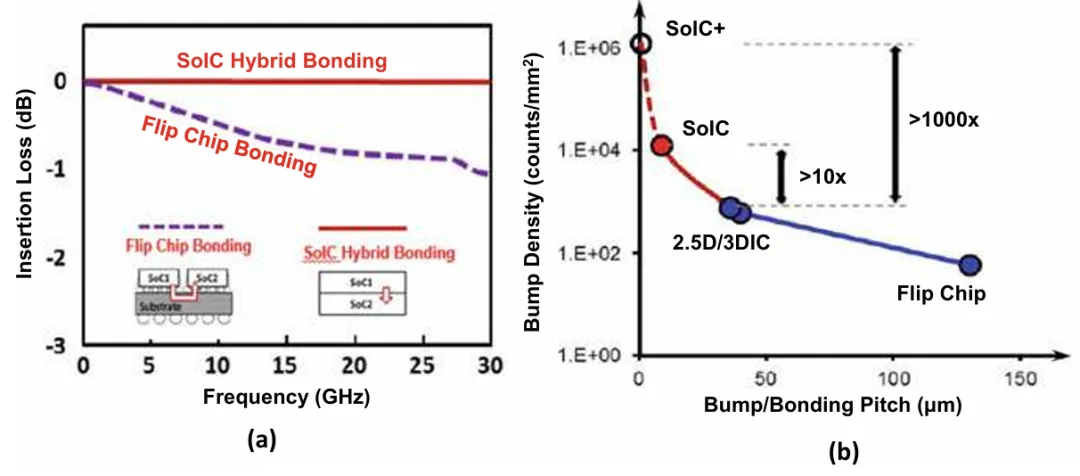 图34 台积电的铜-铜无凸块 SoIC 与传统微凸块倒装芯片技术的对比,a 电气性能,b 凸块密度。
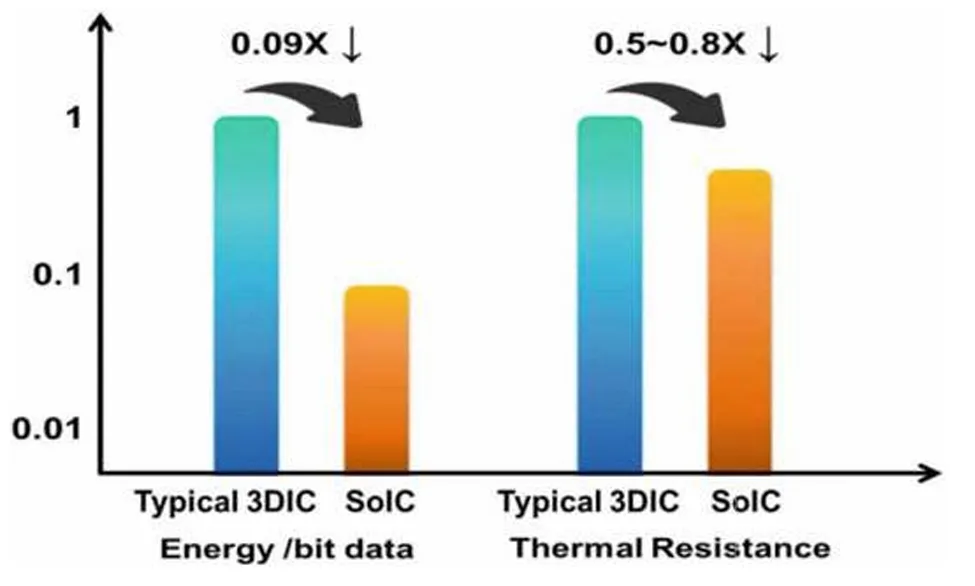 图 35 热性能和能耗:SoIC 与传统 3D IC 的对比
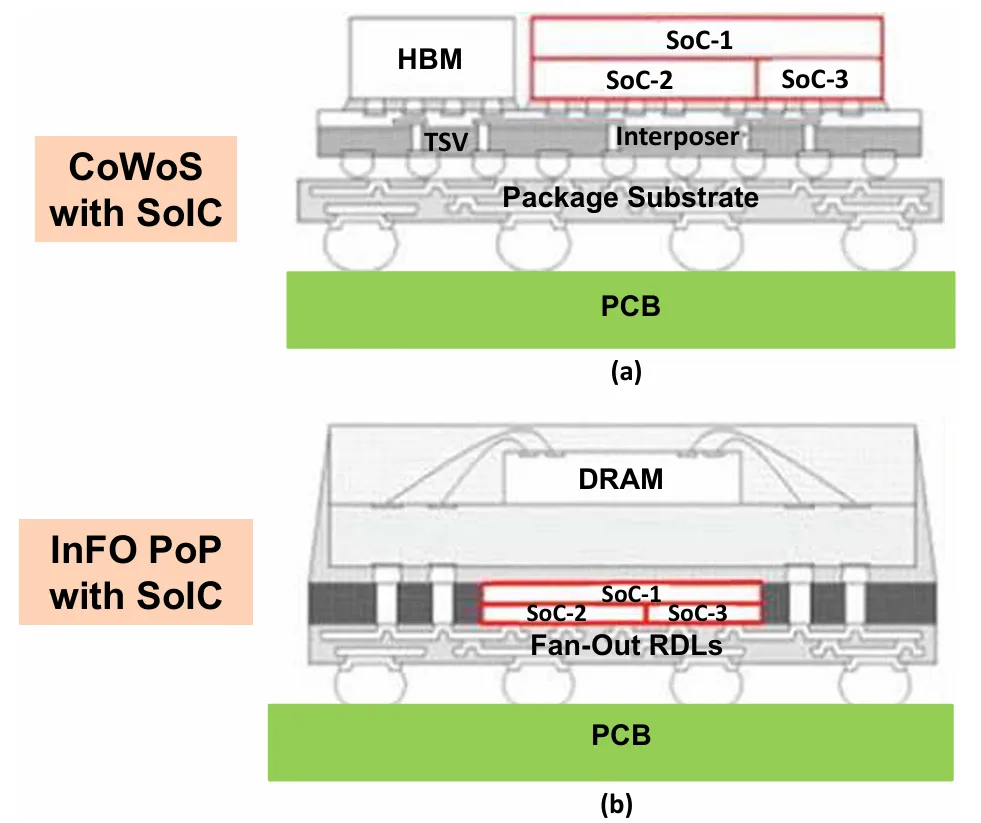
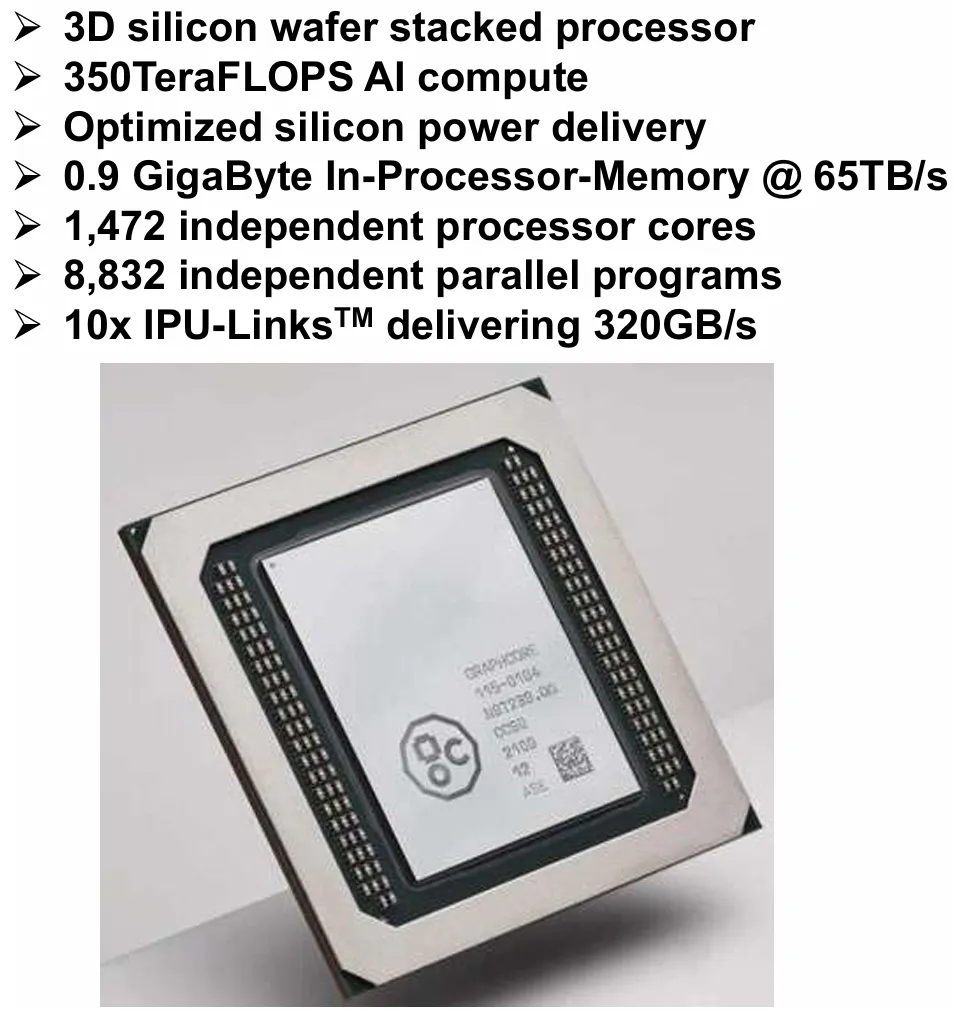 图 37 Graphcore 的 IPU(智能处理单元)处理器
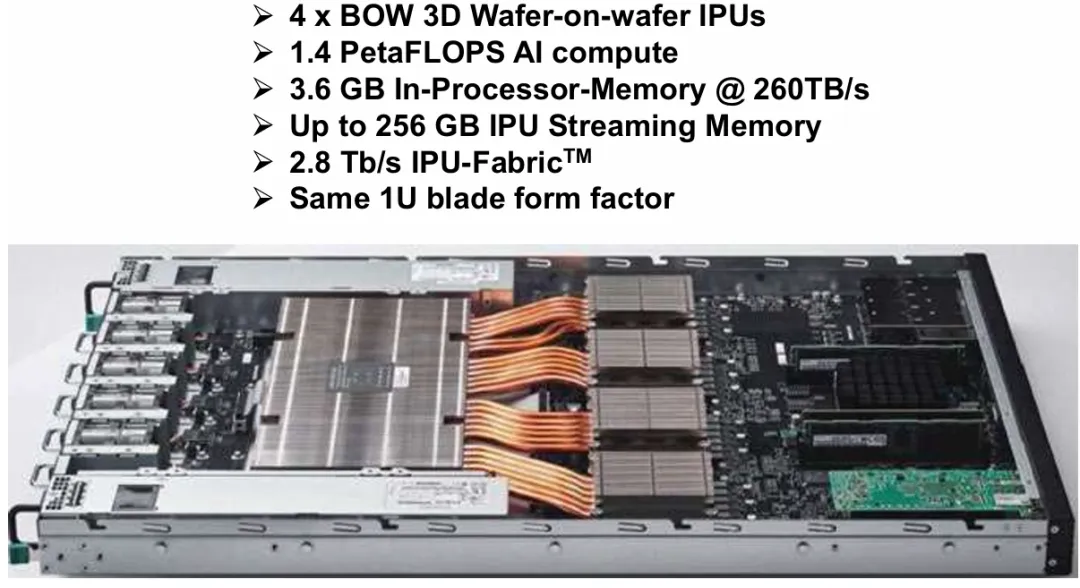 图 38 Graphcore 的 IPU 处理器的结构部件
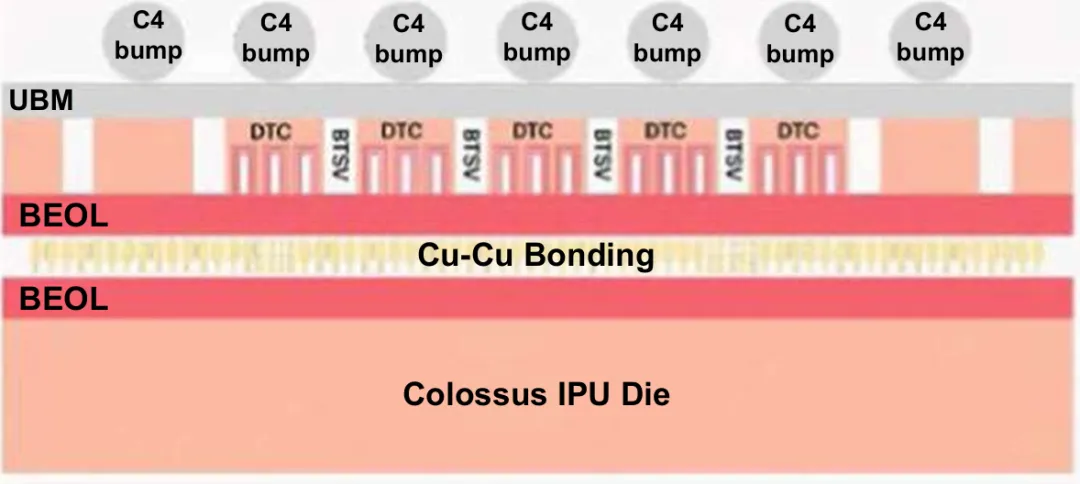 图 39 采用台积电 SoIC Cu-Cu 无熔点面对面键合技术的 Graphcore IPU 处理器
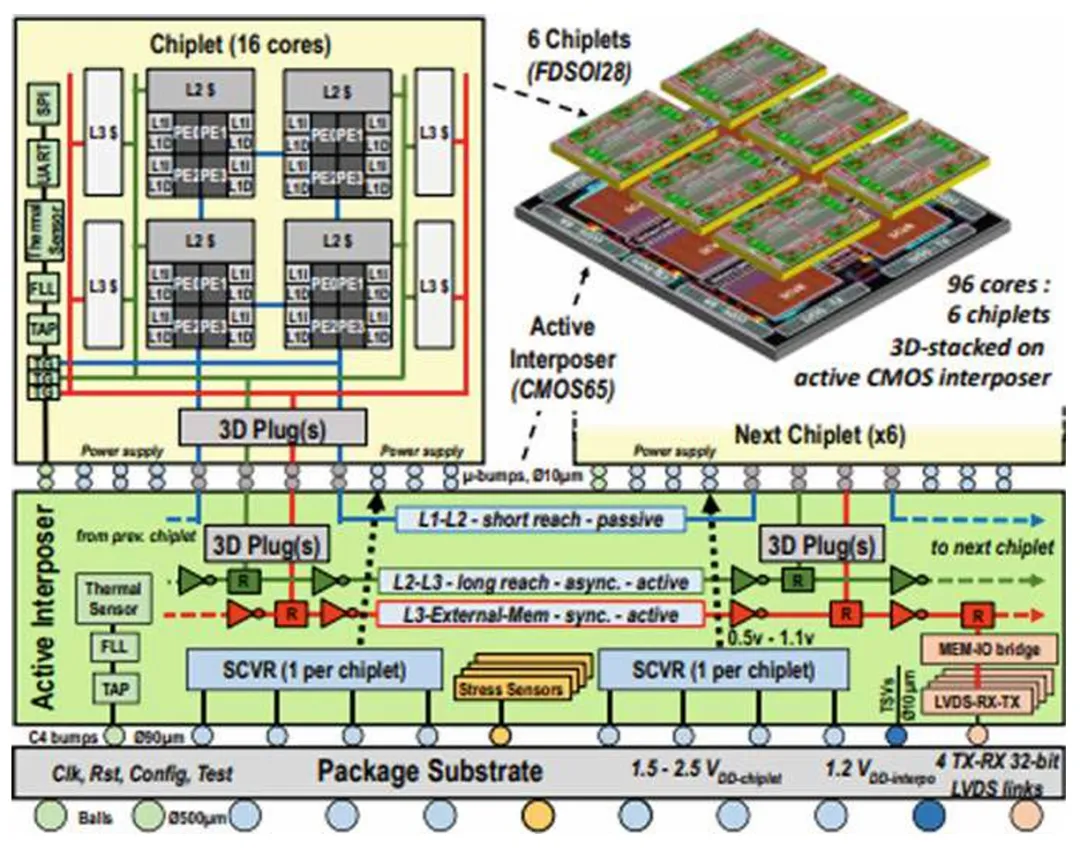 图 40 CEA-Leti 的 ACTINT(active interposer上的chiplet)
总结
Chiplets设计和异构集成提供了一条超越传统半导体规模的另类途径。基于芯片的架构虽然会产生较高的封装成本和复杂性,但却能在制造成本、性能、上市时间和设计灵活性等方面带来潜在优势。业界领先企业已经展示了令人印象深刻的芯片组产品,UCIe 联盟的成立旨在建立开放标准,进一步加快芯片组生态系统的发展。
芯片设计的主要优势包括:
主要挑战包括:
Chiplet与chiplet之间的互连增加了面积和复杂性 更高的整体封装成本和尺寸 需要新的 EDA 方法来自动划分芯片组 建立开放的芯片互连生态系统和标准
随着摩尔定律的扩展变得越来越困难,基于chiplet的异构集成正在成为颠覆性的、有希望继续推动半导体性能和创新的方法。
参考文献
[1] J. H. Lau, Chiplet Design and Heterogeneous Integration Packaging. 第 1 版。新加坡:Springer, 2023. Available: https://doi.org/10.1007/978-981-19-9917-8
 微信公众号
 bilibili
 微信视频号