随着生成式AI的爆炸性增长,HBM(高带宽存储器)逐渐为人熟知。当前大多数生成式AI模型参数量庞大,计算架构普遍采用冯·诺依曼架构,即数据存储与计算核心分离,需要时再进行数据迁移。然而,搬运亿级参数来往于计算核心与存储位置的代价远远超过数据运算本身的耗能及时间,导致模型运算效率严重拖累,这就是“冯·诺依曼瓶颈”或“内存墙”。因此,拥有高带宽、能在单位时间内存取大量数据的HBM成为大型语言模型计算芯片的绝佳解决方案。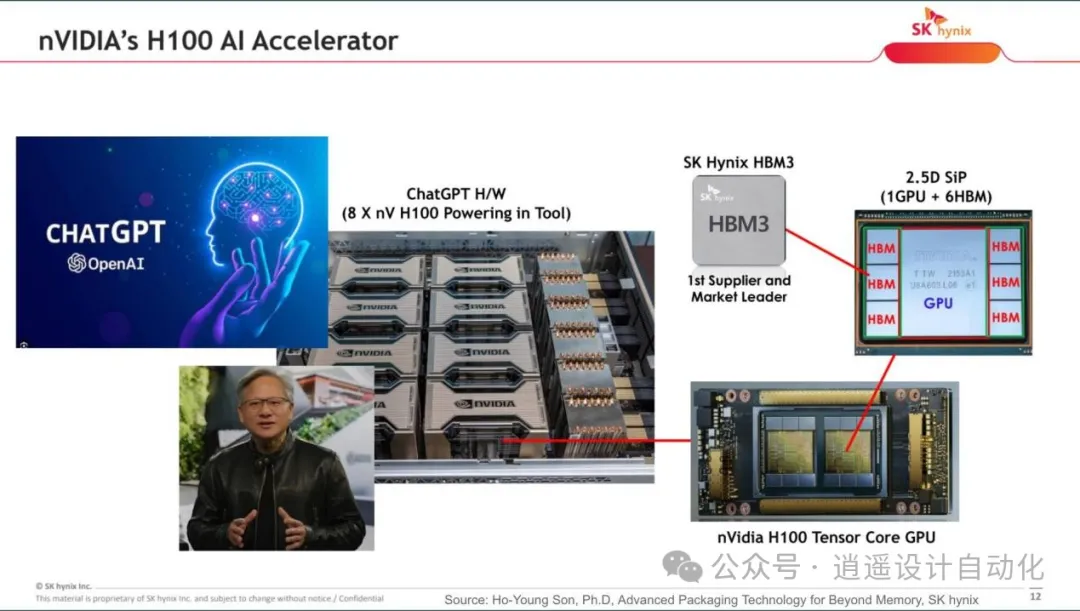

HBM并未突破冯·诺依曼架构,但一定程度解决了传统DRAM(DDR、GDDR、LPDDR)带宽、容量、功耗不能兼备的问题。内存带宽 = I/O速率(数据速率) x 总通道宽度(channel width)。传统DRAM如DDR4、GDDR着力于提升内存频率以提升内存带宽,例如array微缩、prefetch技术等;HBM则更着重于提升通道宽度来达到更高内存带宽。虽然GDDR相比DDR在通道宽度上有所提升,但由于GDDR本质上仍通过PCB载板上的布线与GPU做数据交换,通道宽度提升受到一定限制,且GDDR高带宽下的牺牲是有限的容量。HBM采用TSV技术堆叠DRAM die以大幅提升I/O数,再配合2.5D先进封装制程,在维持较低内存频率的同时达到更显著的总通道宽度提升,兼具高带宽、高容量、低功耗:1.TSV:直接在内存芯片上钻孔并制成导线通道,利用bump将die堆叠起来,大幅增加I/O数量同时实现更高容量。例如HBM3E之前的世代均具1024位元宽,是传统内存32/64位元的数十倍之多。
2.2.5D封装(CoWoS):HBM的DRAM die与GPU利用2.5D封装在一片硅中介板上,大幅缩短数据传递路径并消耗更少能源。
HBM并非没有缺点,它价格昂贵、稀缺且难维护。根据调研机构Yole,HBM芯片平均售价比传统DRAM芯片高出五倍,产能严重不足。同时,HBM中内存die的堆叠结构也带来了散热难题。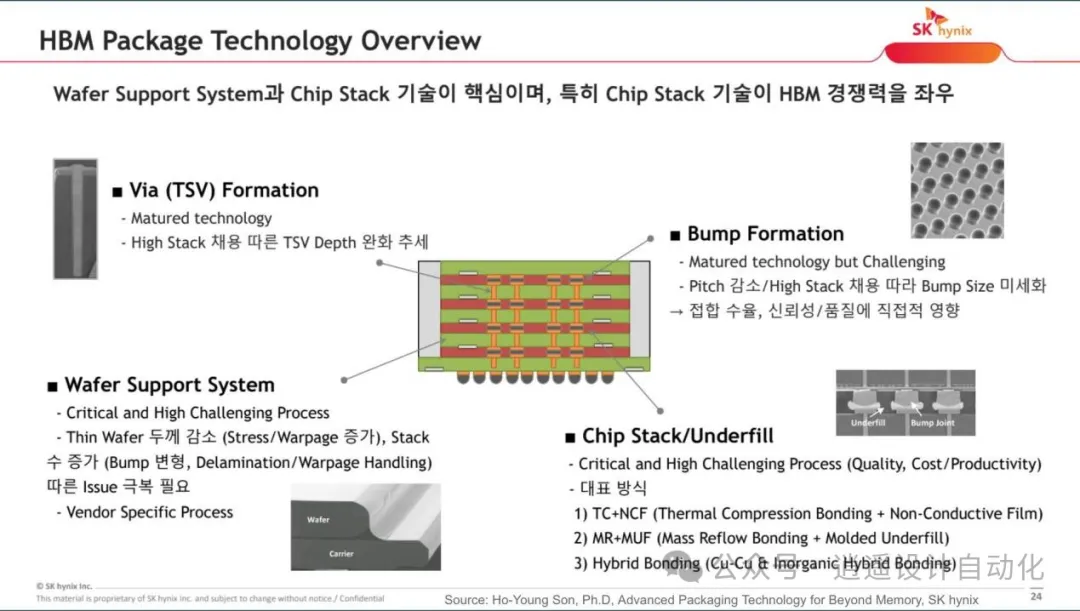
HBM市场份额主要由SK Hynix (SKH)、Samsung、Micron三大巨头占据。SKH早在2013年就与AMD合作布局HBM,成为目前HBM供应商市场的领导者。截至2022年,SKH占据50%的HBM市场份额,大于Samsung的40%,Micron仅占10%。2024年市场主流HBM为HBM3,大部分由SKH供应,预计下半年HBM3E将渐渐取代HBM3在顶规GPU的位置。HBM4则预计2026年推出。JEDEC规范下HBM1到HBM3E的总线宽度一直维持在1024 bit,主要规格演进在I/O速率增加及堆叠层数增加上。未来HBM仍将继续追加更高I/O速率及更高层数堆叠以达到更高带宽及容量。HBM的竞争格局已不再局限于制程微缩,还包括更先进的die堆叠技术以及芯片硬件架构的根本进化。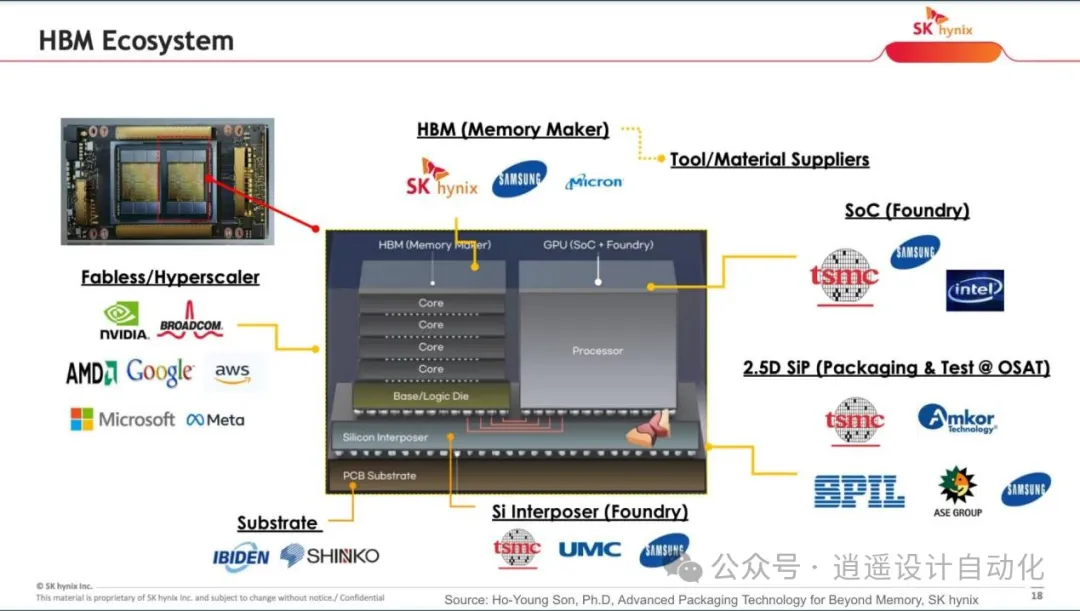

近年来大型语言模型(LLM)参数量增长迅速,时下HBM性能仍不够用。未来HBM4可能会应用2048位元的通道,通过增加TSV密度来增加I/O数。SKH正在尝试将扇出式封装(FOWLP)应用在HBM上;三星则考虑将光通讯技术整合。未来HBM的竞争格局已不再局限于单一的制程微缩,还有更多的可能性值得探索。在各大云端业者都在全力开发自家AI模型的时代,HBM在冯·诺依曼架构下始终是目前的最优解,势必也会随着logic的脚步趋于客制化。尽管现在SKH领导HBM市场,但未必不会出现后来居上的黑马,我们拭目以待。


 微信公众号
 bilibili
 微信视频号