


摘要
谷歌最新一代张量处理单元(TPU v4)的关键创新,是用于训练机器学习模型的领域专用超级计算机。TPU v4 引入了光学链路开关(OCS)实现灵活的拓扑结构,以及专门加速嵌入操作的稀疏核心。OCS构建了一个由4096个芯片组成的互联网络,通过重构特性提高了系统的可靠性,并通过可定制的拓扑结构优化了性能。稀疏核心仅增加约5%的面积和功耗,就为嵌入操作带来了5-7倍的加速效果。在生产环境工作负载下,TPU v4比TPU v3的性能提高了2.1-3.5倍,性能功耗提高了2.7倍。
介绍
机器学习模型的规模和算法复杂性正在迅速发展。TPU v4代表了谷歌为加速这些挑战性模型训练而设计的最新专用硬件,它与算法、软件基础设施和定制硅芯片一起,构成了一个集成的机器学习系统。本报告重点介绍TPU v4中的两项关键架构创新:
光开关带来灵活的拓扑结构
为了将芯片数从TPU v3的每台超算中1024片提升到TPU v4的4096片,引入了OCS通过光纤连接TPU芯片。OCS带来了八大优点:
光开关使用64片的基本模块构建了TPU v4超级计算机,模块内芯片之间使用电连接,模块之间使用光连接。尽管OCS系统带来了变革性的互连灵活性,但它只增加了不到5%的总体系统成本和3%的功耗。这可以高效地构建一个4096芯片的系统,且容错率高。

图1:4x4x4结构(上)到3个OCS(下)的连接。带有相同维度和索引的“+”和“-”连接到同一个OCS; 48对入出口每个连接到不同的OCS [1]。
稀疏核心专门加速嵌入
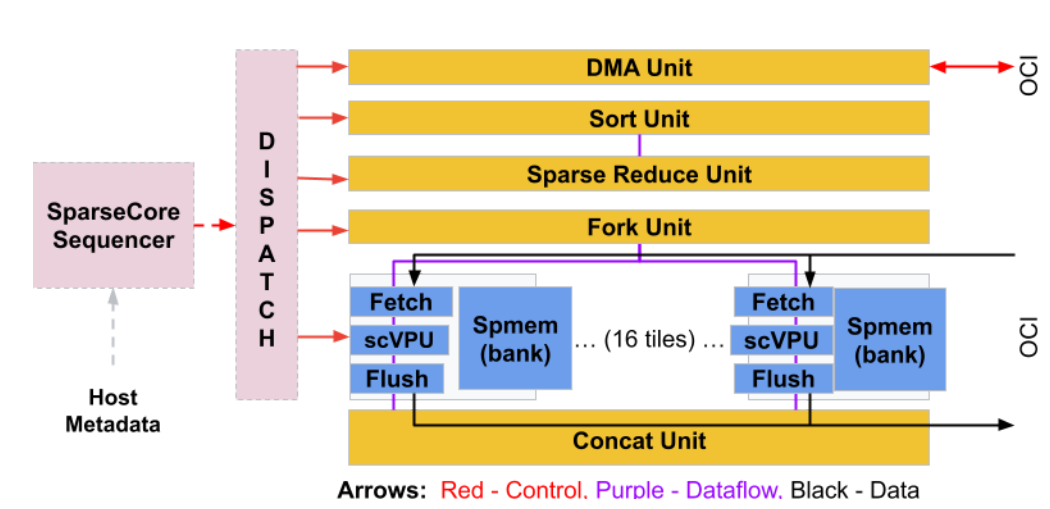
谷歌机器学习工作负载的重要组成部分是深度学习的推荐模型(DLRM)。DLRM严重依赖嵌入查找,这给全部的通信流量带来了内存带宽压力。为了加速嵌入,TPU v4包含了专用的稀疏核心,以简单的数据流方式工作,并通过互连形成运算核心的海洋。与CPU和TPU v3相比,稀疏核心在仅增加约5%的面积和功耗的情况下,将嵌入性能提高了5-7倍。如果不使用稀疏核心,把嵌入放在CPU内存中,整体TPU v4性能会下降5-7倍。
生产工作负载的性能
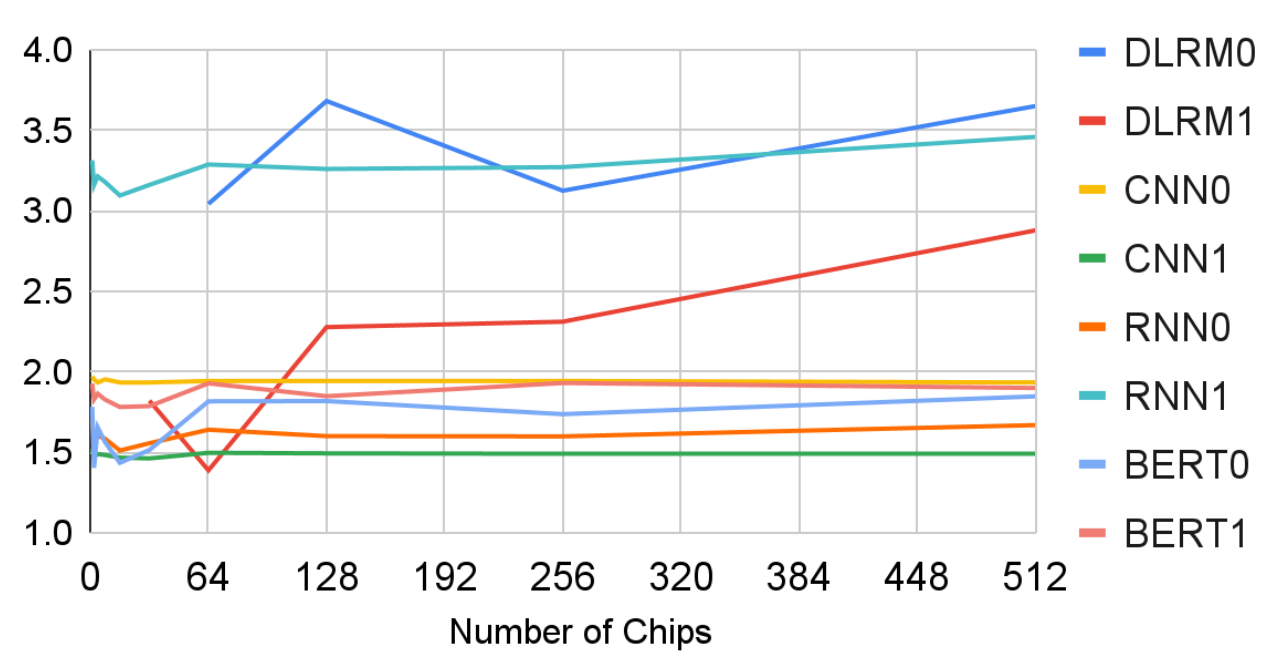
在八个生产工作负载下,TPU v4相比TPU v3性能显著提升。如图3所示,在相同规模下,速度提高了1.5到3.5倍。尤其是DLRM,受益于光互连增强的双向带宽和稀疏核专用加速,性能大幅提升3.0-3.5倍。令人惊讶的是,一个RNN工作负载在TPU v4上的运行速度提高了3.3倍,这得益于增大的缓存内存带宽。
结论
TPU v4中的光开关和稀疏核心,实现了扩展到4096芯片的同时,提高了可靠性、效率并满足了机器学习工作负载的需求。相比以前的版本,TPU v4 在谷歌生产环境中表现出大幅提升的性能。这种专用架构的设计适应了机器学习领域的快速变化。
参考文献
[1]Jouppi, N., Kurian, G., Li, S., Ma, P., Nagarajan, R., Nai, L., Patil, N., Subramanian, S., Swing, A., Towles, B., Young, C., Zhou, X., Zhou, Z., & Patterson, D. A. (2023). TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings. Proceedings of the 50th Annual International Symposium on Computer Architecture (ISCA '23), 1-14. https://doi.org/10.1145/3579371.3589350
 微信公众号
 bilibili
 微信视频号