


摘要
本文探讨了英伟达和苹果如何推动紧密集成的异构计算架构的发展,通过高带宽互联和共享内存统一CPU、GPU和其他加速器,以实现前所未有的性能和效率。异构计算代表着计算架构发展的趋势,其灵活的处理器组合和软硬件协同设计,能够大幅提升效率,拓展应用领域。
引言
异构计算架构结合不同类型的处理器,正在成为实现高性能计算的关键。以英伟达和苹果为代表的科技企业,正在引领这一计算架构革命。通过在系统层面无缝集成CPU、GPU及其他专用加速器,并对整个软硬件栈进行全面优化,异构计算系统可以实现巨大的性能突破和效率提升。本文旨在深入探讨英伟达和苹果在异构计算发展过程中所起的领军作用。
英伟达的GPU通用计算先见之明
2007年,英伟达推出CUDA编程框架,开启了GPU进行通用并行计算的新纪元。通用GPU(General Purpose GPU)计算模式首先在高性能计算领域获得广泛应用,可大幅加速科学计算等需要海量并行计算的工作负载。为进一步降低通用GPU计算的编程门槛,英伟达持续投入资源开发生态系统,提高工具链和库的覆盖面,将GPGPU推向主流应用。
深度学习催生GPU计算的黄金时代
深度学习的兴起为GPU提供了杀手级应用,其训练过程具有极高的并行性,对计算力需求巨大,正好能发挥GPU并行处理的优势。英伟达在高性能计算领域多年打造的GPU生态为其快速应对AI计算需求提供了关键基础。英伟达实现了GPU在AI领域的高速发展。
高速互联与智能网络接口
高速互联技术如英伟达自主研发的NVLink可以实现紧密耦合的统一GPU集群。收购迈伦科技(Mellanox)后,英伟达获得领先的高速网络技术,进一步加强在数据中心级别的GPU连接。英伟达还发展智能网络接口卡(Data Processing Unit,DPU),以进一步优化数据中心网络基础设施,提供安全可靠的GPU虚拟化。
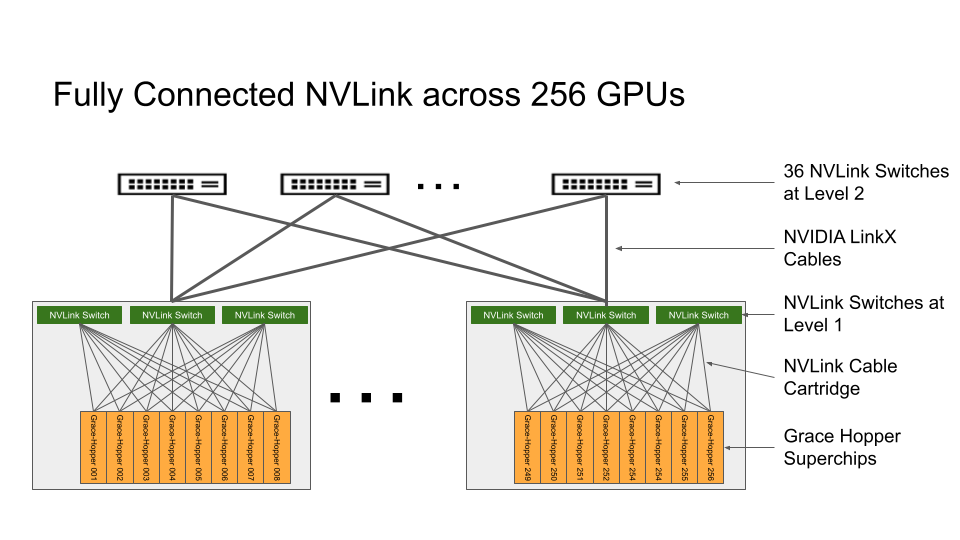
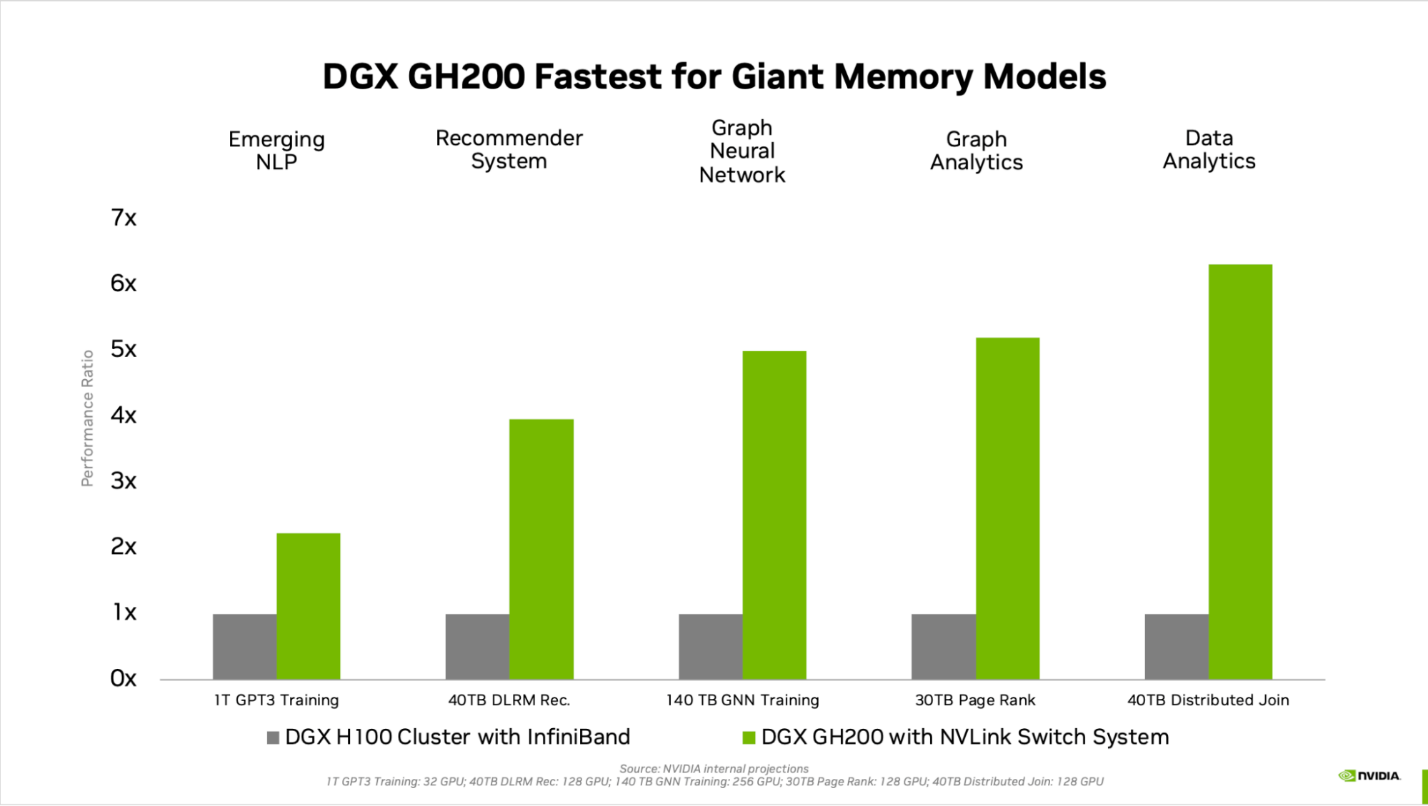
图2. 大内存AI工作负载的性能比较(来源:英伟达)
统一内存架构提升性能
在异构系统中,通过共享内存和缓存一致性等机制可以实现更紧密的CPU-GPU集成,相比分立架构带来重大性能提升。英伟达的Grace处理器采用新型互联和内存架构,实现CPU和GPU之间900GB/s的超高带宽。苹果自主研发的M系列芯片实现了CPU和GPU的无缝内存共享和统一。
尽管收购ARM的计划未实现,但英伟达仍然与ARM保持着密切合作关系,因为两家公司在x86占主导地位的形势下有共同的竞争对手。在今年发布的Grace Hopper架构GH200芯片中,英伟达使用了900GB/s的超高带宽实现了CPU与GPU的链接,并支持缓存一致性,使GPU可以比PCIe Gen5快7倍的速度访问CPU端的480GB共享内存。

这样的架构非常适合大规模语言模型的应用。当前英伟达GPU的内存最大为96GB,未来将推出144GB。但是否必须将内存集中在GPU端呢?事实上,苹果M2 Ultra芯片的GPU可以以800GB/s的带宽访问CPU端的192GB内存,比单个英伟达GPU支持的内存空间更大,因此被拿来作为低成本的AI开发平台。新发布的M3 Max使Macbook Pro拥有高达128GB的共享内存,也可以运行比普通显卡更大的语言模型。
软硬件协同设计驱动持续创新
英伟达和苹果基于软件和应用需求定制硬件,而不是被限于现有规格,采用前瞻性的联合设计方法。通过构建相关生态系统并持续进行软硬件协同优化,充分发挥异构平台的协同计算能力。这种设计理念催生了集成的异构计算模式,开启了高性能计算的新篇章。
结论
异构计算架构的兴起预示着计算系统发展的新趋势。其灵活的专用处理器组合与软硬件协同设计手段,可以实现计算系统的跨越式突破。英伟达和苹果正引领这一行业大踏步迈向高度集成和优化的异构计算新时代,必将催生计算效率和系统能力的重大飞跃,开拓无限应用可能。
 微信公众号
 bilibili
 微信视频号