


引言
人工智能和计算能力的需求正在快速增长。随着AI模型在复杂度和能力上的指数级增长,半导体行业面临着交付能够处理日益复杂计算工作负载同时保持能效的处理器这一挑战。本文探讨CMOS技术如何通过持续创新而演进,并考察能够实现未来缩放的架构[1]。
01
AI计算的发展
计算领域已经经历了由人工智能驱动的转变。训练现代AI模型所需的计算资源在几年前还难以想象。计算能力的超指数级增长不仅反映了渐进式改进,更体现了在并行处理和专用硬件设计方法上的根本性转变。

图1:从1950年到2020年著名AI模型训练计算需求的爆炸式增长,显示了向深度学习时代的过渡,其中计算需求急剧增加。数据表明,以FLOP衡量的训练计算量已从适度水平增长到最先进模型的超过10^26次运算。
这一AI爆发的推动因素包括擅长高度并行化运算的专用架构。最初为渲染设计的GPU找到了作为AI加速器的新用途。TPU代表了专门为神经网络训练和推理核心的矩阵运算而优化的专用芯片。像亚马逊Trainium芯片这样的ASIC展示了云服务提供商如何设计定制芯片以满足其独特的计算需求。半导体行业在扩展晶体管密度和提高性能效率方面的能力对于实现这些AI突破发挥了核心作用。
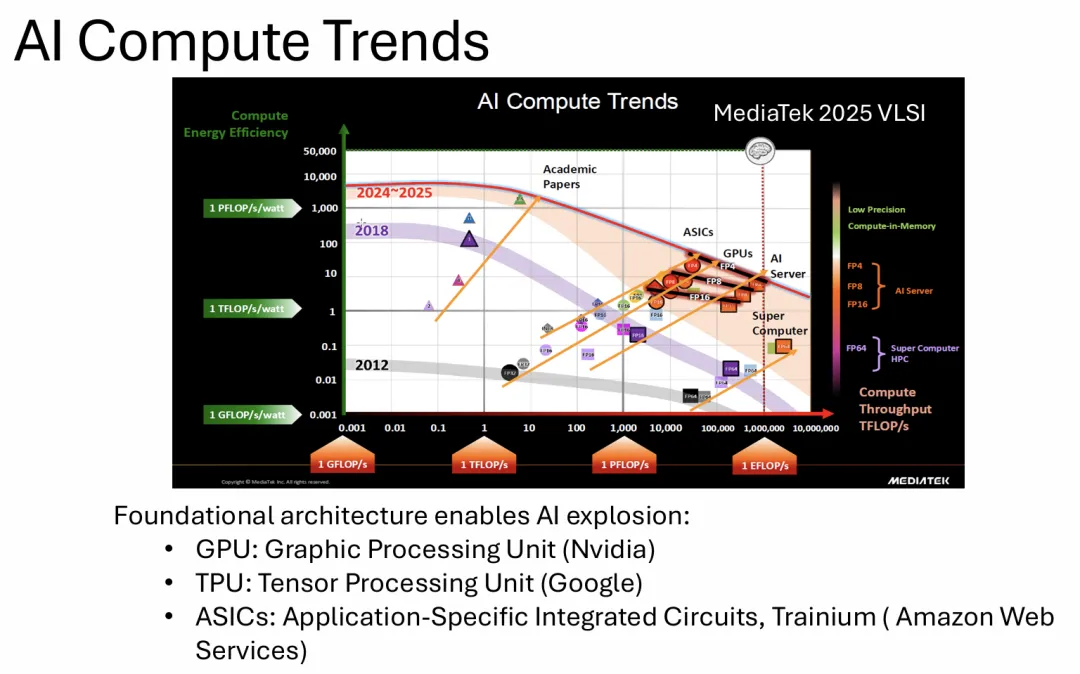
图2:来自联发科的图表显示了从2012年到2024-2025年的AI计算趋势,将不同的计算架构(包括学术论文、ASIC、GPU和超级计算机)与计算能效和吞吐量指标进行映射。发展清楚地表明,专用架构在以PFLOP每瓦和TFLOP每秒衡量的效率方面取得了优异表现。
02
通过创新实现CMOS技术演进
半导体行业通过架构创新结合设计工艺协同优化持续提供性能改进。在每一代CMOS架构中,研究人员和工程师发现了多种途径来增强性能、降低功耗、提高面积密度、降低成本并加快上市时间。这种多方面的优化方法使得即使在接近基本物理极限时也能继续取得进展。
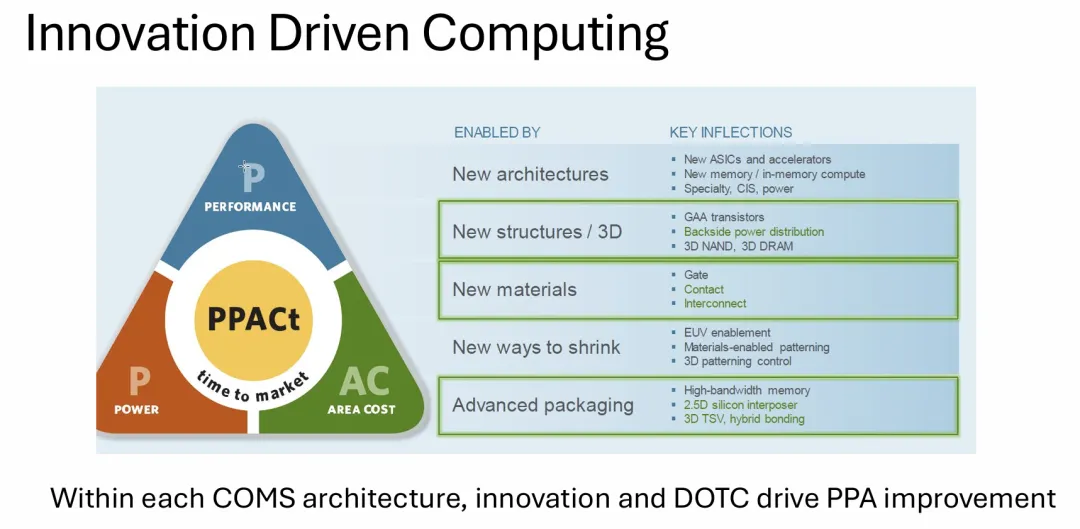
图3:来自应用材料公司的图表说明了创新如何通过新架构、3D结构、新材料、先进缩放技术和先进封装来驱动计算。PPACt(性能、功耗、面积成本和上市时间)的核心概念代表了必须通过前端工艺、后端互连和设计工艺协同优化特性的共同优化来平衡的关键指标。
硅技术的历史演进揭示了一种模式,即主要创新在达到成熟之前大约能够提供十年的显著效益。双极晶体管让位于平面CMOS,后者融合了应变硅和高k金属栅极等材料创新。随后是向3D FinFET结构的转变,然后是纳米带和纳米片全栅极晶体管,现在正朝着互补FET发展,并最终将2D材料集成到CFET架构中。
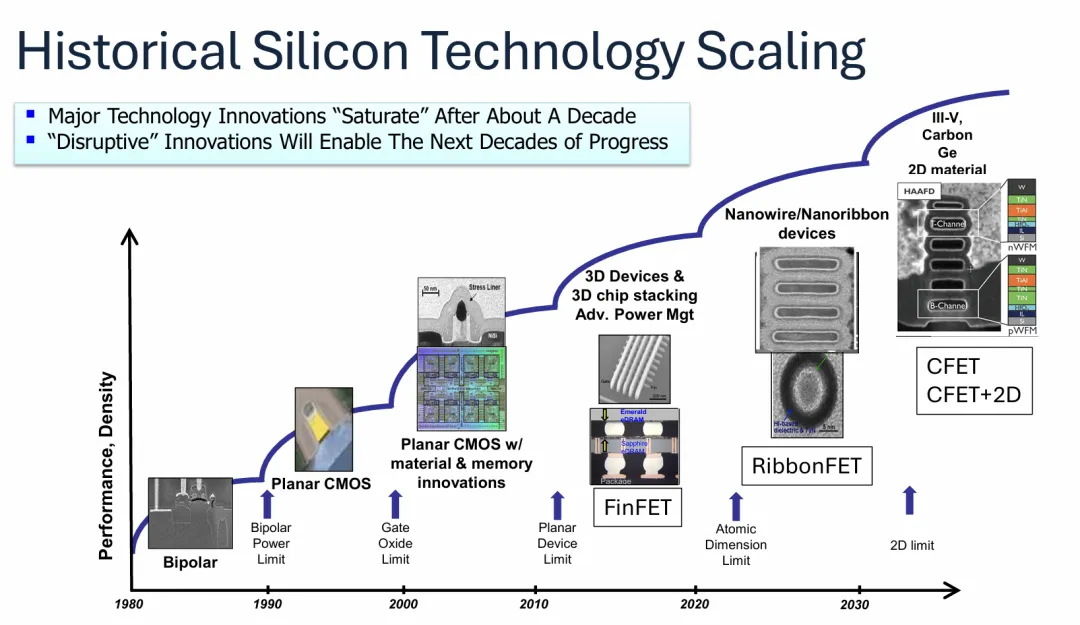
图4:C.-H. Lin的这一路线图显示了从1980年的双极晶体管到各种极限(包括栅氧化层、平面器件、双极功耗、原子维度)的演进,并在2030年接近2D极限。时间线说明了每次架构转变如何实现持续缩放:从平面CMOS到FinFET再到RibbonFET,并进一步发展到CFET和带有2D材料的CFET。
03
平面CMOS创新
平面CMOS时代带来了两项特别有影响力的创新,将其可行性延伸到最初预期之外。应变硅工程通过引入机械应力改变晶格结构,实现了出色的PMOS沟道迁移率。这种应变工程使电子和空穴能够更自由地通过沟道移动,直接改善了晶体管性能。
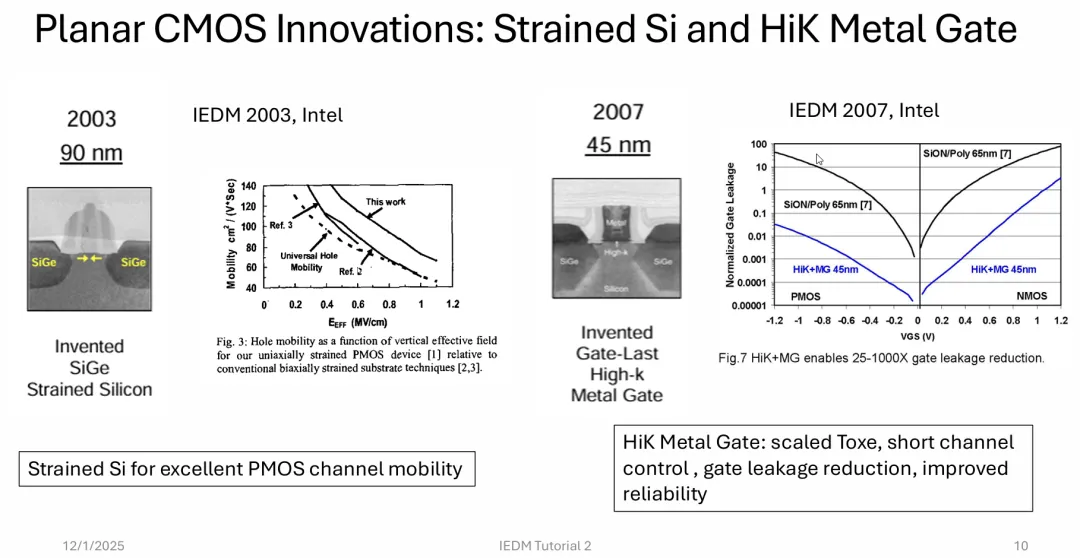
图5:来自英特尔2003年和2007年IEDM论文显示了使用SiGe源漏区域引入应变硅(左)和高k金属栅极创新(右)。应变硅工作展示了与通用空穴迁移率和传统双轴应变衬底技术相比,空穴迁移率显著提高。高k金属栅极实现了25到1000倍的栅极漏电减少,同时允许缩放等效氧化层厚度并改善短沟道控制。
高k金属栅极技术代表了平面CMOS的另一个分水岭时刻。通过用高介电常数材料和金属栅极替代传统的二氧化硅栅介电层,工程师实现了缩放的等效氧化层厚度,同时大幅降低了栅极漏电流。该技术还改善了短沟道控制并增强了可靠性,同时解决了多个挑战。这些创新的结合使平面CMOS能够在比许多人预测的时间更长的时期内保持竞争力。
04
FinFET的转变
向FinFET技术的转变标志着从2D到3D晶体管结构的根本架构转变。通过将栅极环绕垂直硅鳍片的三侧,FinFET实现了对沟道更好的静电控制。这种优越的栅极控制直接转化为性能优势,随着晶体管继续缩小,这一优势变得越来越重要。
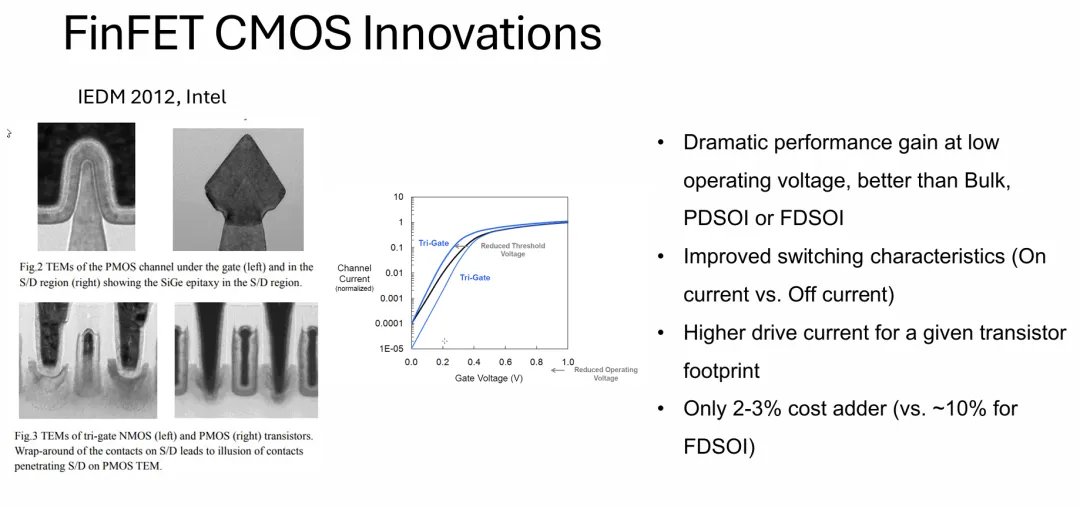
图6:来自英特尔2012年IEDM论文的详细横截面图像显示了源漏区域具有SiGe外延的PMOS沟道结构(上)和具有环绕接触的三栅NMOS和PMOS晶体管(下)。电学特性表明,三栅FinFET相比早期技术实现了降低的阈值电压,同时保持了出色的开关特性。
FinFET在低工作电压下相比体硅、部分耗尽绝缘体上硅或全耗尽绝缘体上硅替代方案提供了显著的性能提升。改善的开关特性意味着更好的导通电流与关断电流比率,使电路更节能。在给定晶体管占用面积下更高的驱动电流允许设计人员在相同面积内封装更多性能。也许最值得注意的是,FinFET技术相比平面CMOS仅需要适度的2%到3%的成本增加,使其在经济上可行,尽管结构复杂性增加。
随着FinFET技术的成熟,额外的创新扩展了其能力。智能超缩放方法优化了鳍片尺寸和间距以最大化密度。高迁移率沟道材料改善了载流子传输。极紫外光刻减少了掩模步骤,加快了周期时间,并通过实现更简单的图案化和更少的工艺步骤提高了可靠性和良率。
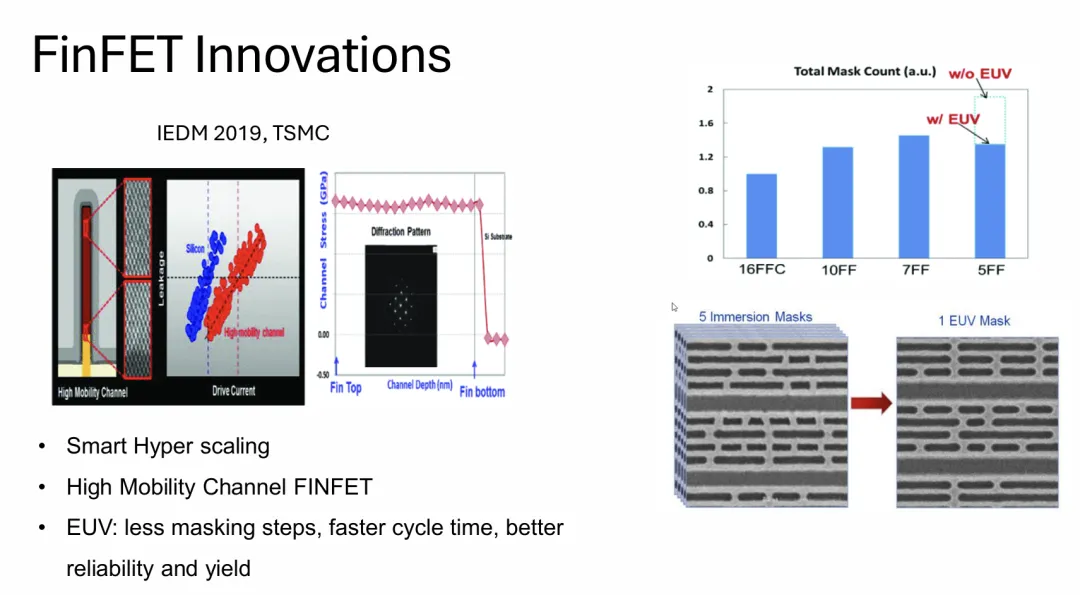
图7:来自台积电2019年IEDM论文的数据展示了三项关键的FinFET创新。左侧面板显示了如何通过仔细优化硅和锗分布的高迁移率沟道改善驱动电流。中心显示了比较需要五个掩模的浸没式光刻与仅需一个掩模的EUV的衍射图案。右图说明了随着EUV引入,从16FFC到5FF的连续技术代次中总掩模数量如何减少。
通过将传统节距缩放与灵活的鳍片配置相结合的设计工艺协同优化带来了进一步的改进。通过提供六种阈值电压选项和允许每个晶体管不同鳍片数量的FinFlex架构,晶圆厂可以满足从节能片上系统设计到高性能计算应用的多样化需求。
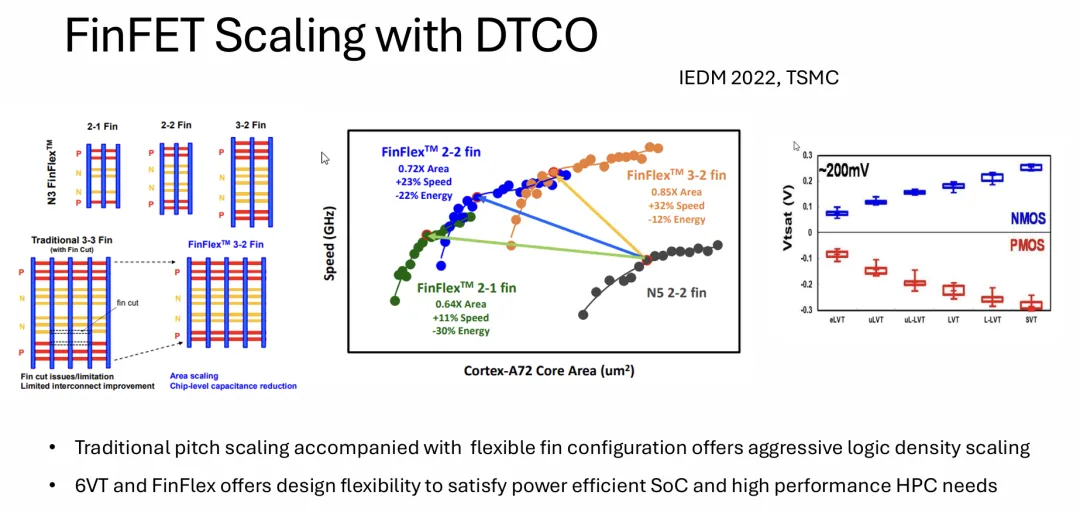
图8:台积电2022年IEDM数据显示传统节距缩放如何与灵活的鳍片配置相结合,实现了积极的逻辑密度缩放(左)。具有二鳍和三鳍选项的FinFlex方法提供了不同的面积-速度-能量权衡(中心)。六种阈值电压选项为节能SoC和高性能HPC应用提供了所需的设计灵活性(右)。
05
全栅极环绕RibbonFET技术
全栅极环绕晶体管代表了超越FinFET的下一个主要架构演进。通过在所有四侧完全用栅极材料环绕沟道,这些器件实现了比FinFET的三侧栅极更好的静电控制。英特尔的RibbonFET实现使用堆叠的水平纳米带或纳米片来创建这种全环绕栅极结构。
RibbonFET晶体管与背面功率传输网络和多种单元高度选项的结合在所有关键指标上实现了显著改进。英特尔展示了其Intel 18A技术节点相比上一代在等效功率水平下实现了约25%的更高性能、30%的面积缩放,以及在等效频率下36%到38%的功耗降低。
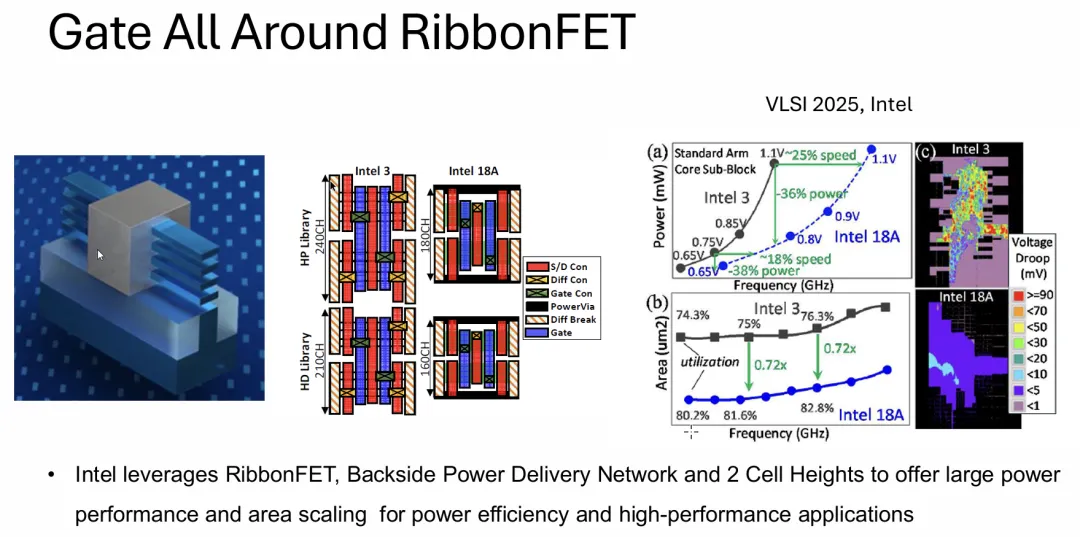
图9:英特尔VLSI 2025演示展示了带有背面功率传输的RibbonFET结构(左),HP库和HD库的两种不同单元高度选项(中心),以及与标准ARM核心子模块相比的性能优势。数据表明Intel 3和Intel 18A技术之间有25-36%的速度改进和38%的功耗降低,面积利用率从约75%提高到超过82%,实现了0.72倍的面积缩放效益。
台积电的纳米带方法类似地利用全栅极环绕结构,同时引入NanoFlex技术,该技术调节纳米片宽度以实现最佳的性能-功耗-面积特性。短单元库针对面积和能效进行优化,而选择性使用高单元库可以提升频率以满足苛刻的设计目标。
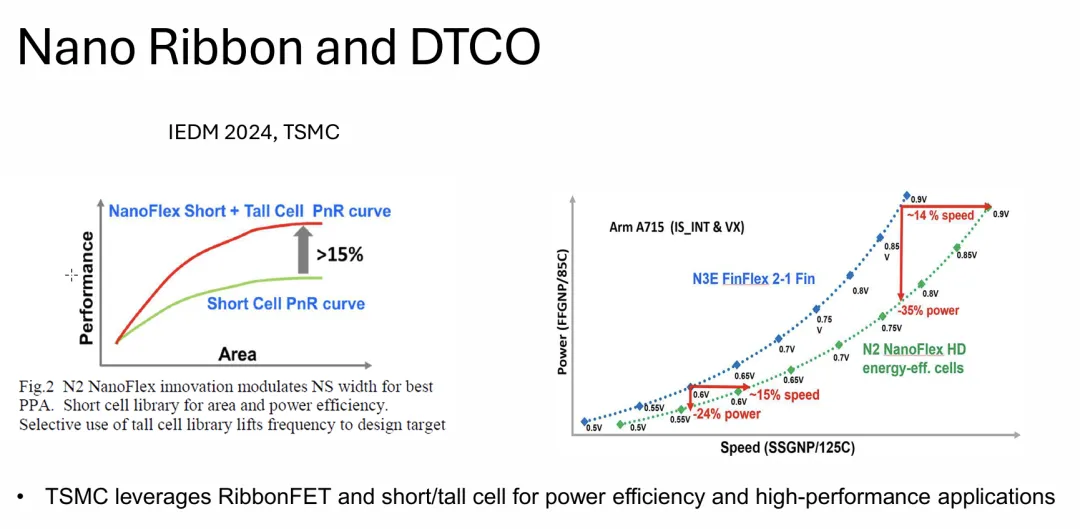
图10:台积电IEDM 2024论文展示了N2 NanoFlex创新如何调节纳米片宽度,通过使用高单元实现超过15%的性能改进(左)。右侧面板显示N2 NanoFlex高密度能效单元相比N3E FinFlex单元提供约15%的速度改进或24%的功耗降低,同时保持与已建立设计方法的兼容性。
06
未来缩放挑战与解决方案
随着单元高度和金属节距的物理尺寸缩放继续放缓,行业必须通过越来越复杂的前端器件结构、后端互连和设计工艺协同优化特性的共同优化来平衡性能、功耗、面积、成本和上市时间。包括带有NanoFlex的纳米片、叉片晶体管和背面功率传输网络在内的多种架构选项共存,以满足不同应用的多样化需求。
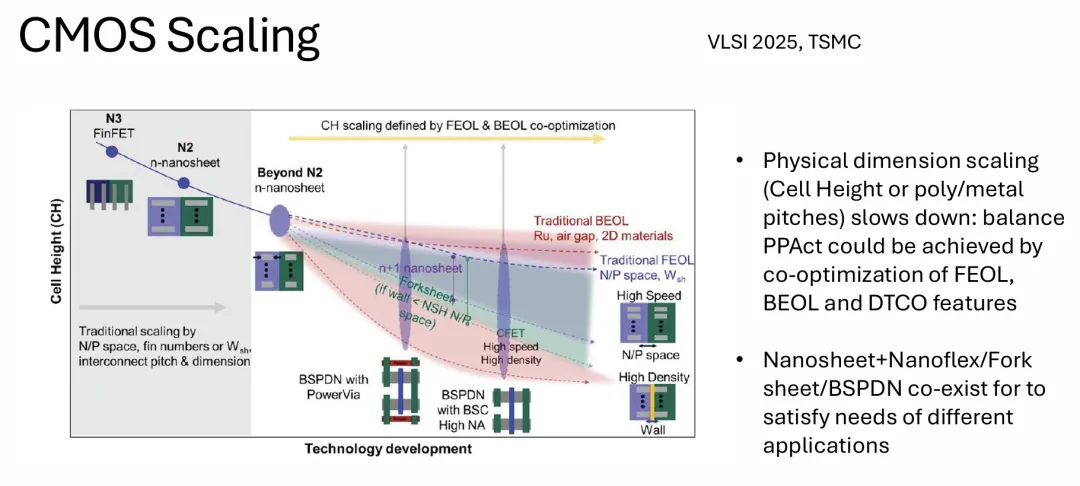
图11:来自台积电VLSI 2025演示的路线图显示了单元高度缩放如何越来越多地由前端和后端的协同优化而非简单的尺寸缩小来定义。超越N2纳米片,前进的路径包括叉片架构、具有高速和高密度变体的CFET,以及最终结合背面功率传输与埋入式功率过孔或背面接触加高纵横比纳米片的解决方案。
07
叉片晶体管
叉片技术代表了传统全栅极环绕晶体管与完全互补FET集成之间的中间步骤。关键创新涉及在NMOS和PMOS器件之间插入介电壁,允许它们彼此更紧密地放置。这减少了必须为隔离而保持的间距,实现了显著的面积减少。
已经出现了两种主要的实现方法。壁优先流程在工艺早期插入介电壁,对标准全栅极环绕流程的修改最少,但导致形成三栅结构,其中栅极仅环绕面向壁的沟道的三侧。壁后置流程在工艺后期使用二氧化硅插入壁,该二氧化硅可以在替换金属栅极形成期间部分回蚀,允许功函数金属沉积在面向沟道的壁表面。这创建了具有更好短沟道控制的欧米茄栅结构,同时保持更宽的纳米片尺寸。
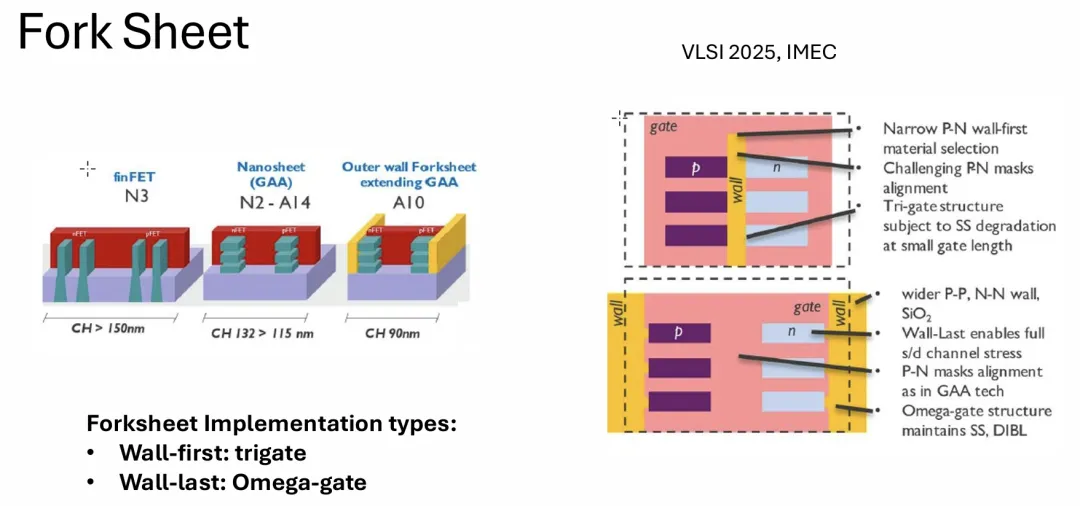
图12:IMEC的VLSI 2025论文比较了两种叉片实现方法。壁优先方法使用窄P-N间距,具有挑战性的掩模对准,并创建可能受短沟道退化影响的三栅结构。壁后置方法使用更宽的P-P和N-N壁与二氧化硅,实现完整的源漏沟道应力,并创建保持亚阈值摆幅和漏极感应势垒降低特性的欧米茄栅结构。
壁优先方法面临着三栅静电学的挑战,需要在短沟道效应和栅极电容之间进行权衡。介电壁还影响阈值电压,并可能导致不均匀的纳米片轮廓。优化工作集中在仔细选择壁材料和管理壁诱导效应与沟道应力之间的复杂相互作用。
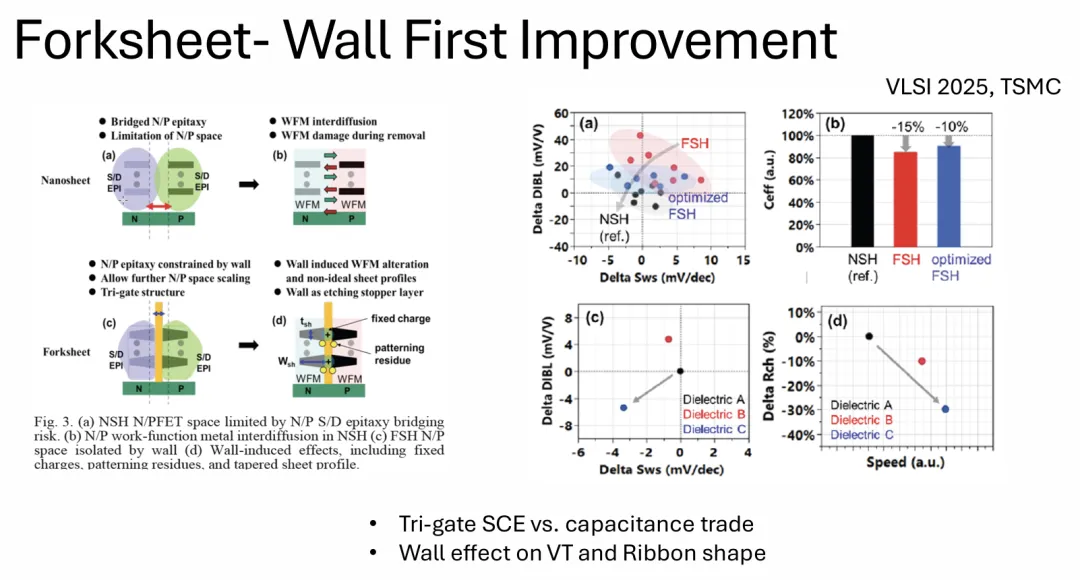
图13:台积电VLSI 2025数据说明了壁优先叉片的挑战和优化方法。问题包括由于壁桥接导致的N/P外延空间限制、壁附近功函数金属的互扩散、三栅结构敏感性,以及壁诱导的功函数金属改变导致的非理想片材轮廓。数据显示,通过仔细的介电选择,优化的叉片设计可以恢复性能,尽管必须仔细管理亚阈值摆幅和电容之间的权衡。
壁后置方法通过其欧米茄栅结构实现了优越的静电学,其中栅极可以在壁界面处完全环绕沟道。这种方法还允许更有效的源漏应力施加器,因为壁是在外延生长之后插入的。模拟证实,欧米茄栅结构相比三栅实现提供了改善的短沟道控制和更高的驱动电流。
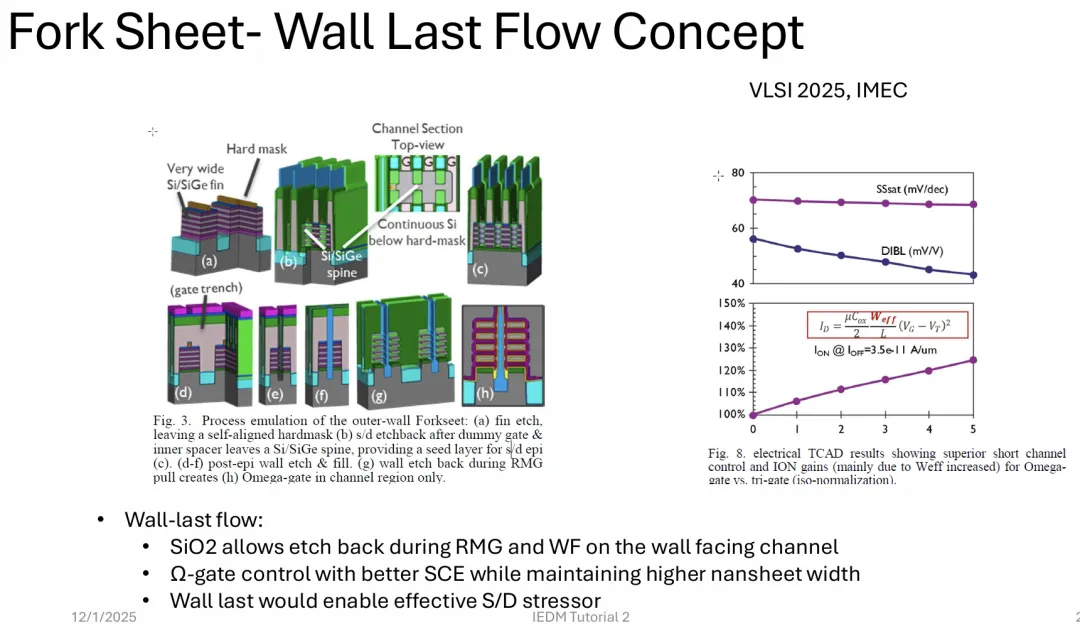
图14:IMEC的VLSI 2025论文详细介绍了壁后置叉片工艺流程,使用非常宽的SiGe/Si鳍片和硬掩模,留下自对准的SiGe脊作为源漏外延的种子层。在虚拟栅极和间隔层形成之后,鳍片之间的内部间隔层充当介电壁的基础。后续处理通过在替换金属栅极形成期间控制回蚀,仅在沟道区域创建欧米茄栅结构。TCAD模拟显示,这种欧米茄栅方法保持了出色的亚阈值特性,并通过增加有效沟道宽度相比平面器件提供了超过20%的驱动电流改进。
08
互补FET架构
互补FET或CFET技术代表了也许是最具雄心的近期架构创新。通过垂直堆叠NMOS和PMOS晶体管,CFET相比传统的并排布局实现了显著的面积减少。早期预测表明相比积极缩放的纳米片或叉片有15%到20%的面积缩放,尽管这伴随着大量的工艺复杂性。
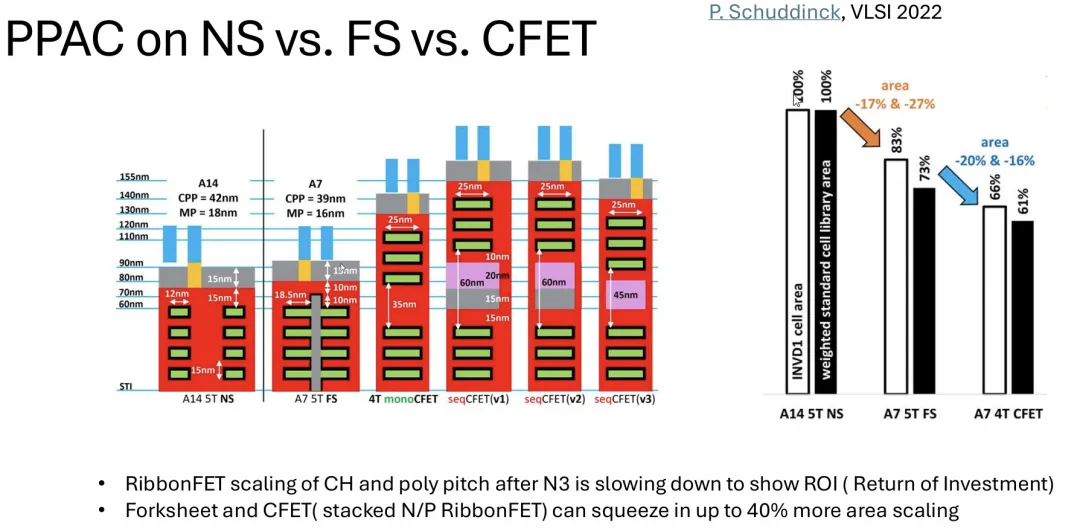
图15:P. Schuddinck在VLSI 2022上的这一比较显示了从A14 5T纳米片到A7 5T叉片再到4T CFET变体的演进。加权标准单元库面积从A14的100%下降到叉片的83%,某些CFET实现低至61%。右侧面板显示面积如何从100%缩放到低至66%,同时保持约42到39纳米的类似接触多晶硅节距,但单元高度大幅降低。
CFET的工艺挑战是巨大的,包括处理高纵横比结构、创建到垂直分离的NMOS和PMOS层的可靠互连、隔离源漏接触,以及实现适当的功函数方案以独立控制堆叠器件的阈值电压。这些复杂性转化为相比叉片替代方案更长的开发时间。
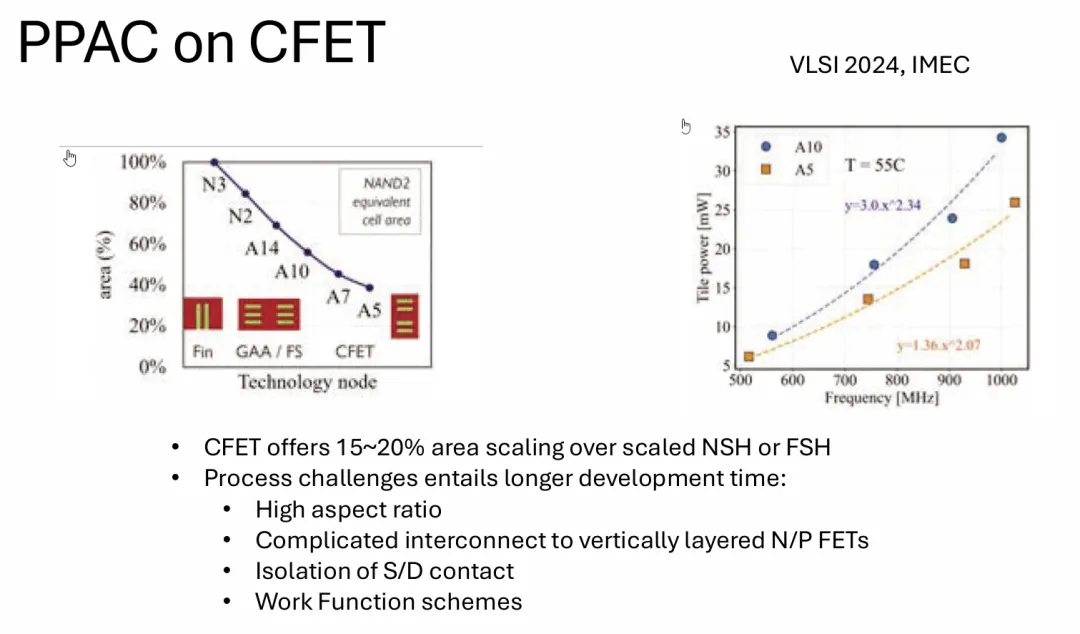
图16:IMEC的VLSI 2024数据显示CFET相比缩放的纳米片或叉片实现提供15%到20%的面积缩放,面积指标跟踪从N3到A14、A10、A7到A5的技术进展。然而,CFET面临重大工艺挑战,包括高纵横比、复杂的互连、源漏接触隔离和功函数方案复杂性。热影响也随频率增加,显示tile功率从500兆赫时的约9毫瓦扩展到1000兆赫时的超过30毫瓦(A10技术),A5技术按比例缩放。
已经展示了多种CFET集成方法。英特尔的方法使用背面局部互连,为NMOS和PMOS器件分别形成功函数,垂直金属化漏极局部互连,背面中间层接触,以及用于路由信号和电源的背面过孔和金属化。该架构能够独立优化每种器件类型,同时管理垂直集成的复杂性。
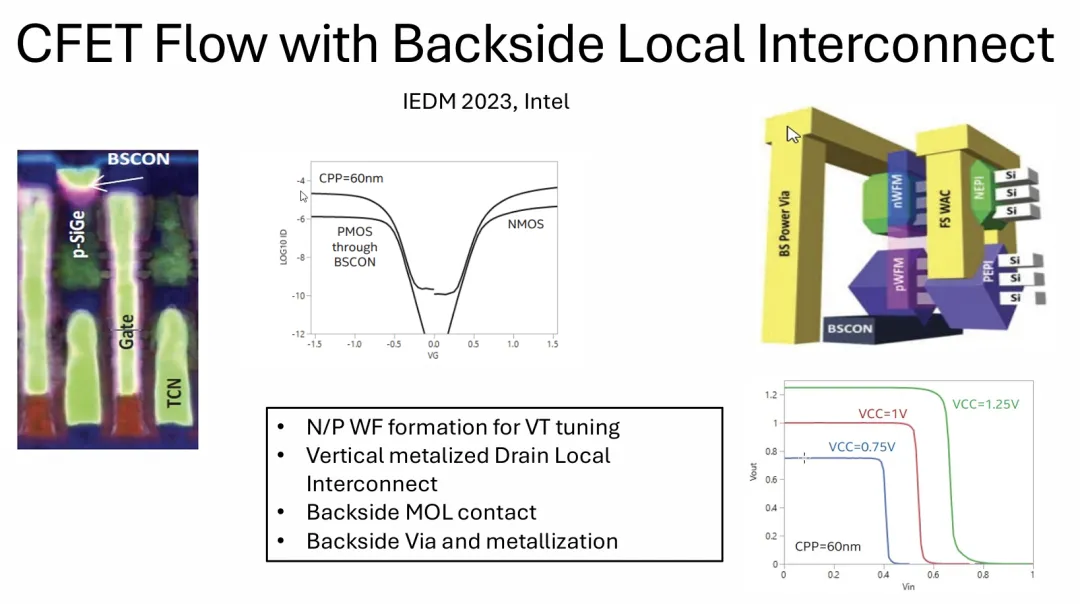
图17:英特尔IEDM 2023论文展示了其CFET实现,背面接触(BSCON)连接到P型SiGe下层晶体管,传统正面接触连接到上层N型晶体管(左)。电学特性显示通过背面接触的出色PMOS性能和适当的NMOS行为(中心)。3D示意图说明了背面功率过孔、垂直NMOS中间层互连和堆叠结构如何实现紧凑的反相器布局。紧凑的物理实现显示了所有关键组件,包括硅沟道、P-SiGe层、栅极和埋入式接触金属化。
台积电追求的是单片CFET集成,其中NMOS和PMOS器件在同一衬底上依次制造。这种方法需要精密的工艺控制,以防止在上层器件形成期间损坏下层器件。工艺包括衬底准备、SiGe/Si超晶格生长、纳米片堆叠图案化、浅沟槽隔离形成、栅极图案化、栅极间隔层沉积、源漏刻蚀、中间介电隔离、内部间隔层形成、NMOS和PMOS源漏的垂直图案化分别进行、每种器件类型的外延生长与隔离形成、NMOS源漏外延、内部间隔层着陆垫形成以实现平坦化、硅纳米片沟道释放、层间和高k介电层形成、通过功函数工程进行阈值电压调节、功函数金属和金属栅极沉积、源漏接触形成,最后是中间层和后端互连集成。
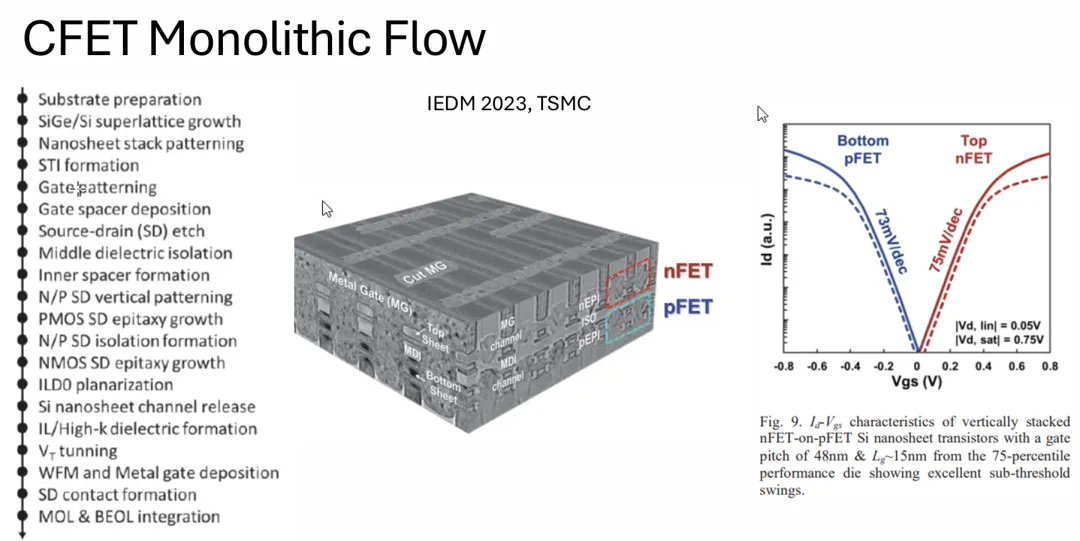
图18:台积电IEDM 2023单片CFET展示在左侧显示完整的工艺流程,中心的3D重建显示垂直堆叠结构,展示金属栅极、中间层互连、层间介电层以及底部PMOS和顶部NMOS的沟道区域。右侧的电学特性展示了两种器件类型具有相同线性和饱和漏极电压的出色亚阈值行为,显示了栅极节距为48纳米、沟道长度约15纳米的堆叠晶体管的适当独立控制。
台积电的持续改进引入了额外的工艺步骤以改善性能和可靠性。这些包括用于NMOS和PMOS器件独立阈值电压控制的垂直偶极图案化、垂直中间层漏极局部互连形成以降低电阻、晶圆翻转以实现背面处理、背面中间层接触形成,以及用于功率传输的背面后端互连集成。
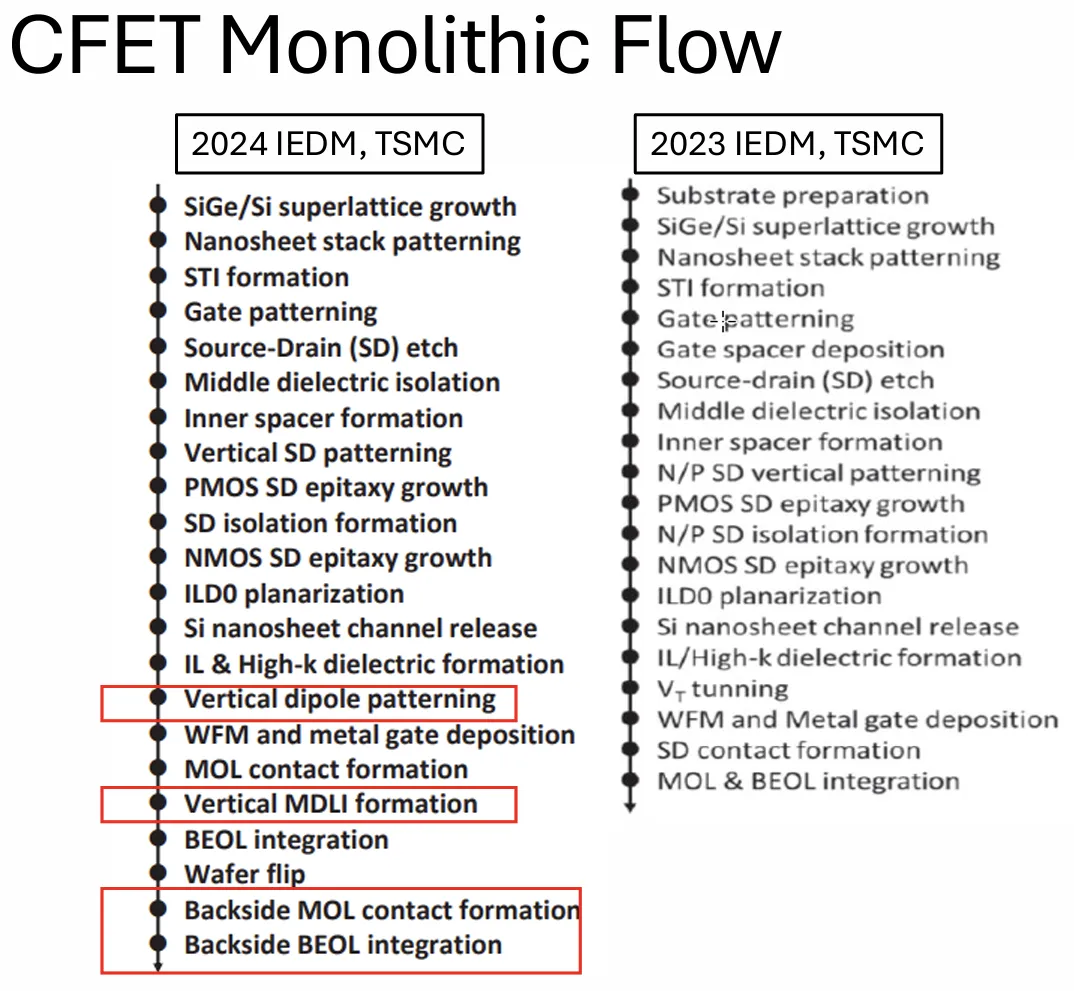
图19:比较台积电2024年和2023年IEDM论文揭示了工艺演进。2024年流程增加了用于独立阈值电压调节的垂直偶极图案化、垂直中间层漏极局部互连结构、用于背面访问的晶圆翻转、背面中间层接触形成,以及背面后端互连集成。这些增强通过降低电阻和改善器件优化实现了更好的性能,同时管理热约束。
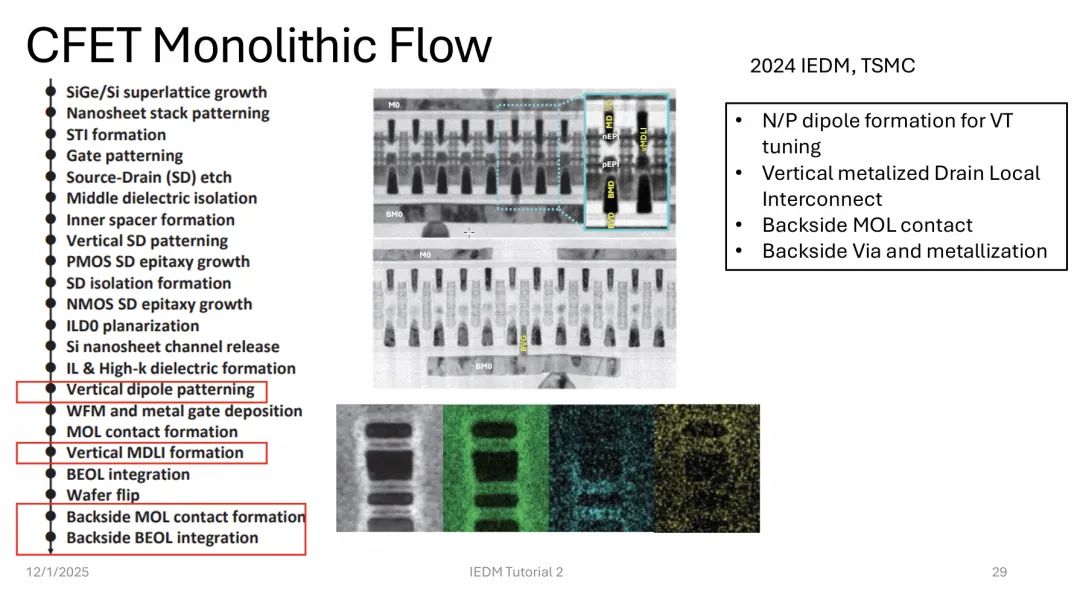
图20:台积电IEDM 2024论文显示了单片CFET的详细横截面,带有用于两种器件类型阈值电压控制的垂直偶极层(左上)、连接层间的垂直金属化漏极局部互连、背面中间层接触,以及背面过孔和金属化结构。制造的结构显示所有特征的出色定义,包括分离NMOS和PMOS区域的埋入式中间介电层、背面金属化漏极结构,以及具有适当隔离的顶部NMOS中间层漏极接触。元素映射确认了铝、铪和钛在接触和互连的预期位置的存在。
CFET能力的终极展示来自功能电路实现。台积电使用这种垂直集成架构制造了紧凑的反相器。布局显示了垂直漏极连接如何连接两种器件类型,而背面栅极连接和背面功率过孔实现了功率传输。电学测量展示了多个电源电压下具有尖锐转换和对称开关特性的适当反相器操作。
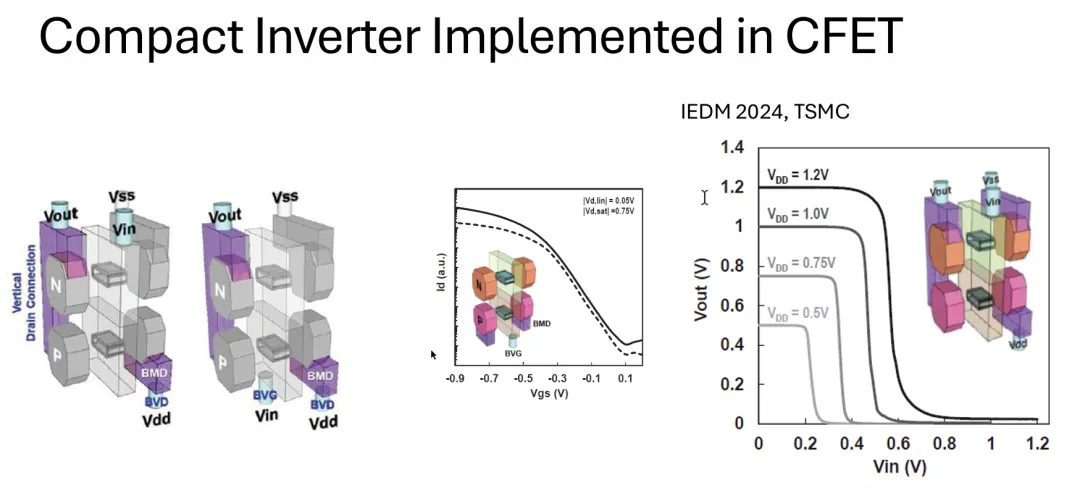
图21:台积电IEDM 2024紧凑反相器在CFET中的实现显示了3D结构,具有NMOS和PMOS层之间的垂直连接、背面栅极访问、背面电压供应和金属化漏极互连(左)。反相器传输特性展示了从0.5V到1.2V多个电源电压下具有尖锐转换的出色开关行为(右)。图显示了物理结构,具有埋入式栅极访问层、明确定义的NMOS和PMOS区域,以及单个垂直堆叠内所有组件的紧凑集成。
IMEC探索了另一种CFET方法,专注于通过仔细优化器件几何形状和材料来实现出色的静电控制。其工艺包括接地平面掺杂、多层堆叠外延生长、纳米片图案化、浅沟槽隔离、栅极图案化、用于分离NMOS和PMOS区域的中间介电隔离、源漏腔体形成、内部间隔层形成、作为保护的覆盖间隔层沉积、下层器件的底部结形成、接触隔离层、上层器件的顶部结形成、内部间隔层着陆垫零点形成以创建参考表面、用于每种器件类型独立阈值电压控制的双功函数金属图案化、正面的中间层漏极接触形成、正面过孔和M0金属化、与衬底薄化的键合以访问背面、底部介电隔离以分离背面特征、背面中间层漏极接触形成,最后是用于功率传输的背面过孔和M0金属化。
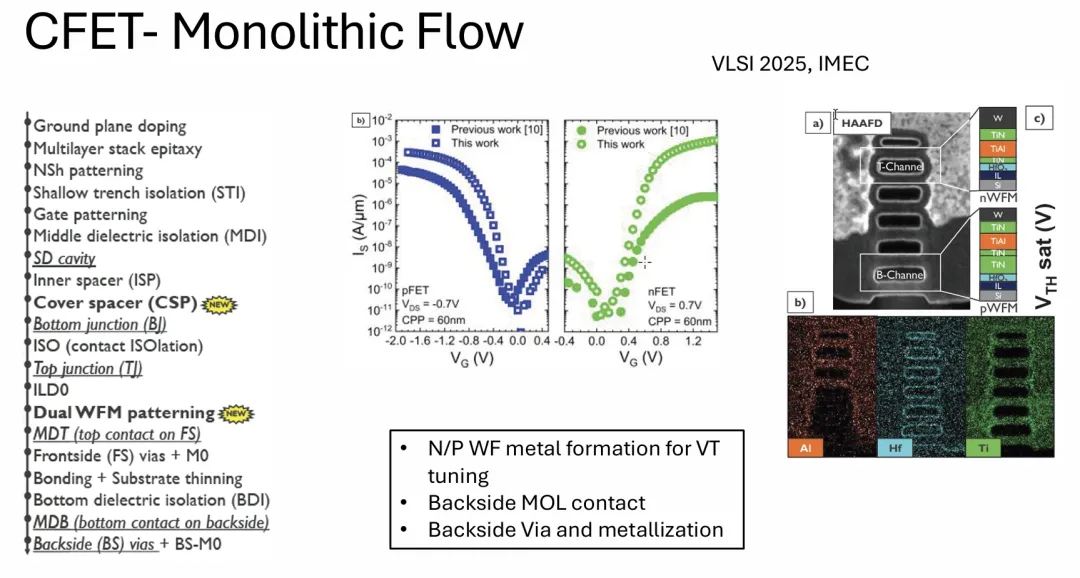
图22:IMEC的VLSI 2025 CFET实现详细介绍了其工艺流程(左),并展示了PMOS和NMOS器件的出色电学特性,通过不同的传输曲线表明器件类型之间的适当分离(中心)。横截面透射电子显微镜图像显示了高纵横比全栅极环绕结构,顶部N沟道和底部P沟道区域每个器件都有多个纳米片(右上)。能量色散X射线光谱映射确认了铝、铪和钛在栅极堆叠、接触和隔离结构中的正确放置(右下)。
09
超越传统CFET
展望更远的未来,研究人员提出了双CFET架构,可以垂直堆叠两个完整的CFET结构,可能使用2D材料作为沟道层以实现如此激进的缩放。像二硒化钨、二硫化钨和二硫化锆这样的2D材料提供了原子级薄的沟道,可以根据材料选择和掺杂作为N型或P型半导体。终极缩放极限可能涉及具有独立栅极控制的四个垂直堆叠器件,通过使用壁结构来管理应力并在相邻器件之间提供隔离。

图23:M. Hamada的IWJT 2021愿景显示了超越传统CFET的两条路径。左侧说明了具有2D沟道材料的CFET,其中二硫化钨或二硒化钨可以根据实现作为N沟道或P沟道材料。右侧显示了双CFET概念,其中两个完整的CFET结构垂直堆叠,在由分离器件的二氧化硅壁诱导的N沟道/P沟道区域中可能存在拉伸应力,通过仔细的应力工程在单个垂直堆叠中实现四个独立控制的晶体管。
10
信号和功率传输创新
随着器件架构向3D结构演进,互连和功率传输策略也得到了类似的进展。已经出现了三种主要的信号和电源路由方法。传统的正面信号和正面功率传输将所有互连放置在晶体管上方。正面信号和背面功率传输(通常称为PowerVia技术)在器件上方路由信号,同时通过穿透衬底的过孔从下方传输功率。最先进的方法使用背面信号路由,结合背面接触或环绕接触以及通过功率过孔的背面功率传输。
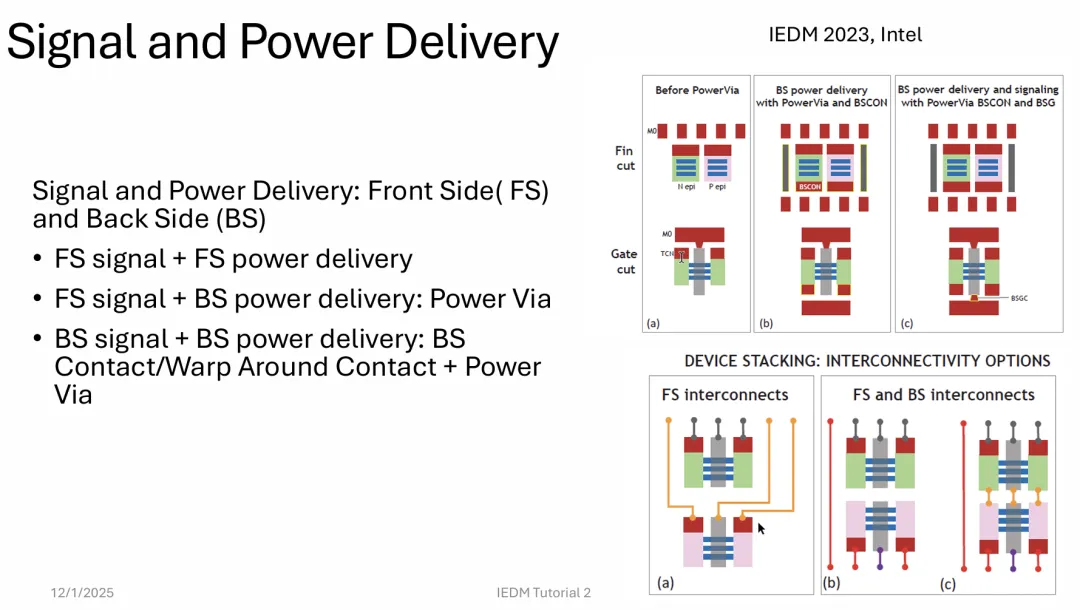
图24:英特尔IEDM 2023论文说明了功率和信号传输方法的演进。顶行显示了逐渐更复杂的解决方案:标准仅正面路由、使用PowerVia的正面信号和背面功率传输,以及最终使用背面接触和背面栅极路由能力的背面功率传输和背面信号路由。底行展示了器件堆叠如何从这些方法中受益,显示了仅正面互连、与标准堆叠的正面和背面互连组合,以及在多个层级使用正面和背面路由的先进实现。
11
背面功率传输网络
埋入式功率传输网络技术将功率轨移到晶圆背面,释放正面互连轨道用于信号路由。这实现了在相同最小金属节距下增加信号路由密度,或者放宽金属节距以改善可制造性和可靠性。该方法使用纳米硅通孔将背面功率网络连接到器件源极和漏极区域。
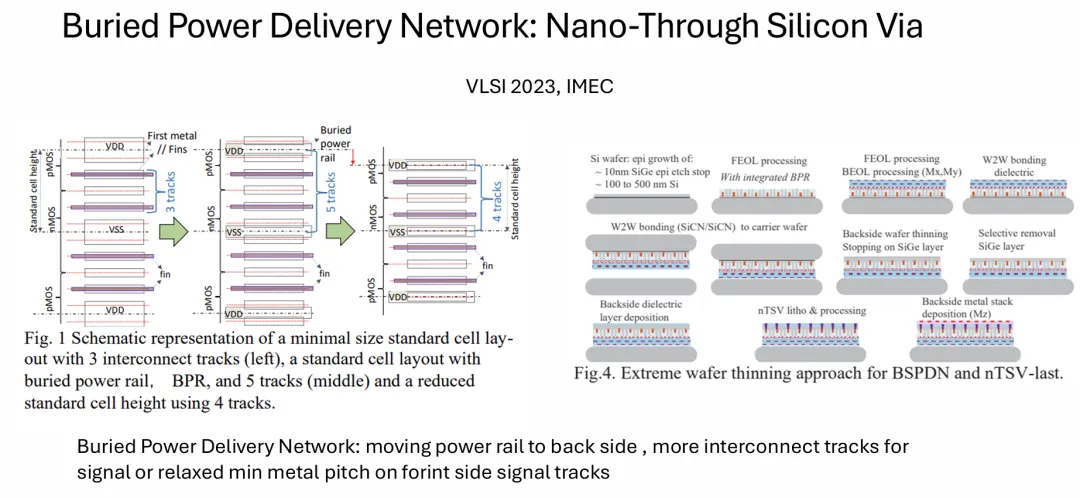
图25:IMEC的VLSI 2023演示比较了具有三个互连轨道的标准单元布局(左)、具有埋入式功率轨道实现五个轨道的标准单元(中间),以及使用四个轨道的降低标准单元高度实现(右)。右侧面板详细说明了背面功率传输网络集成所需的极端晶圆薄化工艺,显示外延层生长、晶圆到晶圆键合、背面晶圆薄化以访问埋入式特征、纳米硅通孔光刻和处理、背面介电层,最后是背面金属堆叠沉积。这一详尽的工艺实现了紧凑的布局,同时保持稳健的功率传输。
英特尔的PowerVia实现已经展示了显著的优势。其结合PowerVia和RibbonFET的Intel 18A技术相比Intel 3技术在恒定功率下提供18%到25%的速度改进、30%的面积缩放,以及在恒定频率下36%到38%的功耗降低。这些改进来自多个因素,包括功率分配网络中降低的IR压降、更好的单元利用效率,以及改善的功率相关可靠性。
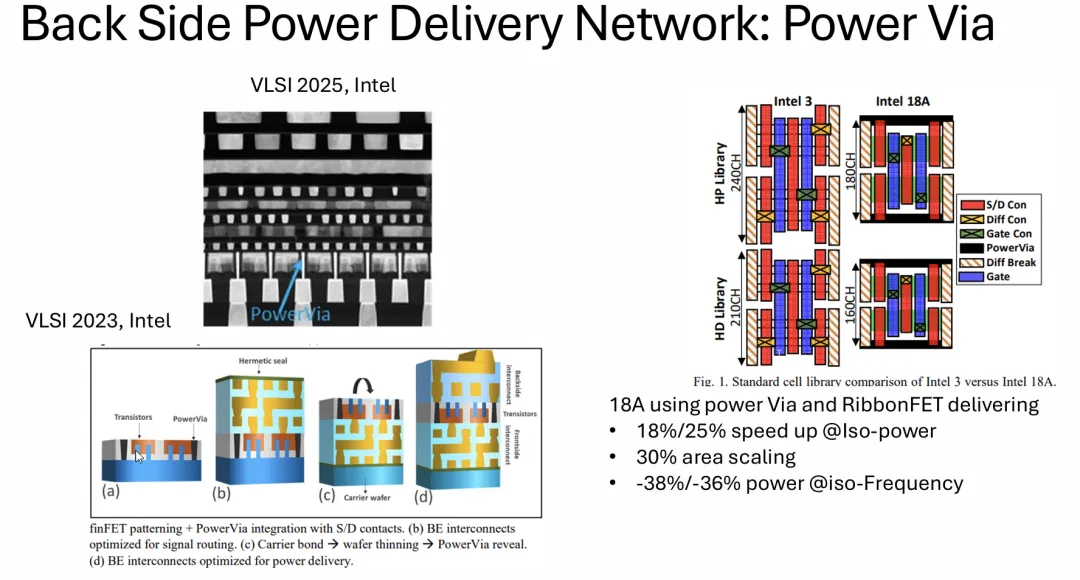
图26:英特尔VLSI 2025和2023演示展示了PowerVia实现。2023图像展示了PowerVia与FinFET源漏接触的集成,显示了用于信号路由的背面互连优化、载体晶圆键合和薄化以暴露PowerVia结构,以及专门针对功率传输优化的背面互连(左下)。2025数据比较了Intel 3与Intel 18A标准单元库布局,显示RibbonFET器件、背面功率传输和双单元高度选项的结合如何实现显著的性能和面积改进。数据展示了18-25%的速度提升、30%的面积减少,利用率从75%提高到超过82%,以及在恒定频率下36-38%的功耗降低。
实现背面功率传输的关键见解是,将功率轨移到背面允许在相同的整体单元高度下更放松的最小金属节距。这种放松的节距通过降低信号和功率网络中的IR压降来提高频率。更好的单元利用意味着更有效地使用可用硅面积。功率相关可靠性得到改善,因为更宽的金属线具有更低的电阻,减少了电迁移问题和电压降问题。
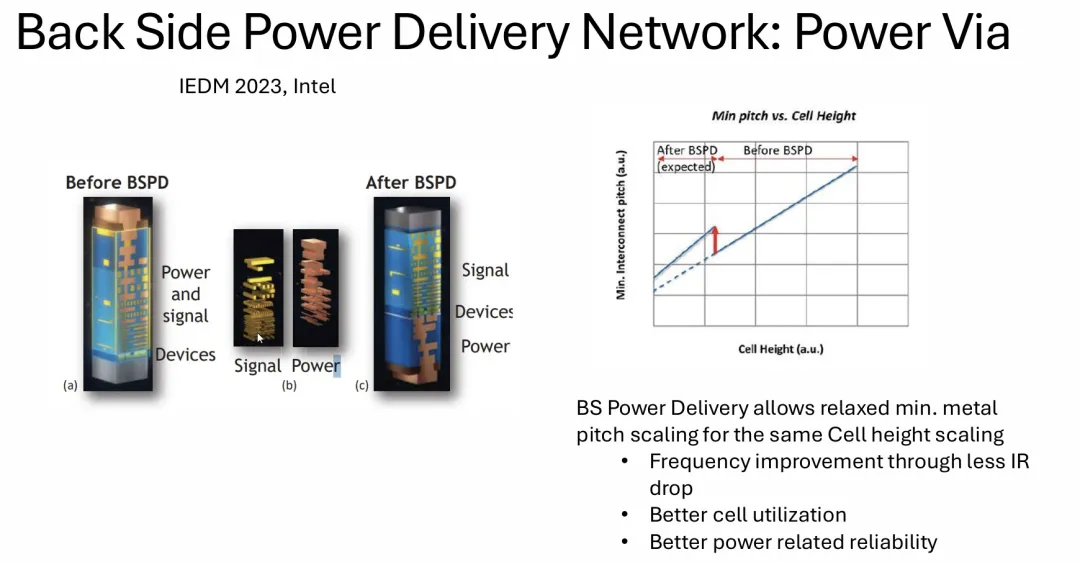
图27:英特尔IEDM 2023数据显示背面功率传输如何实现相同单元高度下更放松的最小互连节距(左)。在背面功率传输实现之前,需要激进的最小节距缩放来实现每个单元高度减少。在背面功率传输之后,可以用更放松的节距实现相同的单元高度,如从预期趋势线向上偏离所示。右侧面板说明了这如何工作:正面功率和信号都竞争路由资源时,节距必须最小化,但将功率分离到背面允许信号路由在更放松的节距下进行,通过降低IR压降改善频率和单元利用率,同时增强功率相关可靠性。
12
背面接触和环绕接触
对于CFET和其他先进架构,从下方直接连接到源漏区域的背面接触提供了额外的优势。英特尔的实现显示背面接触连接到P型SiGe下层PMOS晶体管,以及连接到上层NMOS晶体管的传统正面接触。背面接触保持了与正面接触器件相当的出色电学特性。
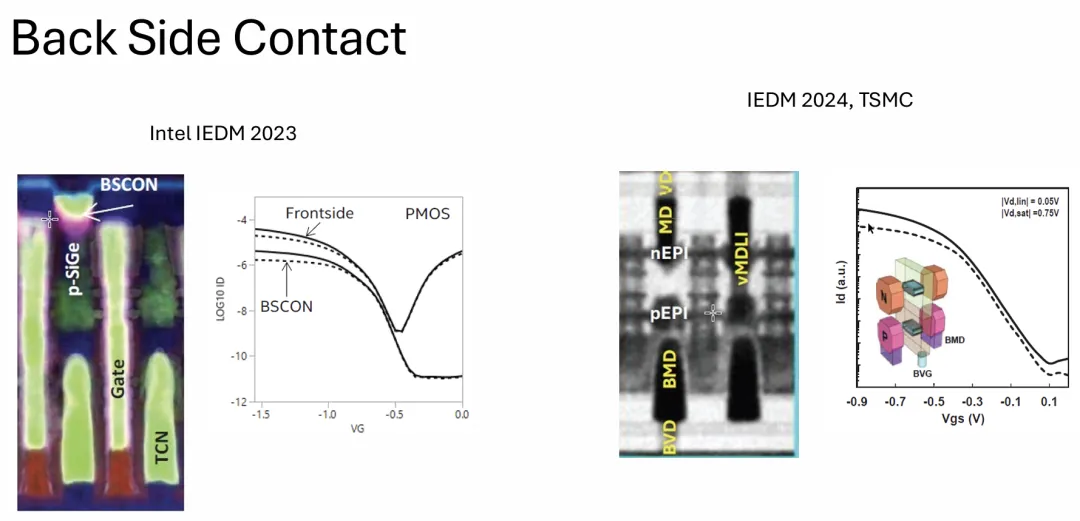
图28:英特尔IEDM 2023(左)和台积电IEDM 2024(右)论文都展示了背面接触技术。英特尔的方法显示彩色透射电子显微镜图像,背面接触穿透栅极和P型SiGe层到达下层晶体管,电学特性显示从背面接触的PMOS器件与从正面接触的器件性能相当。台积电的图像显示了其背面接触实现,具有垂直金属化漏极局部互连,展示通过背面中间层漏极局部互连结构,从下方接触的NMOS和PMOS器件都保持出色的亚阈值特性和适当的阈值电压控制。
环绕接触代表了一种更复杂的方法,其中接触延伸环绕源漏区域的多个侧面,而不是简单地从上方或下方连接。横截面图像显示N型硅和P型SiGe源漏区域,接触金属环绕结构以最大化接触面积。电学测量证实,环绕接触相比传统浅接触提供了优越的性能,PMOS器件在驱动电流方面显示特别显著的改进,NMOS器件显示良好的特性,尽管改进不如PMOS显著。
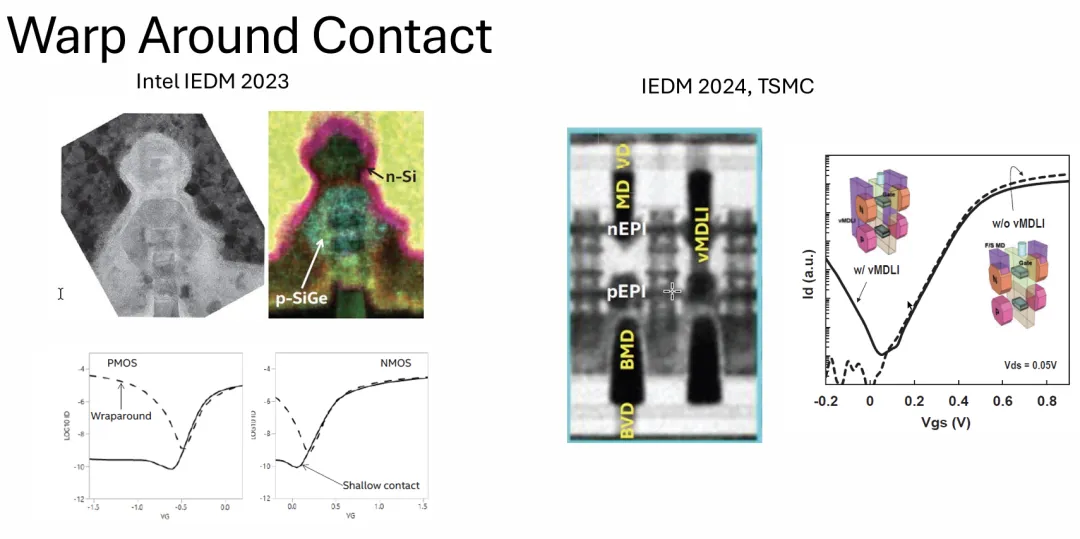
图29:英特尔IEDM 2023(左)和台积电IEDM 2024(右)的环绕接触技术展示显示透射电子显微镜图像,揭示接触金属如何环绕N型硅和P型SiGe源漏区域。电学特性表明,相比传统浅接触,环绕接触为PMOS器件提供了显著改善的驱动电流,NMOS也显示出优势,尽管不那么显著。台积电的实现显示了带有背面接触的垂直金属化漏极局部互连结构,当与这些先进接触方案结合时,展示了出色的亚阈值特性和适当的阈值电压控制。
13
CFET与背面功率传输的结合
终极集成将CFET器件堆叠与背面功率传输网络结合,以实现最大密度和性能。比较基于CFET的SRAM的不同路由策略的分析揭示了显著的权衡。单侧信号路由与背面功率传输网络实现了良好的结果,但双侧信号和功率路由提供了最佳的整体性能。对于6管SRAM与8管SRAM的CFET比较,具有双侧路由的CFET实现达到了与具有背面功率传输网络的单侧CFET相同的单元面积,但提供了2%的读取静态噪声裕度改进、65%的寄生电容减少、12%更快的读取访问、5%更快的写入速度、35%更低的读取功耗,以及17%更低的写入功耗。
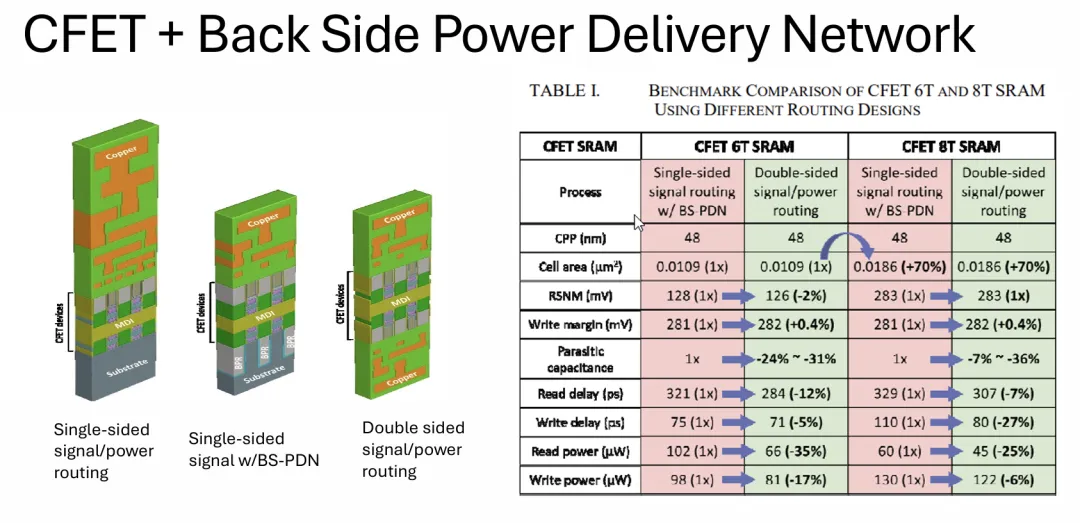
图30:使用不同路由策略的CFET 6管和8管SRAM实现比较显示了三种架构方法:单侧信号和功率路由(左)、单侧信号与背面功率传输网络(中心),以及双侧信号和功率路由(右)。表格比较了关键指标,显示虽然各方法的单元面积保持相似,但双侧路由提供了优越的电学特性,包括更好的噪声裕度、更低的电容、更快的访问时间,以及读取和写入操作的显著降低的功耗。
14
结语
半导体行业继续推进物理和经济上可行的边界。从早期的平面CMOS到FinFET和全栅极环绕结构,再到新兴的CFET架构,每一代都通过创新的器件结构、材料和集成方案提供了显著的改进。背面功率传输网络和先进的接触技术使得即使在传统尺寸缩小变得越来越困难时也能继续缩放。这些创新的结合确保了人工智能和其他苛刻应用所需的计算能力将继续增长,尽管可能以比前几十年更为平稳的步伐。挑战确实存在,但数十年来半导体进展所展示的智慧为应对未来的复杂问题提供了信心。
参考文献
[1] Y. Luo, "Advances in CMOS Scaling and Future Challenges," presented at the IEEE Int. Electron Devices Meeting (IEDM), San Francisco, CA, USA, Dec. 2025.
END
 微信公众号
 bilibili
 微信视频号