


引言
人工智能系统的快速演进对数据中心基础设施提出了巨大需求。随着AI模型在规模和复杂性上持续增长,实现处理单元之间通信的互连技术已经成为关键瓶颈。Alchip Technologies与Ayar Labs之间的合作,通过将光电共封装与先进半导体封装技术相结合,在应对这些挑战方面迈出了重要一步[1]。

01
AI系统连接性面临的增长挑战
现代AI系统面临一个根本性问题,严重影响性能表现。大约70%的AI计算时间花费在等待数据上,而非执行实际运算。这种低效源于当前连接解决方案的局限性,难以跟上AI加速器的计算能力。当AI模型从数百个处理单元协同工作扩展到数千个处理单元时,数据传输瓶颈变得愈发严重。
基础设施需求随着系统规模的扩大而发生显著变化,从跨越约三米的机架级部署,到延伸十五米的多机架配置,最终到达可延伸一百米或更远的集群规模实施。每个扩展阶段都会引入额外的延迟和带宽挑战,加剧现有的连接性问题。从一百个处理单元作为统一系统运行,过渡到一千个单元必须协同操作的架构,需要在互连设计上采用根本不同的方法。
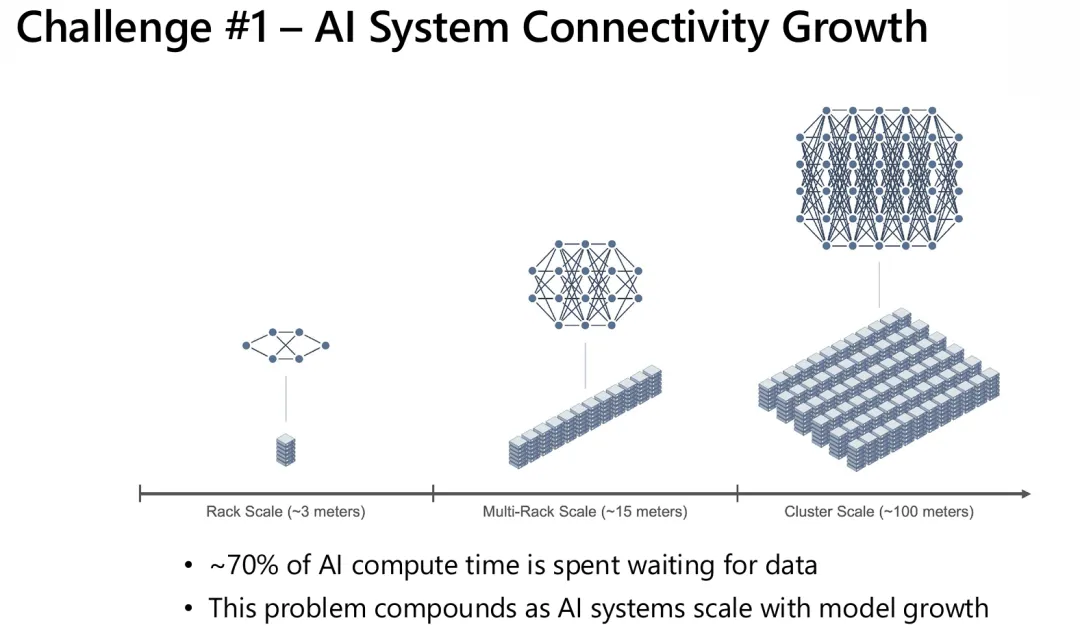
图1:AI系统连接性增长在不同规模下的演进,展示了网络复杂性如何从机架规模增长到集群规模的实施过程。
02
电气系统中的功率密度限制
除了连接瓶颈外,功耗呈现了扩展AI基础设施的另一个巨大障碍。每个机架的功率需求在近年来呈指数级增长。来自业界的数据显示,每机架功率从2023年的32千瓦增加到2024年的144千瓦,在2025年保持该水平,然后在2026年跃升至176千瓦,到2027年达到576千瓦。这些预测假设继续依赖传统的电气输入输出技术。
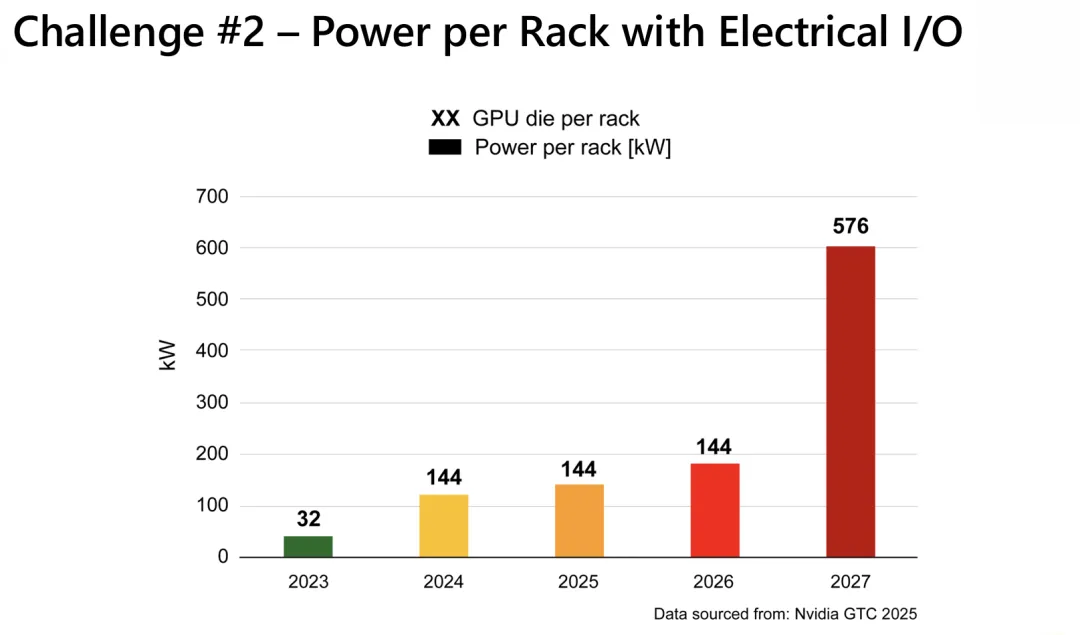
图2:以千瓦为单位测量的每机架功率的急剧上升,显示了基于电气I/O系统的不可持续发展轨迹。
几十年来服务行业良好的电气信号技术正在接近基本物理极限。通过铜互连的高速电气信号需要大量功率用于信号调理、均衡和在距离上维持信号完整性。随着数据速率提高,每传输一比特所需的能量大幅增长,造成互连消耗的功率可与实际计算所用功率相媲美甚至超过的情况。
03
光学扩展网络的必要性
向光互连技术的过渡提供了同时克服带宽和功耗挑战的路径。光学解决方案提供了电气系统无法匹敌的几个关键优势。通过光交换实现的更大路径多样性可以显著降低延迟。光连接的距离远超铜缆在保持信号质量方面的能力。能效大幅提升,每传输一比特的能耗大幅降低。此外,光交换机可以支持更高的端口数量,实现大规模AI训练集群所需的高基数配置。
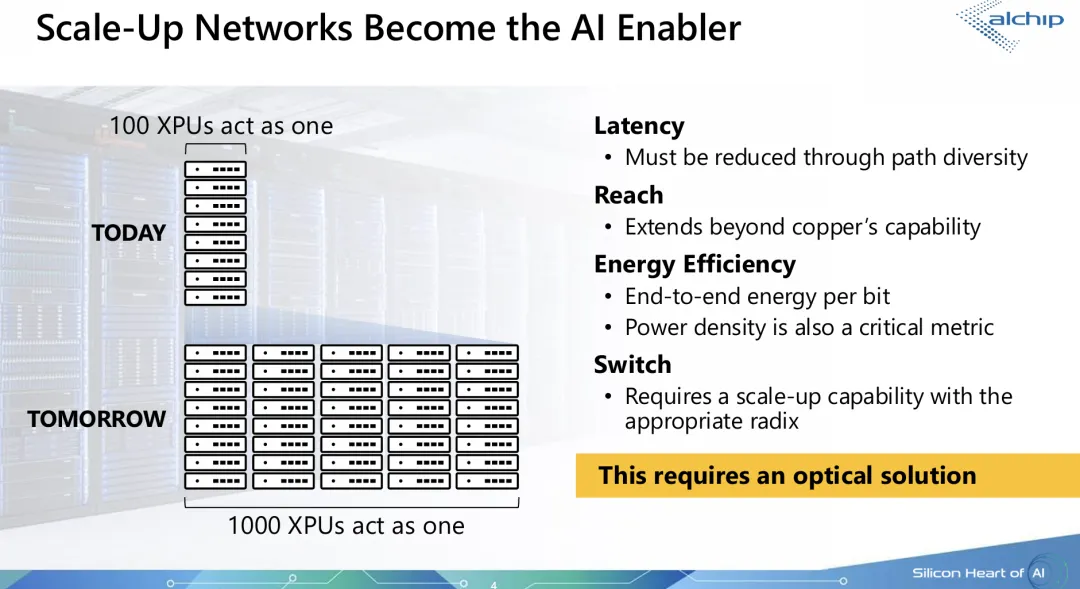
图3:对比当前一百个处理单元作为统一实体运行的系统,与未来需要一千个单元协同运作的架构,强调了光学解决方案的需求。
下一代AI基础设施的要求清晰而严苛。系统必须最小化延迟,确保处理单元将时间用于计算而非等待。必须将距离延伸到铜互连的限制之外,实现机架到机架和集群到集群的通信。随着系统规模增加,能效变得极为重要,使得光链路的低功耗特性必不可少。此外,交换机必须提供连接数百或数千个处理单元所需的基数,并保持最小的跳数。
04
集成技术平台架构
Alchip与Ayar Labs开发的协作解决方案将多种先进技术集成到一个为高性能计算和AI工作负载优化的统一平台中。该架构结合了几个关键要素,协同工作以提供卓越的性能和效率。
高性能存储器构成基础,提供向AI加速器供给训练数据和模型参数所需的带宽。3D堆叠和片上系统集成技术实现了多个chiplet的密集封装,包括主要AI计算芯片、存储器控制器和接口芯片。光电共封装代表了平台最具创新性的方面,将光收发器直接置于封装基板上,与处理芯片并置。这种集成包括硅基光电子组件,以最小延迟和功率开销将电信号转换为光信号,再转换回来。
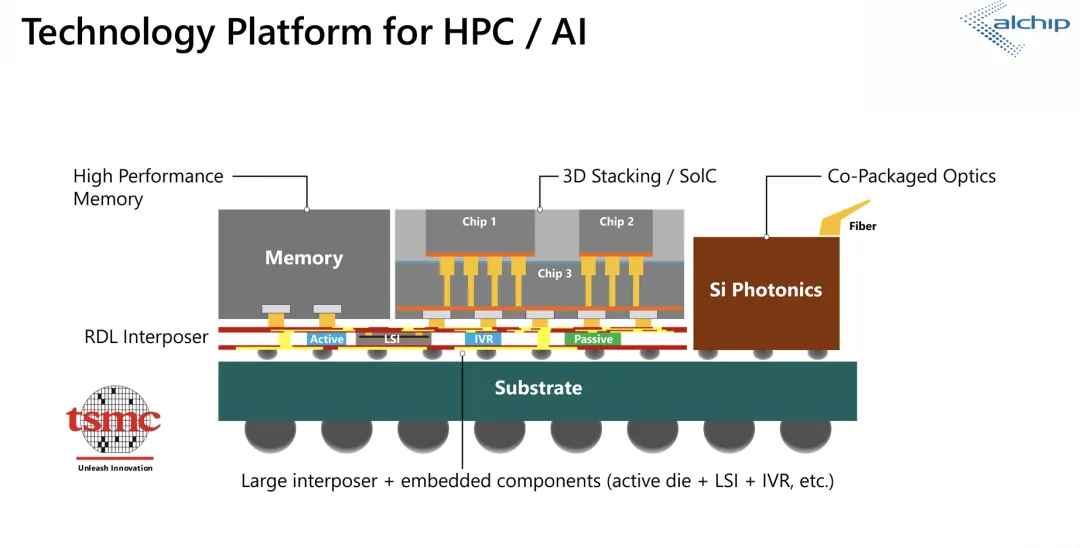
图4:完整的技术堆栈,展示存储器、3D堆叠、硅基光电子和基板集成如何结合创建综合平台。
基板本身不仅仅作为安装平台。带有嵌入式组件的大型interposer提供电气布线和无源器件集成。有源芯片组件、负载侧电感器和集成稳压器直接嵌入封装中,改善电源传输和信号完整性。这种集成水平由台积电等代工合作伙伴的先进封装技术支持,创建了一个优化的环境,所有组件高效协同工作。
05
AI加速器设计
通过Alchip与Ayar Labs合作展示的参考设计演示了这些技术如何在实践中结合。配置包括两个全reticle AI加速器芯片,代表了在单次光刻步骤中可以制造的最大硅面积。四个协议转换器chiplet处理不同互连标准之间的转换,管理计算芯片与光引擎之间的接口。八个Ayar Labs TeraPHY光引擎提供光连接,每个引擎支持多个高速光通道。八个高带宽存储器堆栈提供现代AI工作负载所需的巨大存储器带宽,整个封装中的集成无源器件确保稳定的电源传输和最佳信号完整性。
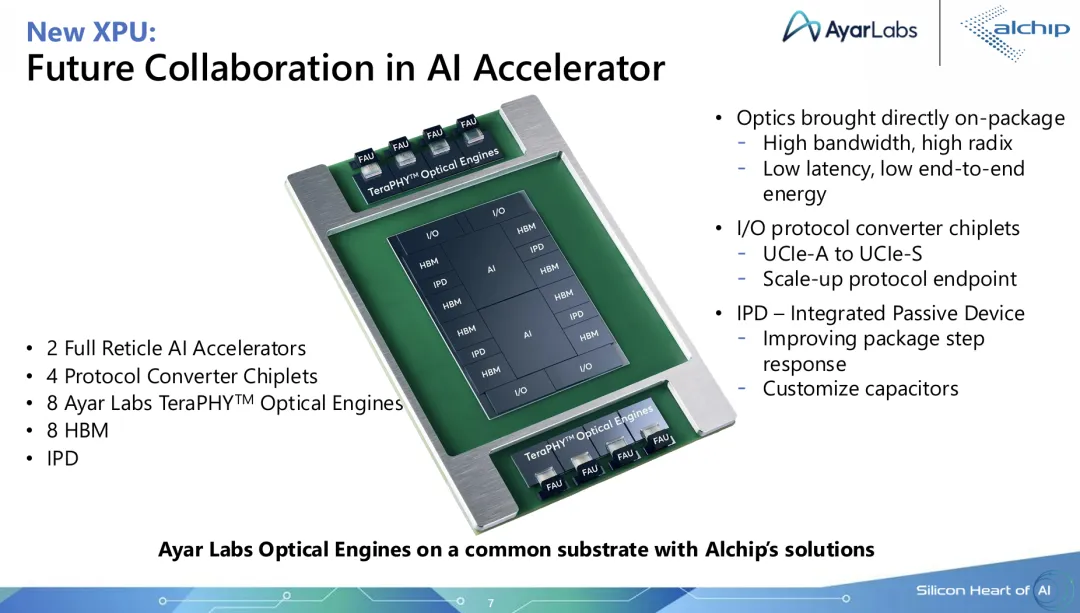
图5:XPU配置的详细布局图,说明AI加速器、协议转换器、光引擎和HBM存储器如何在共同基板上排列。
光引擎使用可拆卸的光纤阵列单元,通过标准化光连接器连接到封装,简化制造、assembly和测试流程。这种模块化方法允许在最终系统集成之前独立测试光组件,提高良率并降低成本。
06
协议转换器Chiplet
实现光互连与AI加速器集成的关键要素是协议转换器chiplet。这些专用芯片在系统内的不同通信域之间执行多种功能。在片上系统侧,实现支持缓存一致性协议(如CHI)的UCIe-A接口,允许转换器参与处理器的存储器层次结构。在光引擎侧,实现针对与光收发器之间高吞吐量、单向数据流优化的UCIe-S流式接口。
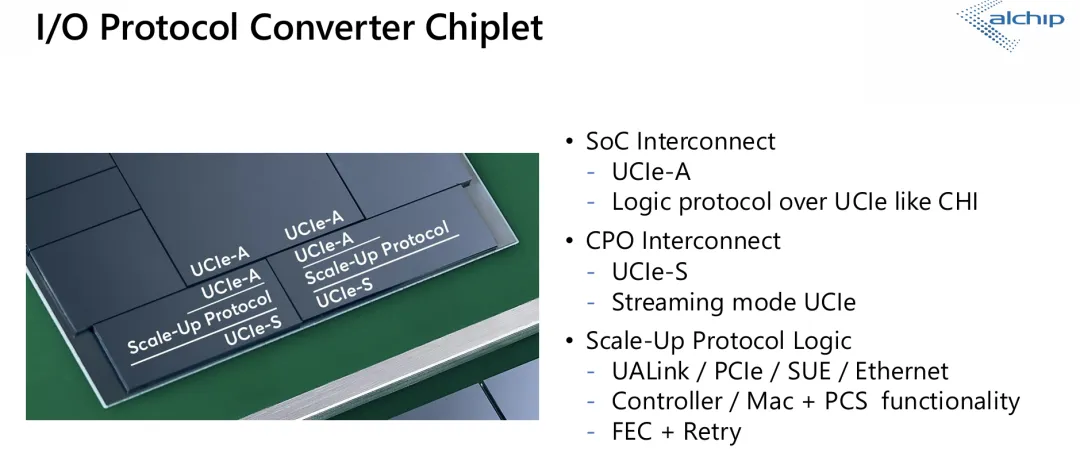
图6:协议转换器chiplet架构,展示实现SoC协议与光流式接口之间转换的接口和功能模块。
转换器chiplet还实现实际的扩展网络协议,可能包括用于AI特定互连的UALink、用于与现有基础设施兼容的PCIe、专有解决方案或用于最大互操作性的以太网。chiplet包含完整的控制器和介质访问控制功能以及物理编码子层逻辑。前向纠错和重试机制确保即使在具有不同特性的长光链路上也能实现可靠通信。
07
TeraPHY光引擎架构
Ayar Labs TeraPHY光引擎代表了光连接解决方案的核心。这些紧凑模块提供令人印象深刻的规格,实现跨整个数据中心的多机架扩展连接。每个加速器封装可通过光链路支持超过一百太比特每秒的聚合带宽,提供超过256个独立的扩展端口。光引擎采用的微环谐振器架构已被证明可用于大批量制造,解决了对硅基光电子技术生产成熟度的担忧。
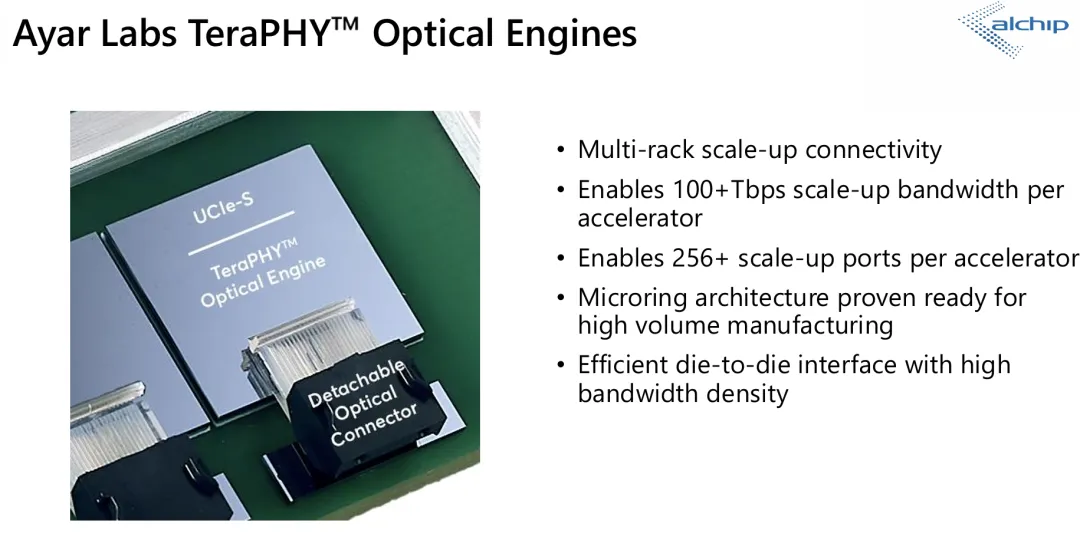
图7:带有UCIe-S接口和可拆卸光连接器的TeraPHY光引擎,突出显示光互连技术的物理实现。
芯片到芯片接口提供出色的带宽密度,实现与协议转换器chiplet的紧密集成。光引擎的堆叠架构将先进半导体节点上的电子集成线路与针对光信号产生和检测优化的光电子集成芯片相结合。这种堆叠方法提供了几个优势,包括能够在针对各自功能优化的不同工艺节点上制造电气和光电子组件。电气芯片可以定制客户特定的协议功能,而无需更改光电子层,电气接口提供灵活性,根据系统要求支持芯片到芯片或标准封装连接。
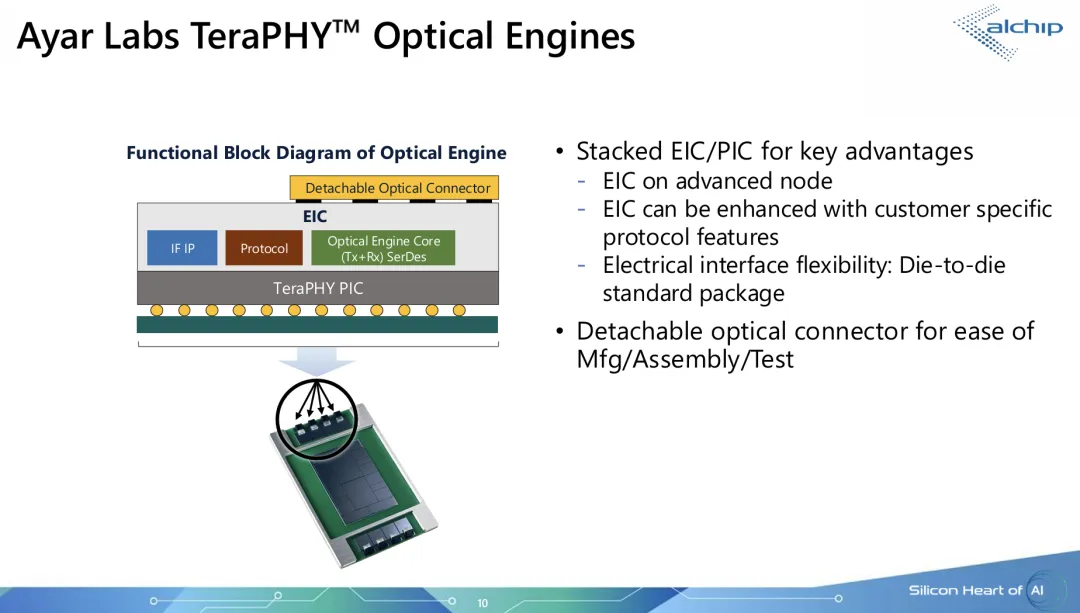
图8:光引擎的功能框图,展示包含接口IP、协议逻辑和SerDes组件的电子集成线路如何堆叠在TeraPHY光电子集成芯片之上,可拆卸光连接器提供光纤接口。
可拆卸光连接器设计显著简化了制造、assembly和测试工作流程。光引擎可以在光纤连接前在封装级别进行全面测试,光纤连接可以在现场进行和重新进行,用于维护或重新配置,无需专用设备或洁净室环境。
08
光学技术选项
TeraPHY架构支持两种光调制方法,每种都针对不同的部署场景进行了优化。四电平脉冲幅度调制结合粗波分复用代表初始生产解决方案。此配置实现一百到两百纳秒加飞行时间的单跳延迟,包括前向纠错和重定时器逻辑的开销。原始误码率保持在每传输一百万比特低于一个错误,为能够容忍偶尔可纠正错误的AI工作负载提供足够的可靠性。
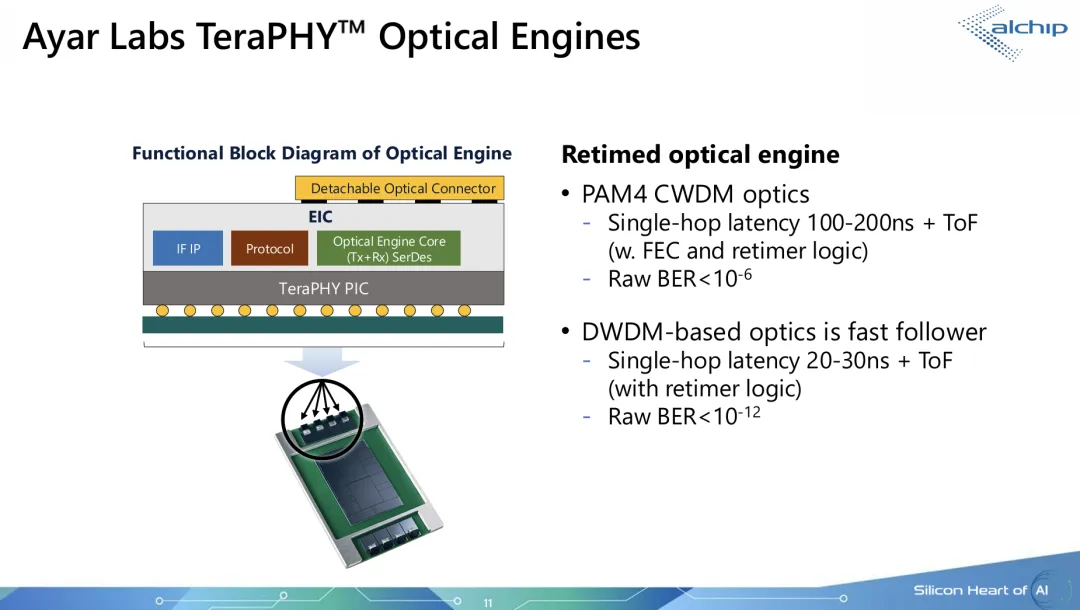
图9:重定时光引擎规格,详细说明PAM4 CWDM和DWDM光学方法的延迟和误码率特性。
密集波分复用技术作为快速跟进解决方案,提供增强的性能特性。DWDM系统可以实现仅二十到三十纳秒加飞行时间的单跳延迟(包括重定时器逻辑),相比初始CWDM实现有显著改进。DWDM系统的原始误码率超过每传输一万亿比特一个错误,在正常操作条件下基本消除了不可纠正的错误。这种改进的错误性能可能允许系统设计者减少或消除前向纠错开销,进一步降低延迟和功耗。
09
可扩展和可组合的基础设施
将光电共封装与先进封装集成的最终目标是实现灵活、可扩展的AI基础设施,能够适应不断演变的工作负载需求。该架构支持多种优化系统性能不同方面的互连拓扑。直接处理单元到处理单元的连接为紧密耦合的工作负载最小化延迟,而通过扩展交换机的连接实现具有高效全对全通信模式的更大拓扑。交换机到交换机的连接允许构建可扩展到数千个处理单元的多层网络。
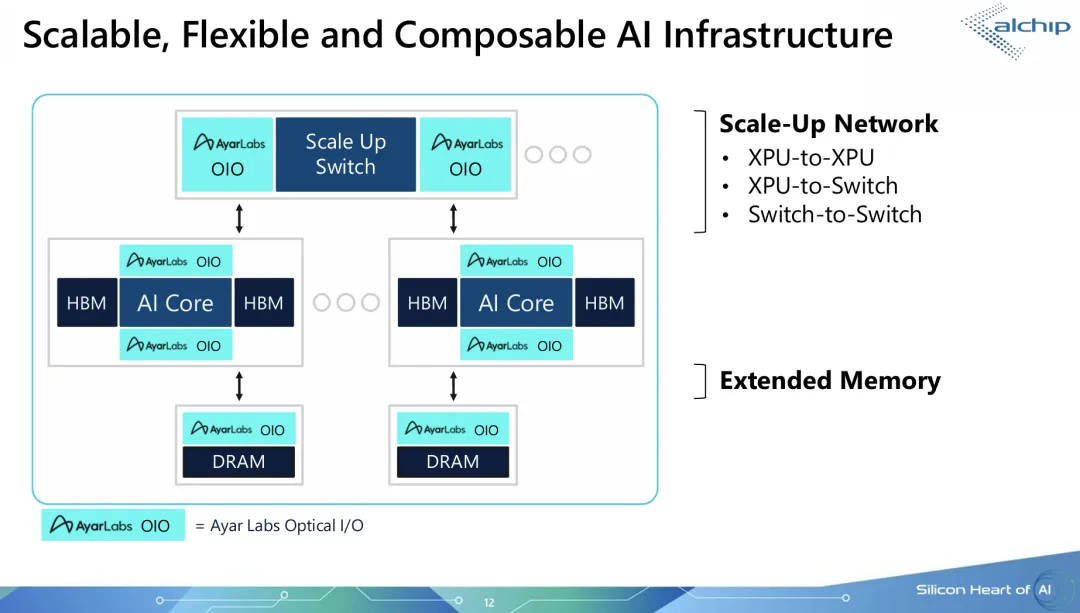
图10:利用Ayar Labs光I/O在AI核心、扩展交换机和扩展存储器资源之间连接的可扩展AI基础设施,展示光互连方法的灵活性。
架构的可组合性质不仅扩展到计算资源,还包括存储器。光连接的扩展存储器池可以在多个处理单元之间共享,有效增加单个加速器可用的存储器容量,而无需将额外的高带宽存储器直接连接到每个封装的成本和功率开销。这种存储器池化方法实现更高效的资源利用,支持在执行的不同阶段具有不同存储器强度的工作负载。
10
对AI应用性能的影响
光扩展网络的优势超越了原始硬件规格,在实际AI应用性能上提供了有意义的改进。对大型语言模型推理工作负载的分析展示了光学方法的显著优势。对于具有特定序列长度和输出token要求的GPT风格模型,使用传统电气输入输出的系统实现了有限的盈利能力和交互性指标。当相同的加速器数量转换到光扩展互连时,盈利能力和用户体验都显著改善。向光扩展配置添加光连接的扩展存储器提供了更大的收益,在保持可接受响应延迟的同时实现显著更高的请求速率。
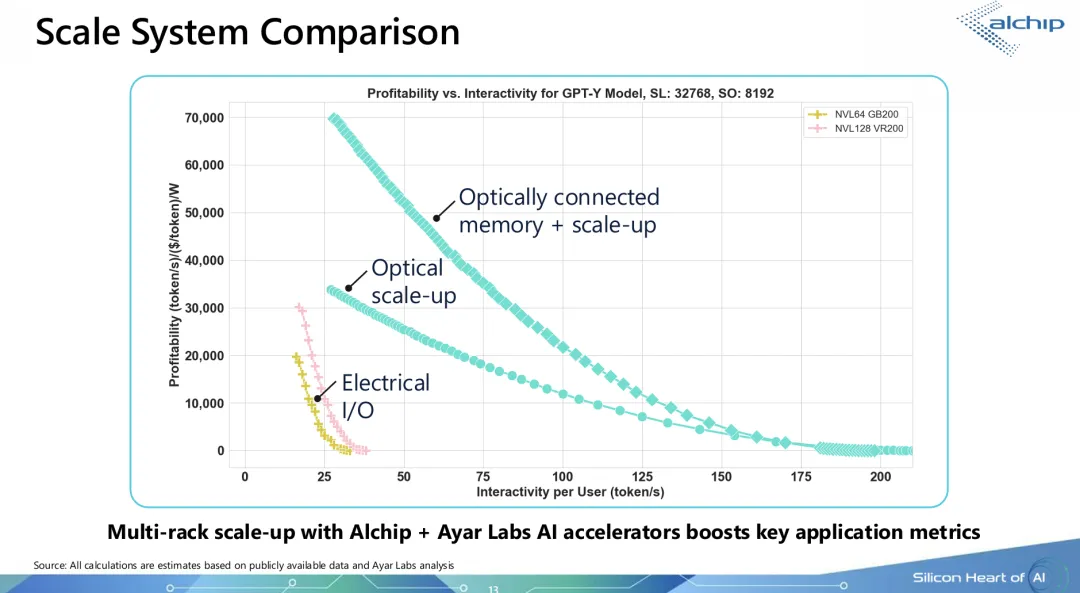
图11:GPT-Y模型的盈利能力与交互性分析,比较电气I/O系统与光扩展以及光连接存储器加扩展配置,展示光学方法的显著性能优势。
这些性能改进直接转化为对AI服务提供商重要的业务指标。每生成token的更高盈利能力意味着基础设施投资的更好回报。以每秒向用户交付的token衡量的增加的交互性改善了用户体验,并使用相同的硬件资源服务更多并发请求。这些因素的结合可以从根本上改变部署大规模AI服务的经济性。
11
合作与前进方向
Alchip Technologies与Ayar Labs之间的合作伙伴关系汇集了实现先进AI基础设施必不可少的互补专业知识。Alchip贡献了在专用集成线路设计服务、先进封装技术和大批量制造合作伙伴关系方面的深厚经验。Ayar Labs提供经过验证的硅基光电子技术、针对共封装优化的光引擎设计,以及将光互连集成到复杂多芯片系统所需的系统级专业知识。
这种合作产生了完整、经过验证的解决方案,而不仅仅是概念或研究演示。在行业活动中展示的原型系统代表了验证技术方法并展示制造可行性的工作实施。该解决方案实现了具有低延迟特性和节能运行的超高带宽连接,适合超大规模运营商和专注于AI的公司部署的大规模AI集群。
随着AI模型规模继续快速增长轨迹,通过这种合作伙伴关系提供的可扩展能力、技术和服务变得越来越关键。从数百个处理单元扩展到数千个处理单元作为协同系统运行的能力直接取决于能够跟上计算能力增长的互连技术。传统电气方法已达到实际极限,而光学解决方案为AI基础设施演进的下一个十年提供了清晰的路径。
从概念到生产就绪技术的过程涉及克服跨越多个学科的众多技术挑战,包括半导体设计、光电子技术、先进封装、系统架构和制造。Alchip与Ayar Labs之间的成功合作表明,通过专注的工程努力和具有互补能力的公司之间的密切合作伙伴关系,可以解决这些挑战。结果是一个技术平台,准备好支持将在未来几年改变行业和社会的下一代AI应用。
参考文献
[1] E. Shaizaf and V. Stojanovic, "Enabling Next-Gen AI Infrastructure with Co-Packaged Optics and Advanced Packaging," presented at the Optical Fiber Communication Conference (OFC), San Diego, CA, USA, 2025.
END
 微信公众号
 bilibili
 微信视频号