


引言
人工智能工作负载的发展从根本上改变了数据中心网络需求。传统网络接口卡专为常规计算任务设计,对于现代AI训练和推理操作的大规模和严格性能要求显得力不从心。NVIDIA的ConnectX-8 SuperNIC在这一领域提供了集成解决方案,专门应对AI网络在大规模部署中面临的独特挑战[1]。

理解AI网络需求
现代AI应用与传统数据中心工作负载相比呈现出截然不同的网络挑战。AI训练工作负载涉及同步的长期任务,跨越多个GPU,规模可达园区甚至跨园区级别。这些操作的特点是与外部世界的接口需求极少,但对尾延迟极为敏感,即使很小的延迟也会显着影响整体训练效率。相反,AI推理工作负载具有分散的分区操作特征,具有高延迟敏感性和与外部系统的大量接口,包括键值缓存和智能代理工作流。
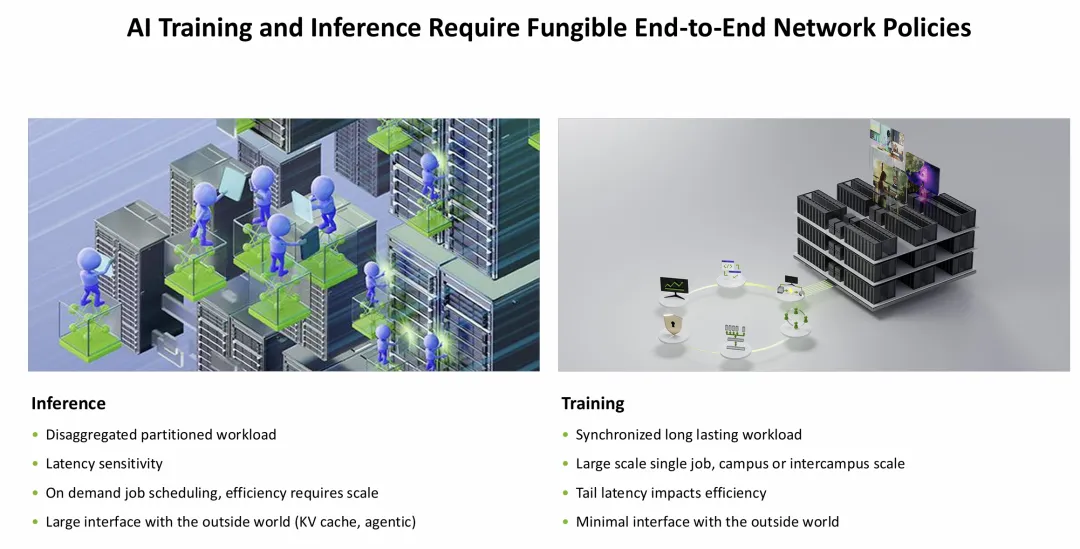
图1:此架构对比图展示了AI训练和推理工作负载的根本差异,突出了各自独特的网络需求和操作特征。
这些操作的规模需要NVIDIA所称的"可互换端到端网络策略"——能够动态适应不同工作负载需求同时保持一致性能特征的网络解决方案。传统的网络方法将每个组件视为独立实体,无法充分解决这些复杂的相互依赖关系。
SuperNIC架构设计
ConnectX-8 SuperNIC超越了传统网络接口卡的限制,将多个复杂子系统集成为一个统一的网络解决方案。与主要处理数据包传输和接收的传统NIC不同,SuperNIC集成了先进功能,包括在数百万GPU上部署RDMA技术、专为AI带宽和延迟需求设计的800吉比特RDMA硬件流水线,以及集成的负载均衡与拥塞控制和可靠性机制。
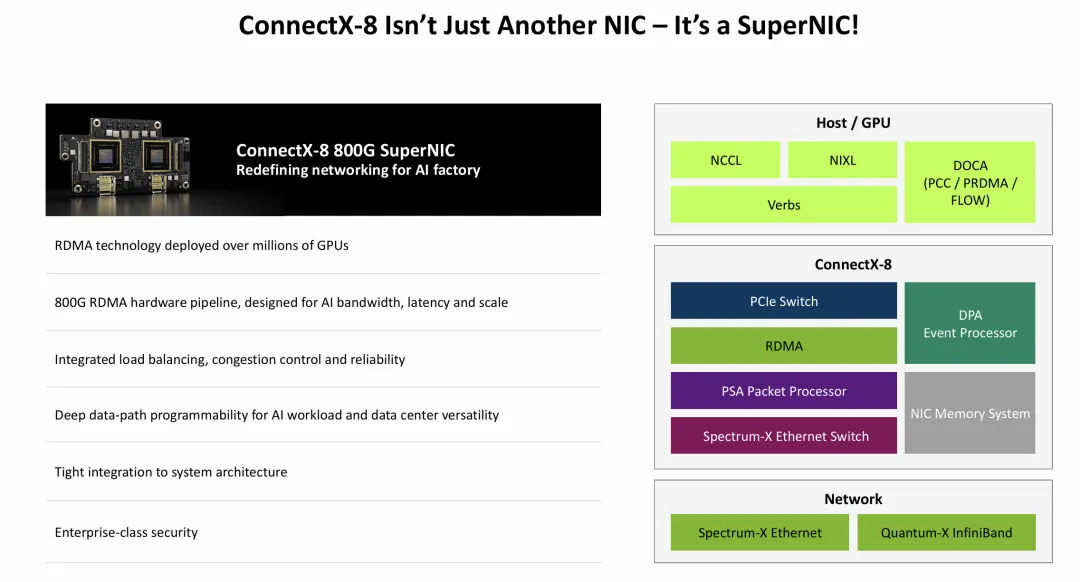
图2:架构图显示了ConnectX-8 SuperNIC的集成组件,包括RDMA引擎、PSA数据包处理器、Spectrum-X以太网交换机、DPA事件处理器和NIC内存系统。
该器件具有深度数据路径可编程性,能够针对特定AI工作负载和数据中心配置进行定制。这种可编程性扩展到与系统架构的紧密集成,确保网络、计算和存储子系统之间的最佳性能协调。企业级安全功能嵌入整个设计中,为敏感的AI工作负载提供全面保护。
ConnectX-8支持双网络协议,提供每秒800吉比特的InfiniBand XDR或双400吉比特以太网连接。集成的Spectrum-X以太网功能扩展到八个端口,而主机接口通过集成PCIe交换机使用48通道PCIe第六代连接。RDMA实现提供线速传输和乱序传递功能,并配备可编程拥塞控制和重传机制。
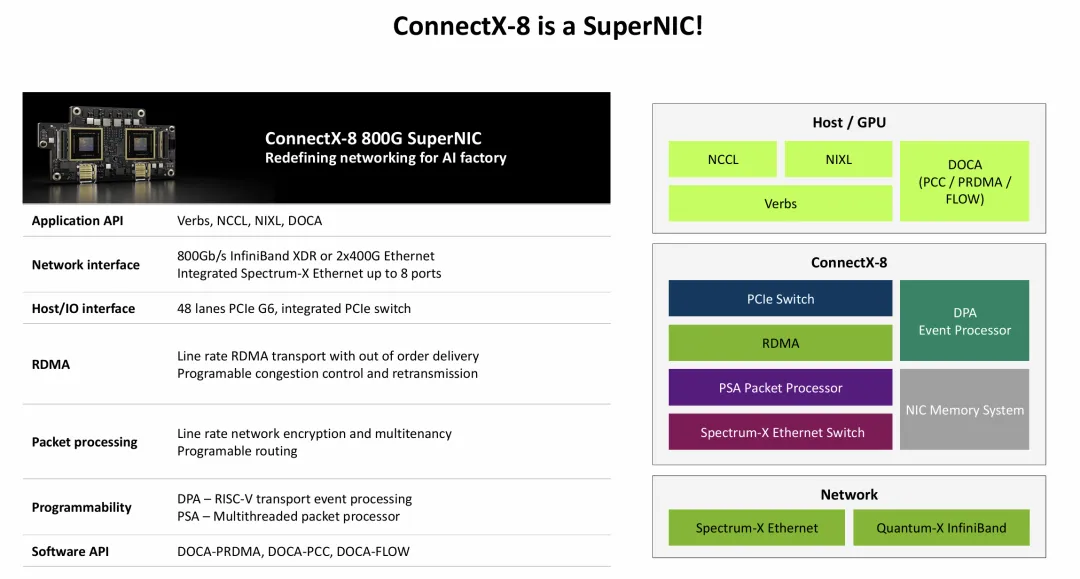
图3:ConnectX-8的全面功能集,包括应用程序编程接口、网络接口、主机连接和可编程选项。
高级扩展和性能特征
ConnectX-8在各种消息大小和队列对配置中展现出卓越的扩展特性。性能测试显示,从单个队列对到数千个并发连接的各种场景下,都能保持一致的800吉比特吞吐量。这种扩展能力对于大规模AI训练操作特别重要,在这些操作中,在众多并行连接间保持一致性能直接影响整体系统效率。
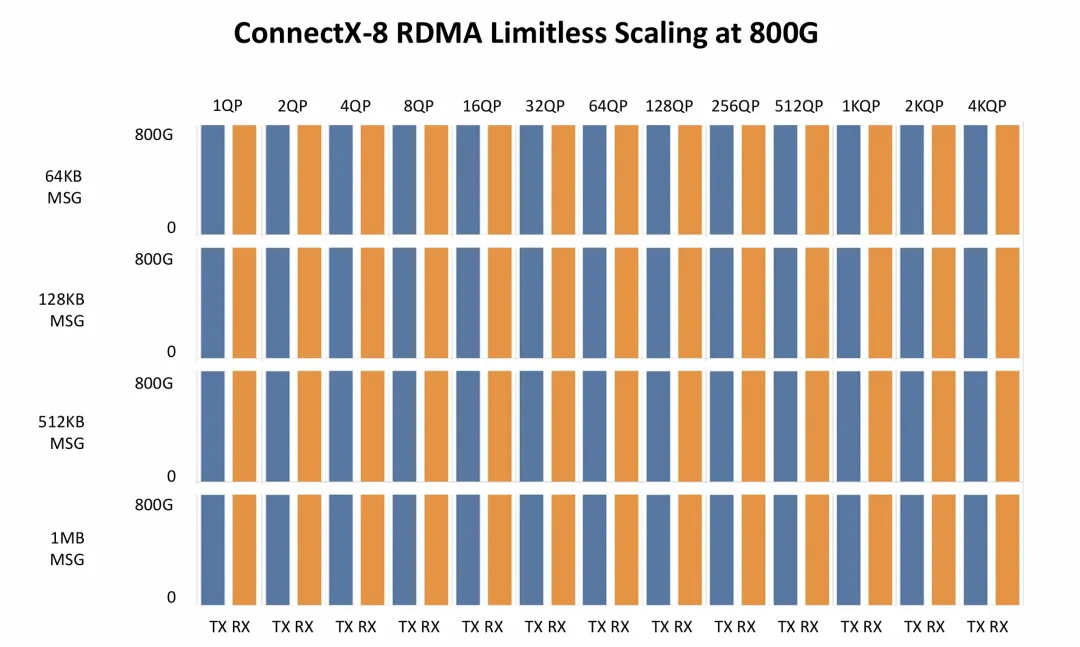
图4:ConnectX-8在各种消息大小(64KB到1MB)和队列对数量(1QP到4KQP)下保持完整800G吞吐量的能力,显示了发送和接收性能的一致性。
数据中心架构演进需要从传统的基于组件的思维转向集成系统设计。历史上的数据中心方法将CPU、PCIe交换机、NIC、SSD、GPU和网络交换机等各个组件视为具有预定义功能的离散实体。这种分割在AI工作负载规模下会产生效率低下和瓶颈问题。
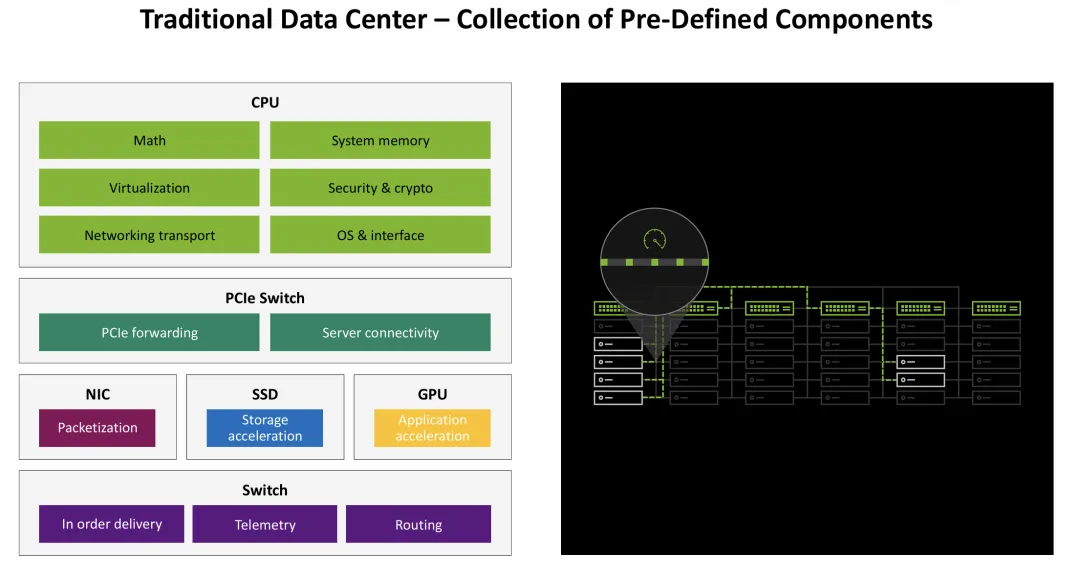
图5:传统数据中心方法,具有分离的组件,包括CPU、PCIe交换机、NIC、SSD、GPU和交换机元素,每个都处理特定的独立功能。
集成系统级创新
ConnectX-8代表了将数据中心视为计算单元这一根本转变,其中SuperNIC作为连接GPU与外部世界的关键ASIC发挥作用。这种集成在GB300等平台中变得必要,ConnectX-8在其中与Grace Blackwell NVLink72架构、NCCL通信库、DOCA可编程框架和Spectrum-X交换基础设施协调工作。
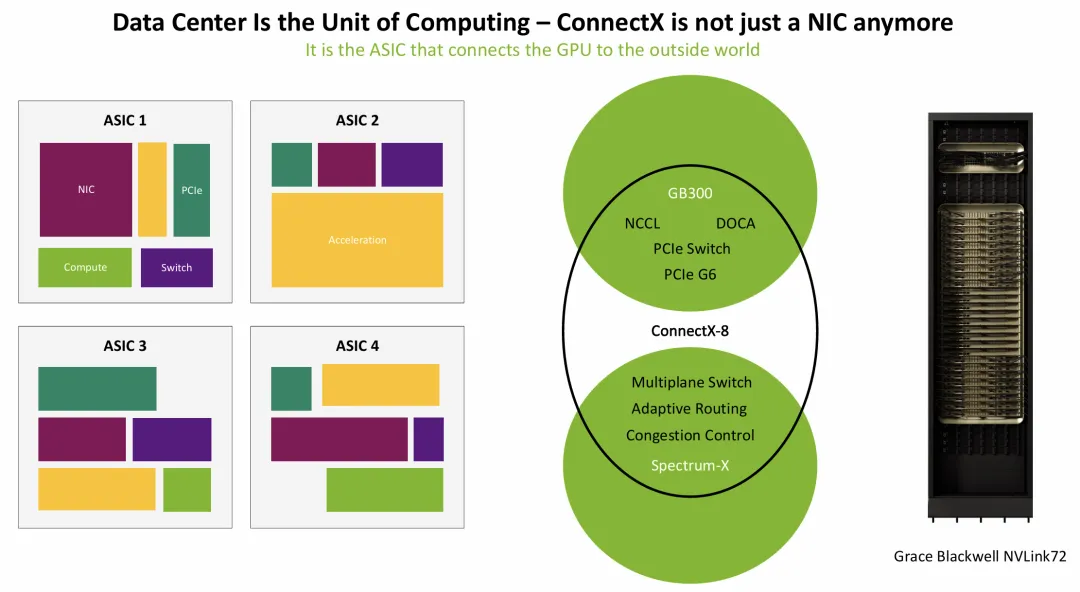
图6:ConnectX-8如何作为连接GPU资源与外部网络的关键ASIC,代表了数据中心设计从基于组件向系统级思维的演进。
ConnectX-8中的PCIe第六代实现标志着这一先进标准与800吉比特AI网络首次联合部署。这种集成在Blackwell Ultra配置中为NVLink芯片到芯片通信节省了大量带宽,同时在网络、GPU、CPU和SSD子系统之间提供服务质量协调。
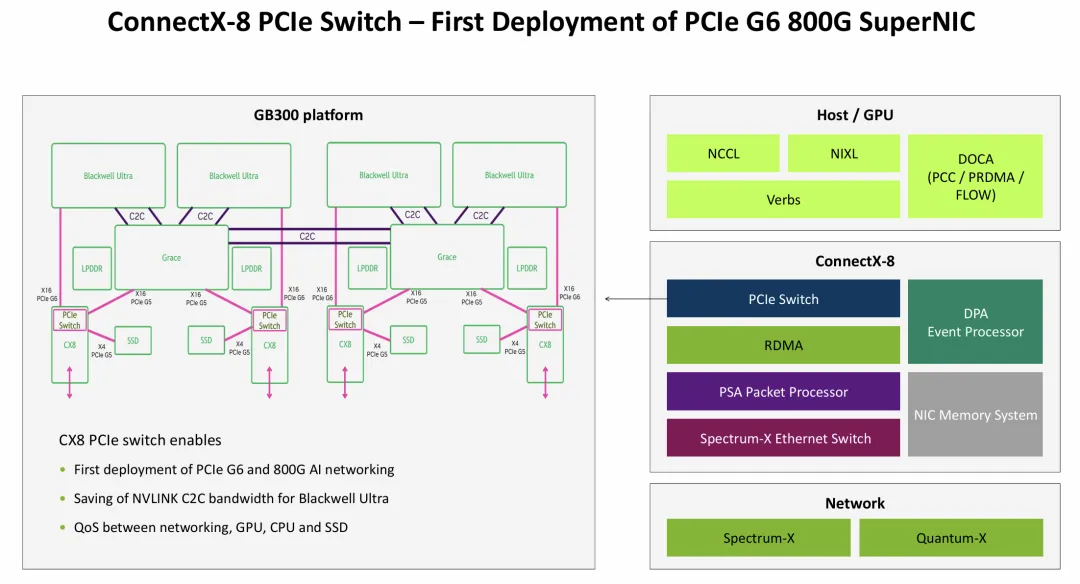
图7:ConnectX-8在GB300平台中的集成,突出了PCIe G6连接、Blackwell Ultra GPU连接以及各系统组件之间的协调。
Spectrum-X以太网集成和可扩展性
ConnectX-8中集成的Spectrum-X以太网功能解决了AI网络中的关键可扩展性挑战。传统NIC连接方法在两级无阻塞胖树配置中将GPU扩展限制在约2000个单元。ConnectX-8的集成Spectrum-X以太网交换功能通过多平面交换架构实现扩展到128000个GPU。
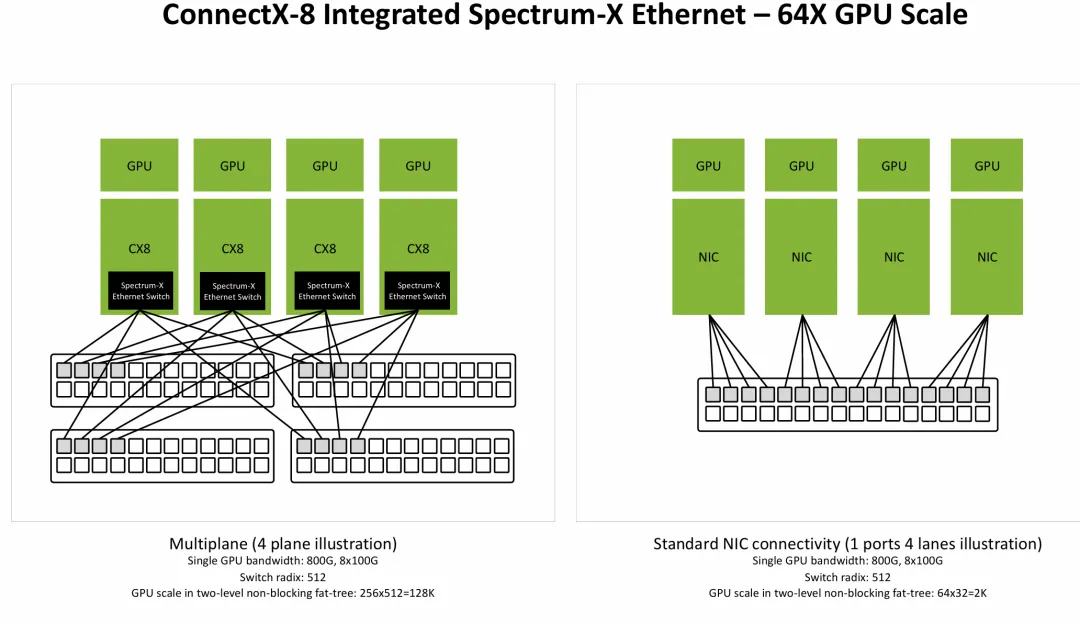
图8:扩展对比展示了ConnectX-8的集成Spectrum-X以太网交换机如何实现比传统NIC连接方法多64倍的GPU扩展(从2K到128K GPU)。
这种显着的扩展改进源于SuperNIC作为Spectrum-X以太网交换基础设施扩展的能力。集成提供自动负载均衡和拥塞控制,同时从应用层抽象复杂的交换功能。这种抽象简化了软件开发,同时确保大规模部署中的最佳网络利用率。
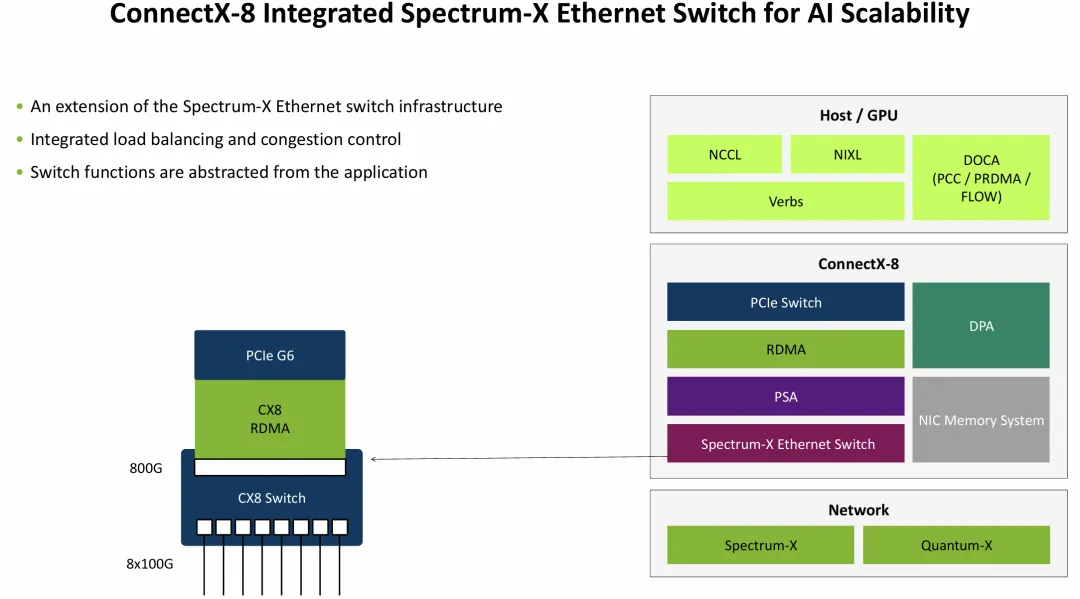
图9:ConnectX-8的集成Spectrum-X以太网交换机作为更广泛交换基础设施的扩展发挥作用,提供无缝800G连接和自动化网络管理。
高级数据包处理和网络控制
ConnectX-8通过PSA(编程协议无关交换架构)数据包处理器和RDMA引擎集成结合了复杂的数据包处理能力。RDMA实现为AI网络提供多层创新,有效地将传统操作系统服务扩展以满足AI工作负载需求。这包括通过完整RDMA动词的全面应用接口支持、直接GPU和CPU内存访问功能、应用级服务质量管理,以及包括拥塞控制、可靠性机制和乱序数据包传递在内的高级传输层功能。
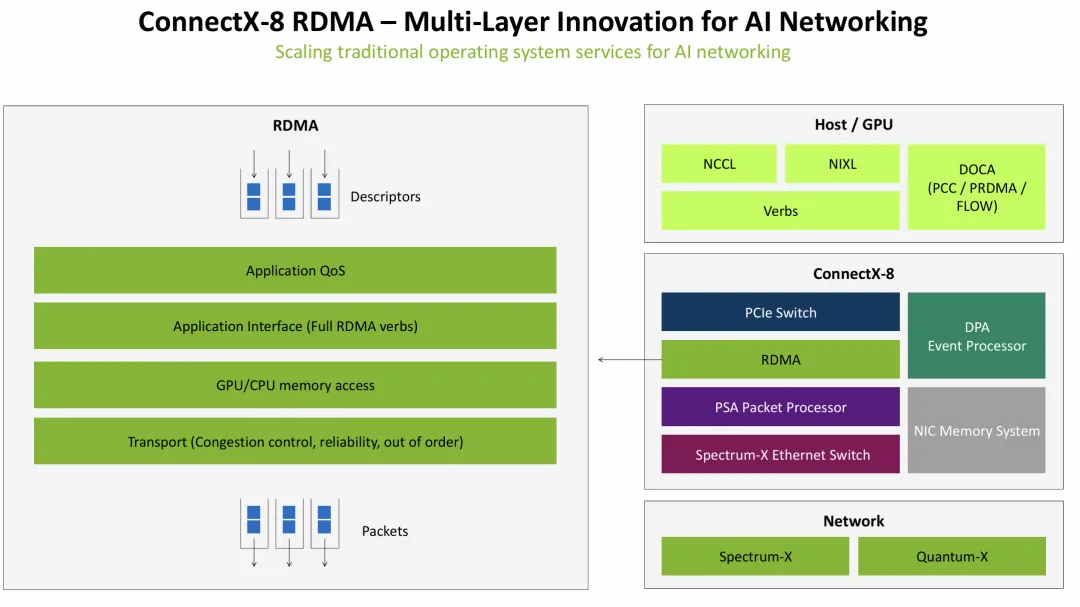
图10:RDMA架构图显示了多层创新方法,包括应用接口、内存访问、服务质量和传输层功能,这些功能将传统操作系统服务扩展以满足AI网络需求。
PSA数据包处理器处理AI工厂操作的关键安全和路由功能。这包括线速网络加密和多租户支持、可编程路由功能以及全面的Spectrum-X遥测集成。多线程数据包处理器架构确保在不同工作负载类型间保持一致性能,同时维护不同应用和用户之间的安全隔离。
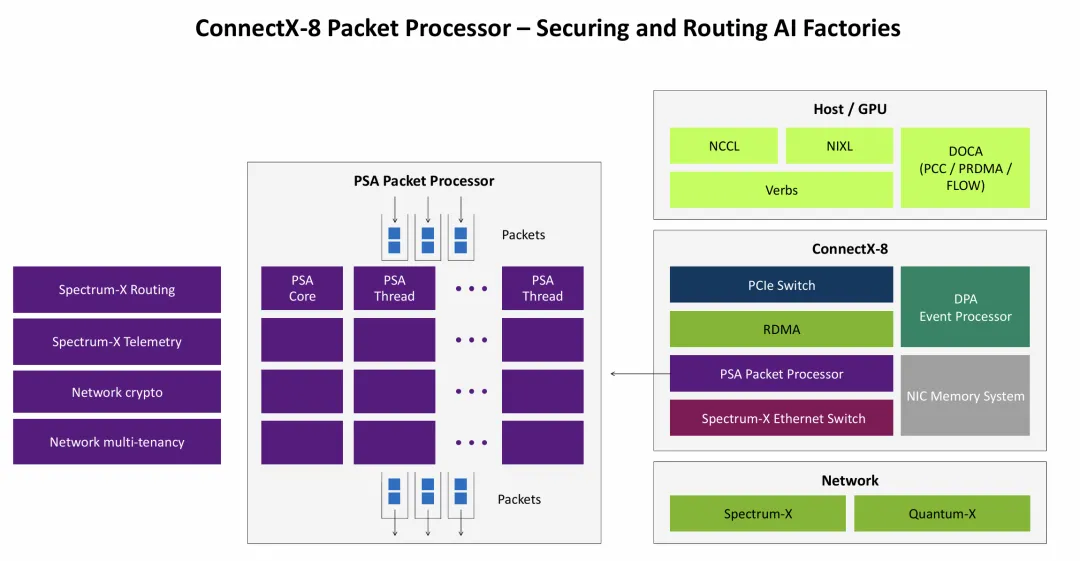
图11:PSA数据包处理器图详述了负责AI工厂操作所需的网络加密、多租户、遥测和路由功能的多线程架构。
数据路径加速和智能控制
ConnectX-8的数据路径加速器(DPA)代表了网络智能的重大进展,具有16核16线程RISC-V事件处理器,专门设计用于运行维护网络效率的算法。该处理器处理实时网络优化任务,包括拥塞检测和响应、自适应路由决策以及故障恢复机制。
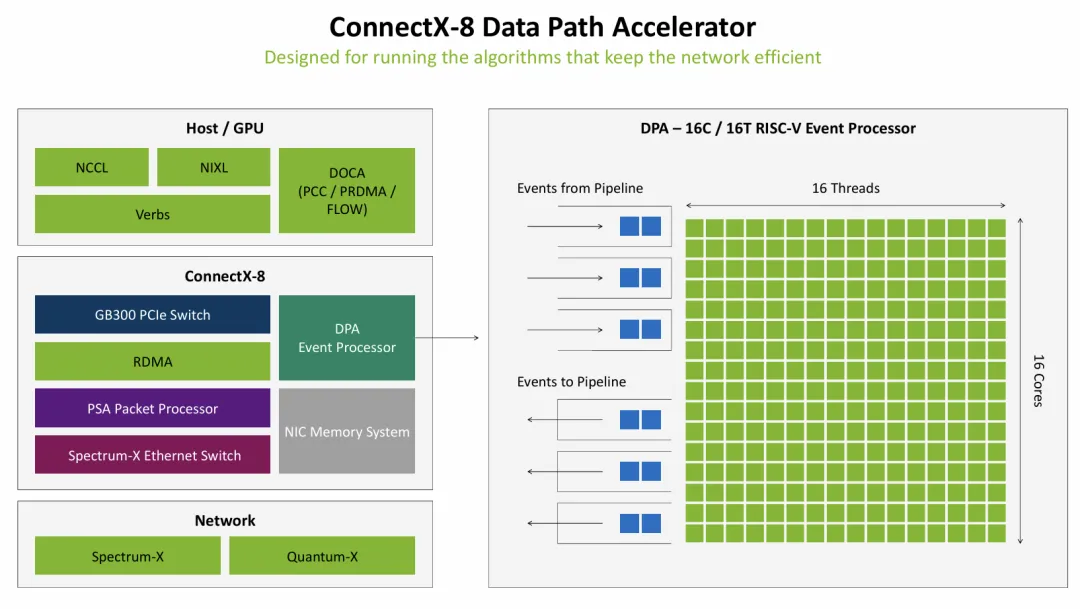
图12:DPA架构显示了为实时网络优化设计的16核16线程RISC-V事件处理器,具有来自和到硬件流水线的专用事件路径。
DPA与RDMA传输控制和PSA路由系统协同工作,提供全面的网络智能。RDMA系统生成与传输控制相关的事件并接收动作,而PSA系统处理路由相关的事件和动作。这种协调方法通过考虑拥塞状态、路由状态和整体网络条件的数学算法确保最佳网络性能。
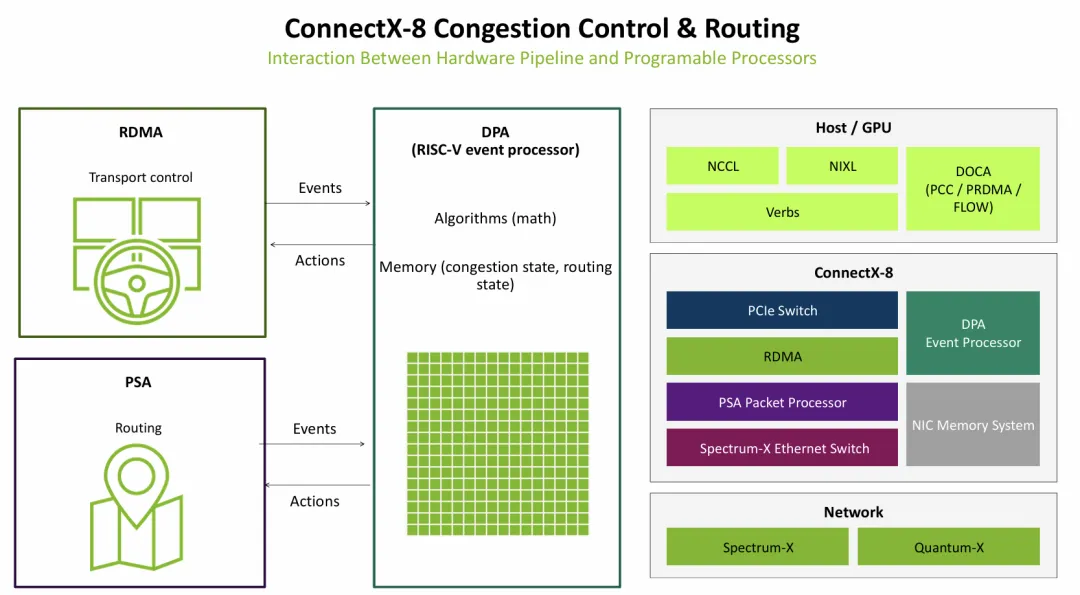
图13:RDMA传输控制、PSA路由和DPA处理器之间的复杂交互,显示了事件和动作如何协调以维持最佳网络性能。
性能验证和竞争优势
实际性能测试展示了ConnectX-8相对于传统网络方法的显着优势。在AI训练场景中,Spectrum-X以太网实现比现成RDMA NIC和交换机缩短60%的训练步骤时间。更重要的是,系统即使在多作业场景下也能保持一致性能,而在传统系统中竞争工作负载通常会降低性能。
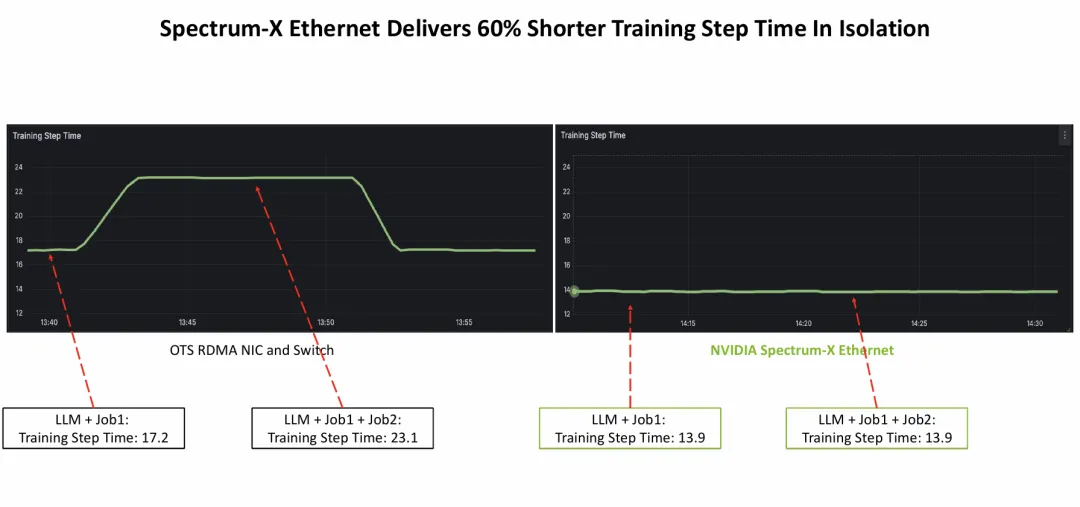
图14:性能图表比较了现成RDMA解决方案与NVIDIA Spectrum-X以太网,显示了60%更短的训练步骤时间和在多作业场景下的一致性能。
尾延迟特征代表另一个关键性能差异化因素。传统网络解决方案在负载下表现出显着的缓冲区堆积和不一致的延迟模式,而带有Spectrum-X以太网的ConnectX-8保持几乎零尾延迟。这种一致性对于同步需求意味着整体系统性能受限于最慢组件的AI工作负载非常重要。
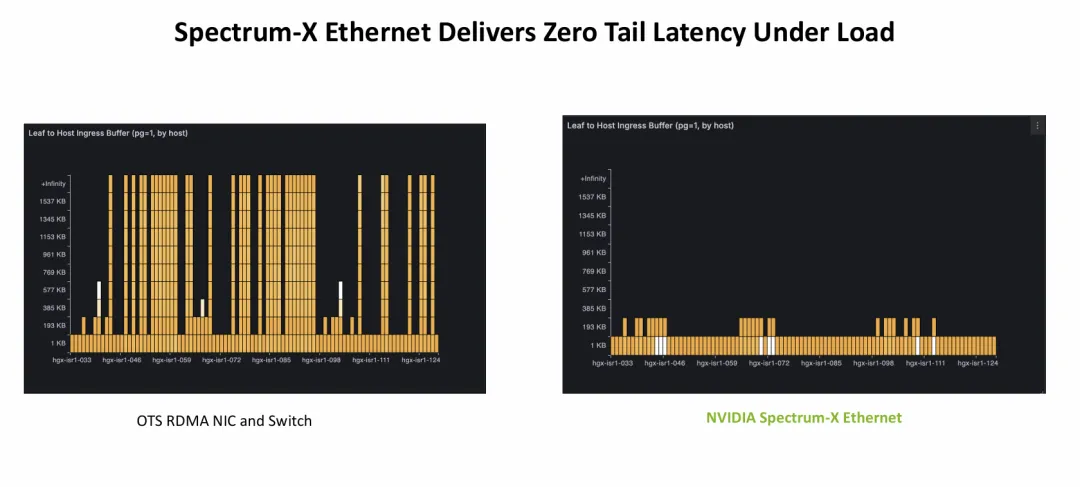
图15:缓冲区利用图展示了Spectrum-X以太网如何保持最小且一致的缓冲区使用,而传统解决方案显示出显着的拥塞和延迟峰值。
全面的性能优势扩展到多个维度,包括通过优化负载均衡实现1.6倍更高的有效带宽、通过噪声隔离实现2.2倍更高的全归约带宽、在尾延迟减少和弹性性能方面均实现1.3倍改进,以及令人瞩目的1000倍更快的遥测收集,实现实时网络适应。
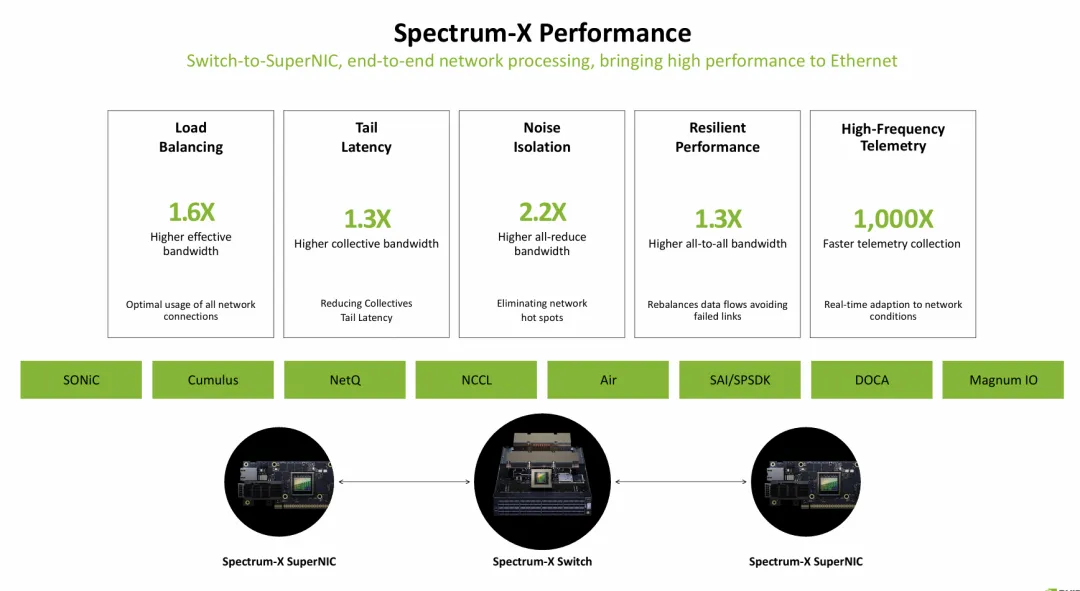
图16:性能总结显示了五个关键领域的量化改进:负载均衡(1.6倍)、尾延迟(1.3倍)、噪声隔离(2.2倍)、弹性性能(1.3倍)和高频遥测(1000倍),以及支持的软件生态系统组件。
ConnectX-8 SuperNIC代表了AI网络基础设施的根本进步,超越了传统网络接口概念,提供集成、智能和可扩展的解决方案。通过先进硬件功能、复杂软件集成和全面系统级优化的结合,ConnectX-8使现代AI工厂的大规模和严格性能需求得以实现。这项技术为下一代AI基础设施奠定了基础,能够支持日益复杂和要求苛刻的工作负载,同时保持生产AI操作所必需的效率和可靠性。
参考文献
[1] I. Burstein, "ConnectX-8 SuperNIC," presented at Hot Chips 2025, 2025.
END
 微信公众号
 bilibili
 微信视频号