


引言
NCCL(NVIDIA集合通信库)已成为分布式人工智能训练中实现GPU间高效通信的核心技术。随着AI模型日益复杂且需要多个GPU协同工作,深入理解NCCL的内部机制对于性能优化和通信瓶颈排查变得十分重要[1]。
分布式训练中的通信挑战
现代AI训练面临的一个重大挑战是通信开销主导整个执行时间。研究表明,在大型语言模型的分布式参数高效微调中,通信可能消耗总迭代时间的一半。随着GPU数量增加,这个瓶颈变得更加明显,尽管有可用的网络带宽容量,但网络带宽利用率仍然不足。
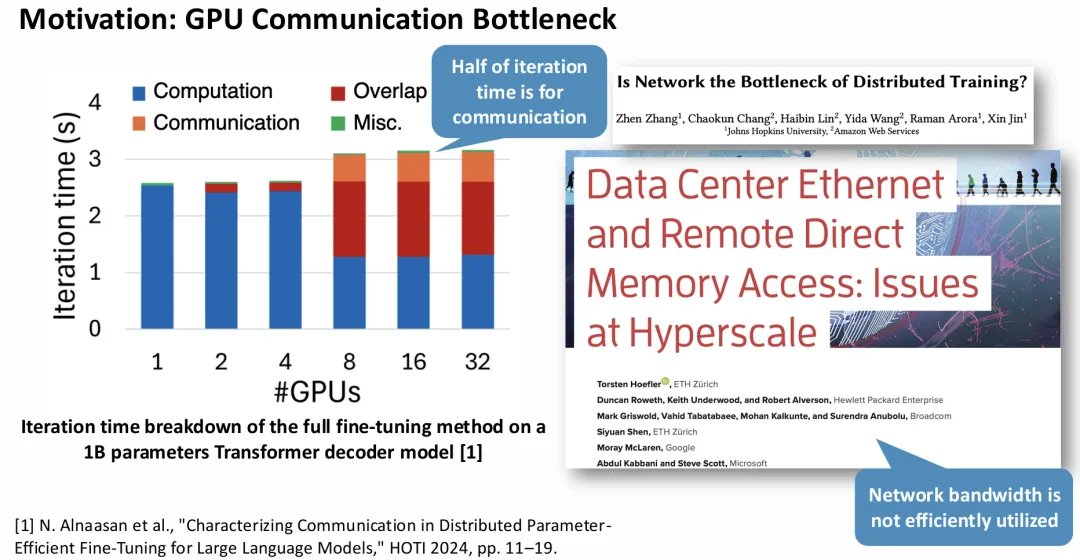
图1:迭代时间分解图,展示通信开销如何随GPU数量增加而增长,突出了分布式训练场景中高效通信协议的重要需求。
这个问题源于分布式训练的基本特性,GPU必须持续交换梯度信息和模型参数。当训练扩展到多个节点时,这种通信成为阻止系统达到完整计算潜力的限制因素。
NCCL作为事实标准
NCCL已确立自身作为GPU加速应用程序标准通信库的地位,特别是在PyTorch和TensorFlow等深度学习框架中。主要研究项目,包括用于训练数十亿参数语言模型的Megatron-LM和用于高效结构化语言模型执行的SGLang,都大量依赖NCCL进行通信需求。

图2:NCCL作为支撑主要深度学习框架和研究项目的基础层的集成方式,展示其在GPU计算生态系统中的核心作用。
尽管应用广泛,NCCL仍然缺乏充分的技术资料,给性能优化带来挑战。用户经常遇到理解何时使用不同算法(如Ring、Tree或NVLS)以及哪些协议在特定场景下提供最佳性能的困难。
通信协议及其权衡
NCCL实现了三种不同的通信协议,每种都针对不同的性能特征进行了优化。Simple协议优先考虑高带宽利用率,通过内存栅栏同步机制实现接近峰值的性能,尽管这种方法每个通信跳引入大约六微秒的延迟。
Low Latency协议采用不同的方法,使用基于标志的同步来实现大约一微秒每跳的延迟。然而,这种速度改进以带宽效率为代价,通常只能达到峰值带宽利用率的25%到50%。
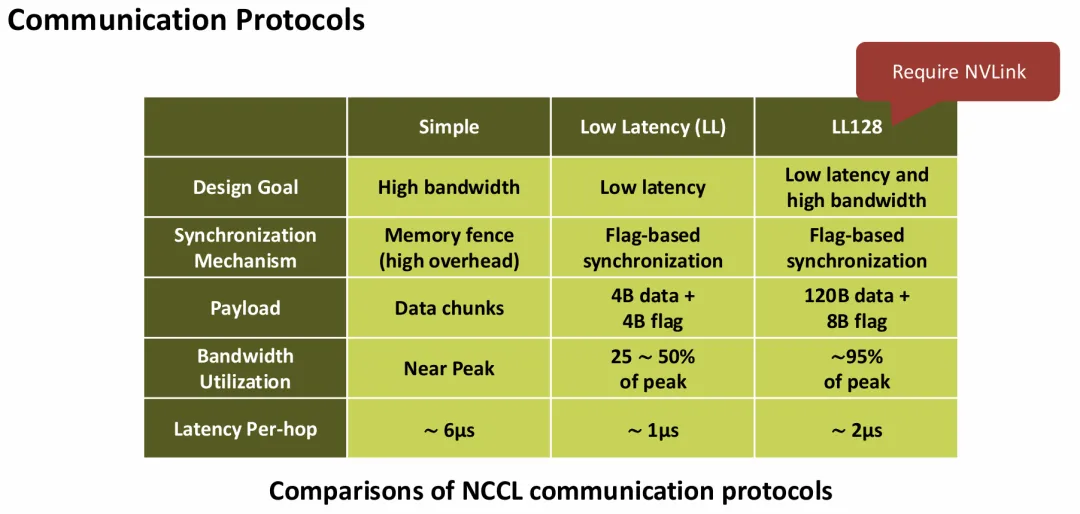
图3:NCCL通信协议的全面比较表,展示Simple、Low Latency和LL128协议在延迟、带宽利用率和硬件需求之间的权衡。
LL128协议代表了这些极端之间的精密折衷。需要NVLink连接,通过120字节数据加8字节标志的优化载荷结构,保持大约两微秒延迟的同时实现大约95%的带宽利用率。
数据传输机制
NCCL对节点内通信和节点间通信采用不同的数据移动策略。对于节点内通信,该库可以利用共享主机内存或直接GPU内存路径。当NVLink连接可用时,NCCL优先在GPU内存之间直接路由数据,最小化延迟并最大化吞吐量。
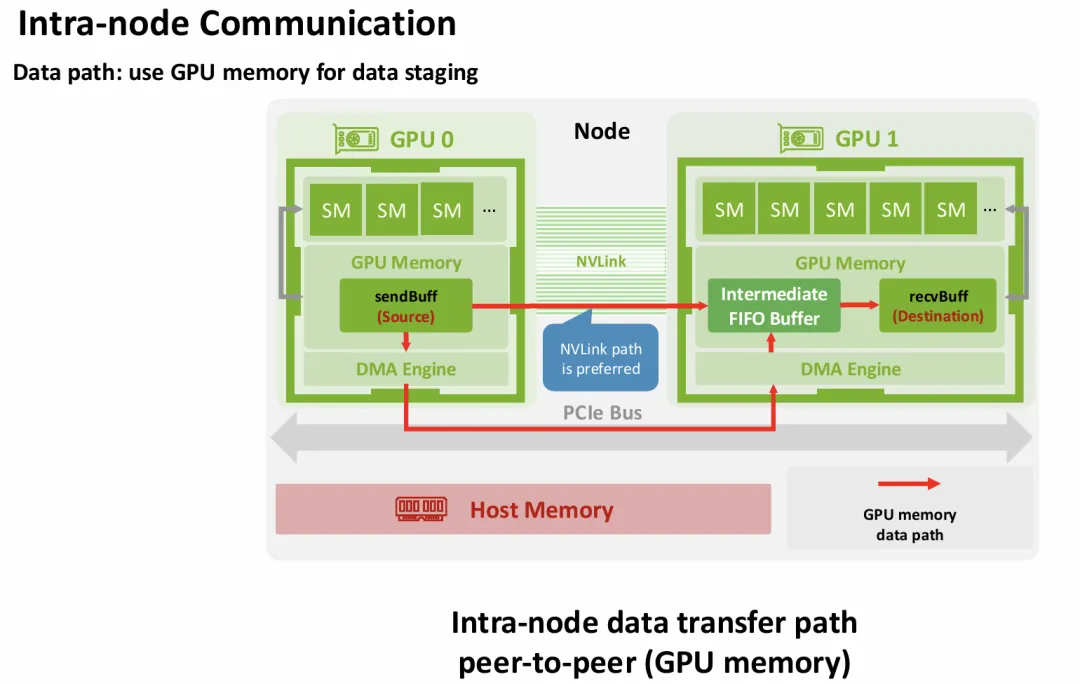
图4:节点内数据传输路径图,展示NCCL如何通过在NVLink可用时优先选择直接GPU内存访问来优化通信,并使用中间FIFO缓冲来提高效率。
节点间通信呈现更复杂的挑战,需要GPU内存、主机内存和网络接口之间的协调。NCCL支持各种传输机制,包括TCP套接字、InfiniBand和GPU Direct RDMA优化,每种都根据底层硬件基础设施提供不同的性能特征。
集合算法和迭代执行
NCCL采用迭代执行模式来处理大型数据集,将总输入数据分解为更小的数据块。这种方法允许系统有效管理内存使用,同时保持高吞吐量。数据被分配给不同的通道,每个通道由特定的流式多处理器(SM)处理。
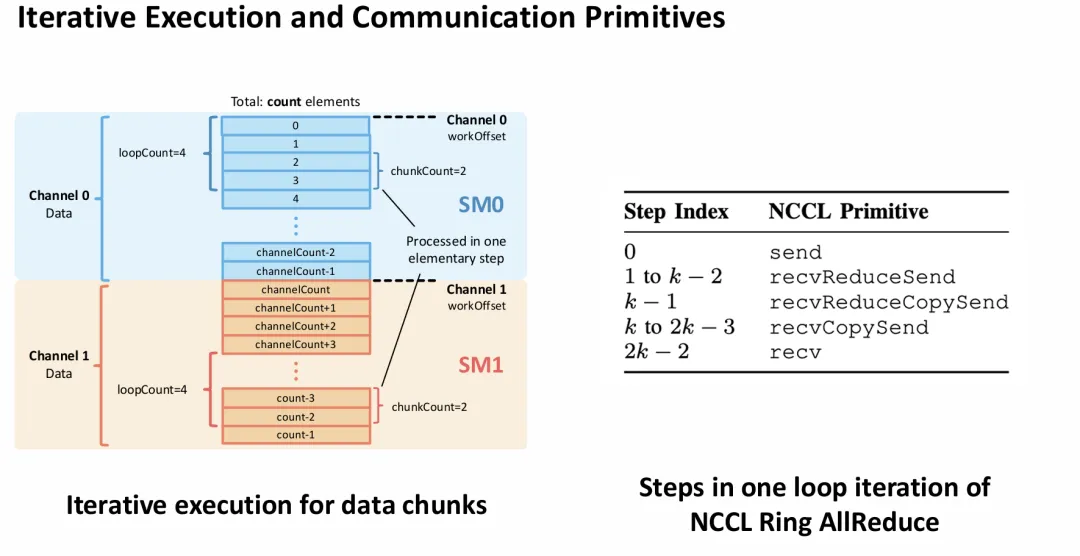
图5:迭代执行数据块处理示意图,展示数据如何被分配给不同通道并由相应的流式多处理器处理,以及NCCL Ring AllReduce中一个循环迭代的步骤。
Ring AllReduce算法是NCCL中最重要的集合操作之一。该算法分为两个主要阶段:ReduceScatter阶段和AllGather阶段。在ReduceScatter阶段,每个GPU接收来自其邻居的数据,执行归约操作,然后将结果转发到环中的下一个GPU。
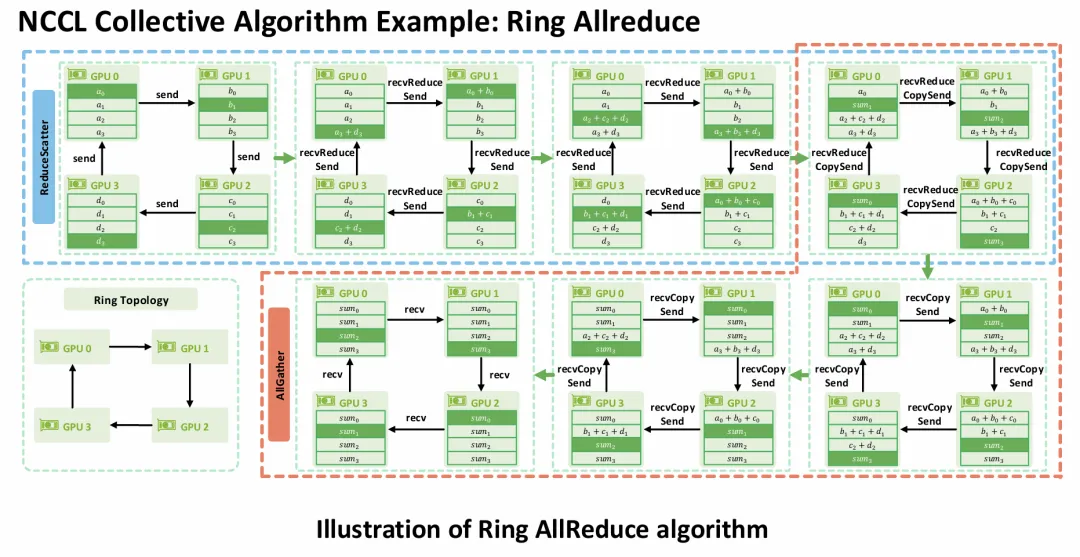
图6:Ring AllReduce算法完整流程图,详细展示ReduceScatter和AllGather两个阶段中每个GPU如何处理数据并执行相应的通信原语。
在AllGather阶段,已归约的结果在环中传播,确保每个GPU最终获得完整的归约结果。这种方法提供了良好的带宽利用率和可扩展性,使其成为大规模分布式训练的首选算法。
性能基准测试结果
在Alps超级计算机上进行的基准测试展示了不同NCCL配置的性能特征。测试平台采用Grace Hopper超级芯片(GH200),具有150 GB/s的节点内通信能力和25 GB/s的Cray Slingshot网络连接。
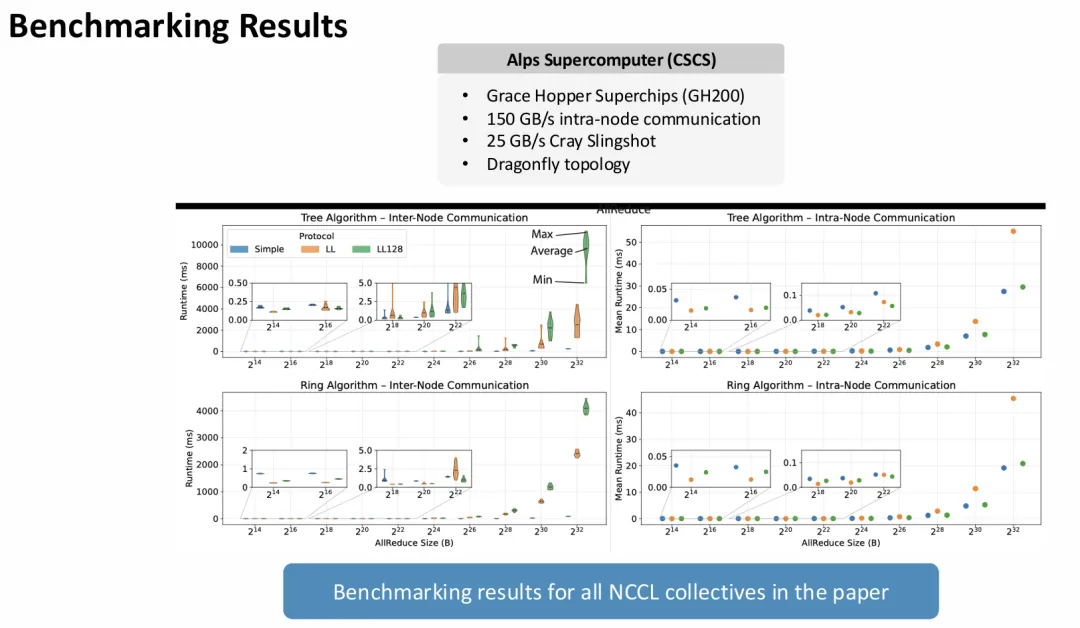
图7:在Alps超级计算机上进行的NCCL性能基准测试结果,展示不同算法和协议在节点间和节点内通信场景下的带宽和延迟表现。
测试结果表明,Tree算法在节点间通信中表现出色,而Ring算法在节点内通信场景下提供更好的性能。协议选择对性能有显著影响,LL128协议在支持NVLink的配置中展现出最佳的综合性能。
理解这些机制使从业者能够就硬件配置和软件优化做出明智决策,最终在现代AI开发中实现更高效的分布式训练工作流程和更好的昂贵GPU资源利用率。通过深入掌握NCCL的工作原理,开发者可以针对特定的硬件配置和训练需求选择最合适的通信策略。
参考文献
[1] Z. Hu, S. Shen, T. Bonato, S. Jeaugey, C. Alexander, E. Spada, J. Dinan, J. Hammond, and T. Hoefler, "Demystifying NCCL: An in-depth analysis of GPU communication protocols and algorithms," ETH Zurich, NVIDIA Corporation, Broadcom Inc., 2025.
 微信公众号
 bilibili
 微信视频号