


引言
高性能计算和人工智能领域的快速发展对网络基础设施提出了严格要求,需要处理大规模数据吞吐量的同时保持极低延迟。博通公司的Tomahawk Ultra代表了这一领域的技术进步,专门针对HPC和AI scale-up应用的独特挑战而设计,通过先进的Ethernet交换技术提供解决方案[1]。
01
Ethernet技术误解的澄清
传统网络方案在HPC环境中面临质疑,主要源于对Ethernet能力的几个持续误解。许多工程师长期认为Ethernet天生存在高延迟、小数据包性能差、易丢包以及报头开销过大等问题。Tomahawk Ultra直接挑战了这些假设,证明现代Ethernet技术能够达到以往认为不可能实现的性能水平。
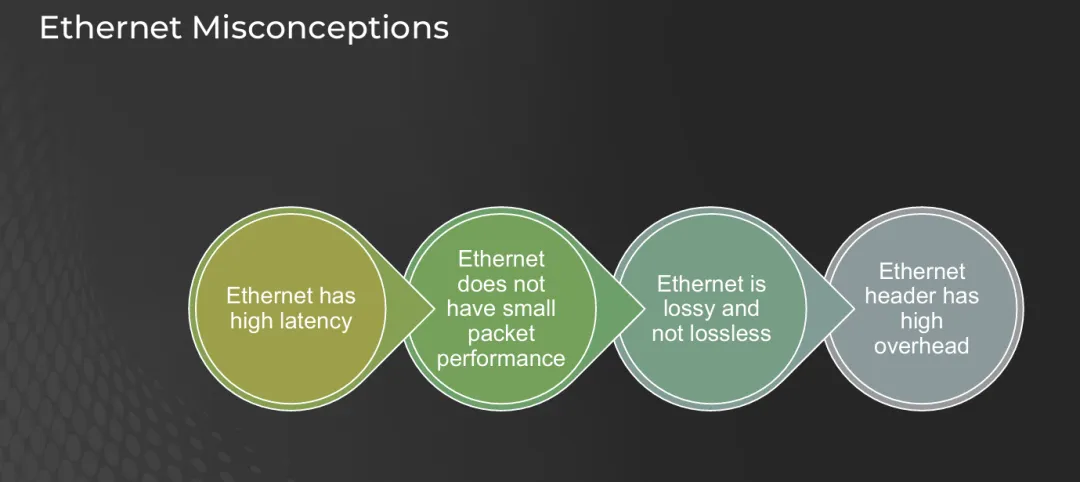
图1:Tomahawk Ultra解决的常见Ethernet误解,包括对延迟、数据包性能、可靠性和开销的担忧
Ethernet技术的演进已经从根本上改变了性能特性。传统实现可能在延迟敏感应用中表现不佳,而Tomahawk Ultra实现了小于250纳秒的交换延迟,同时在所有端口保持满吞吐量。这种性能水平使Ethernet与长期主导HPC环境的专用互连技术相提并论。
02
全面的功能架构
Tomahawk Ultra的设计理念围绕为HPC和AI scale-up工作负载提供完整解决方案。该交换机在64字节数据包条件下提供51.2太比特每秒的带宽,实现每秒770亿数据包的处理能力。这种卓越性能源于精心设计的数据包转发流水线,优化了数据处理的每个阶段。
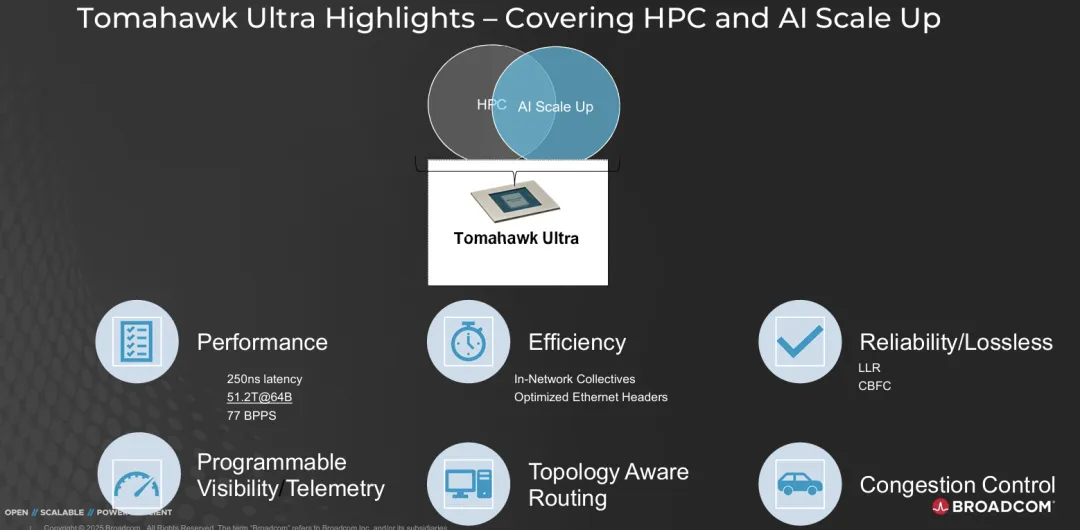
图2:Tomahawk Ultra关键功能概览,涵盖性能、效率、可靠性、可编程性、路由和拥塞控制
数据包转发架构整合了多个专用引擎协同工作。入口流水线处理Ethernet MAC处理、解析、转发查找、过滤和自适应路由决策。同时,专用引擎管理集合操作卸载和遥测收集。出口流水线通过报头重写和最终MAC处理完成整个过程,确保数据包的优化传输。
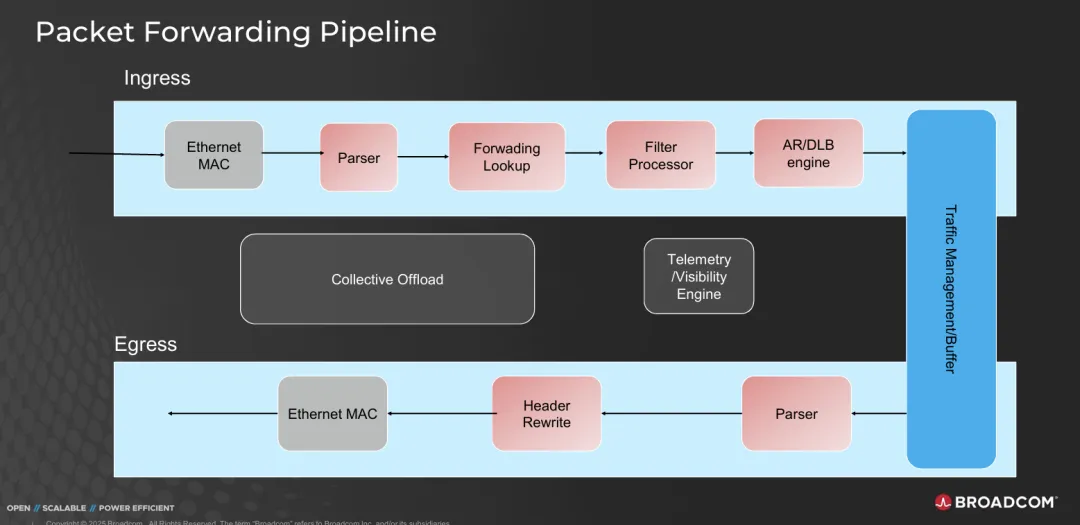
图3:详细的数据包转发流水线,显示入口和出口处理阶段,包括用于集合卸载和遥测的专用引擎
03
通过链路层重传增强可靠性
Tomahawk Ultra最重要的创新之一是链路层重传(LLR)技术的实现。该功能解决了高性能网络中的一个关键挑战,即使是轻微的传输错误也可能级联成严重的性能下降。LLR通过为传输数据包维护序列号并在检测到错误时实现自动重传机制来运行。
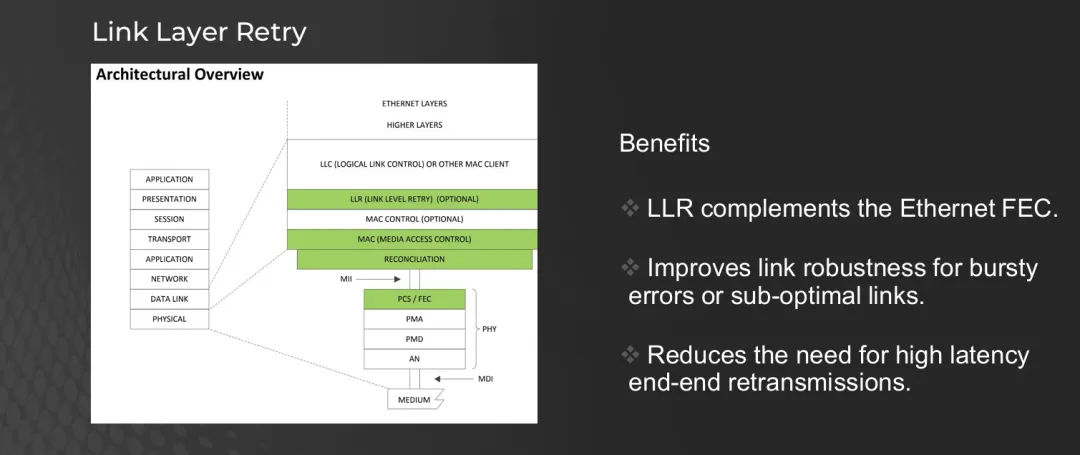
图4:链路层重传实现的架构概览,显示如何补充现有的Ethernet FEC机制
LLR系统的工作原理是发送端在Ethernet前导码中嵌入序列号并为传输的数据包维护重放缓冲区。当接收端检测到错误或丢失的数据包时,发送否定确认触发自动重传。这种方法显著减少了昂贵的端到端重传需求,同时提高整体链路鲁棒性,这对HPC应用的严格要求特别重要。
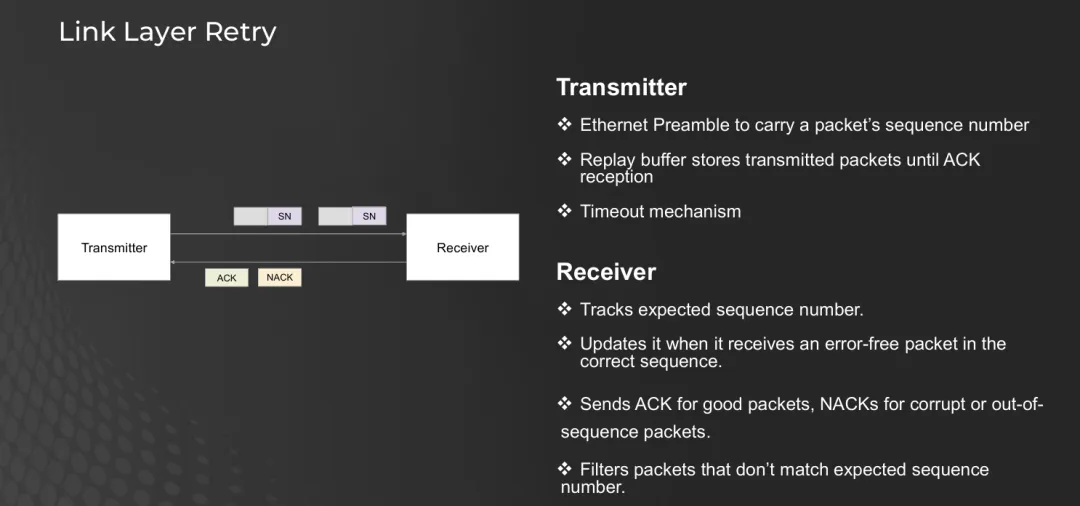
图5:详细的LLR操作,显示发送端和接收端功能以及序列编号和确认机制
04
基于信用的流控制实现无损操作
高性能计算应用需要确定性行为和零数据包丢失。Tomahawk Ultra通过复杂的基于信用的流控制(CBFC)机制实现这一目标,即使在重负载条件下也能确保可靠的数据传输。CBFC的运行方式是接收端为每个无损流量类别保留缓冲区空间,并通过信用消息向发送端通信缓冲区可用性。
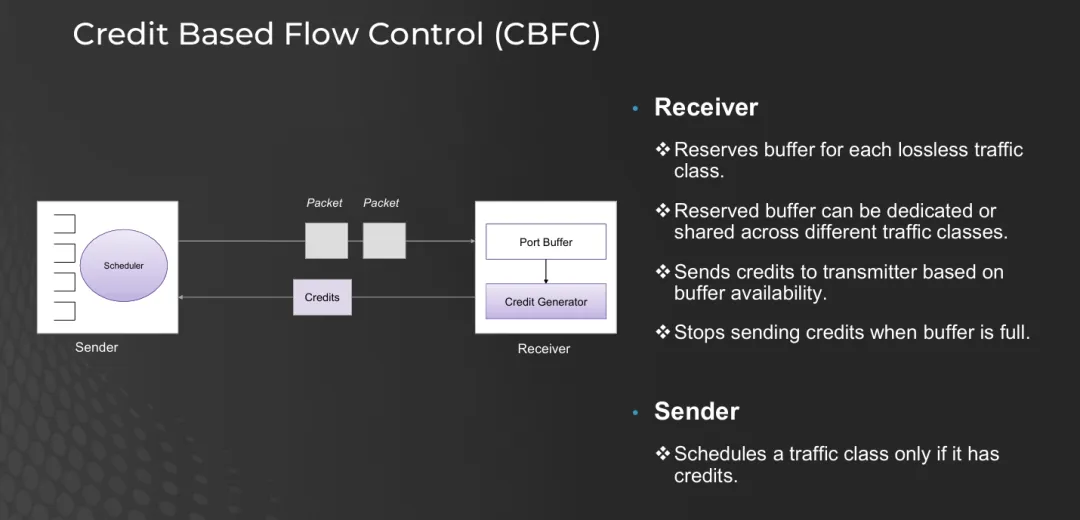
图6:基于信用的流控制架构,显示发送端和接收端如何通过缓冲区管理协调以防止数据包丢失
这种基于信用的方法能够对流量流进行细粒度控制,同时保持可用带宽的高利用率。发送端仅在有足够信用时才传输数据包,确保接收端缓冲区永不溢出。系统支持专用和共享缓冲区分配策略,为不同应用需求提供灵活性,同时维护HPC工作负载必需的无损保证。
05
优化报头提高效率
传统Ethernet和IP报头对于频繁传输小负载的HPC应用而言代表着显著开销。Tomahawk Ultra引入AI Fabric报头(AFH)格式,在保持完全Ethernet兼容性的同时大幅减少报头开销。AFH覆盖在标准Ethernet MAC报头之上,仅包含交换操作所需的基本字段。
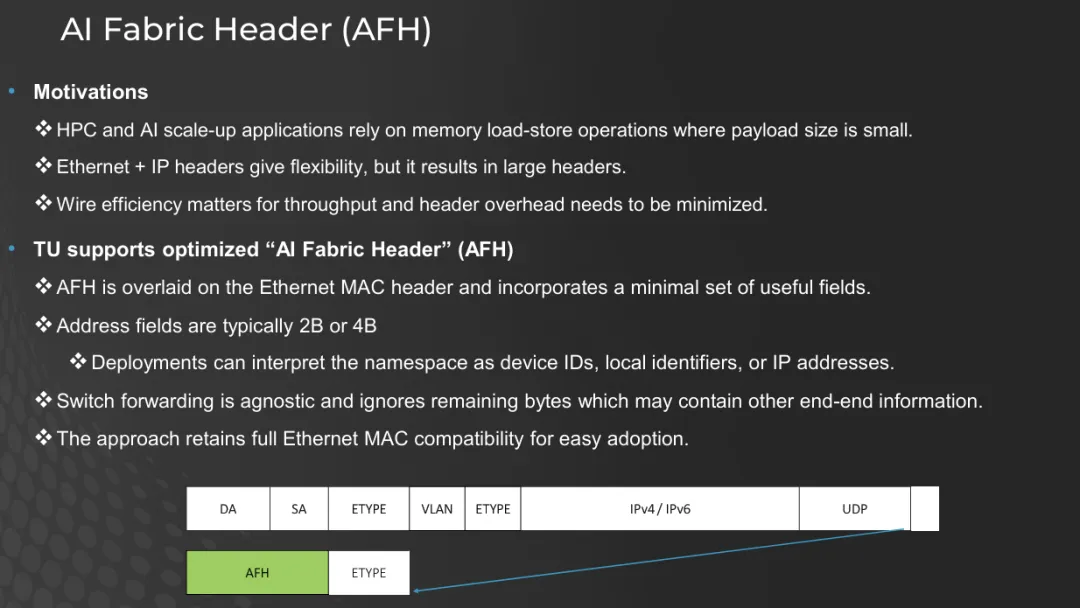
图7:AI Fabric报头结构,显示与传统Ethernet加IP报头相比如何减少开销,同时保持兼容性
AFH实现支持针对不同寻址需求优化的两种主要变体。紧凑格式仅使用6字节用于交换信息,将数据包的其余部分留给端到端通信。这种方法实现了小数据包HPC应用关键的线路效率,同时保留了Ethernet网络的操作优势和生态系统兼容性。
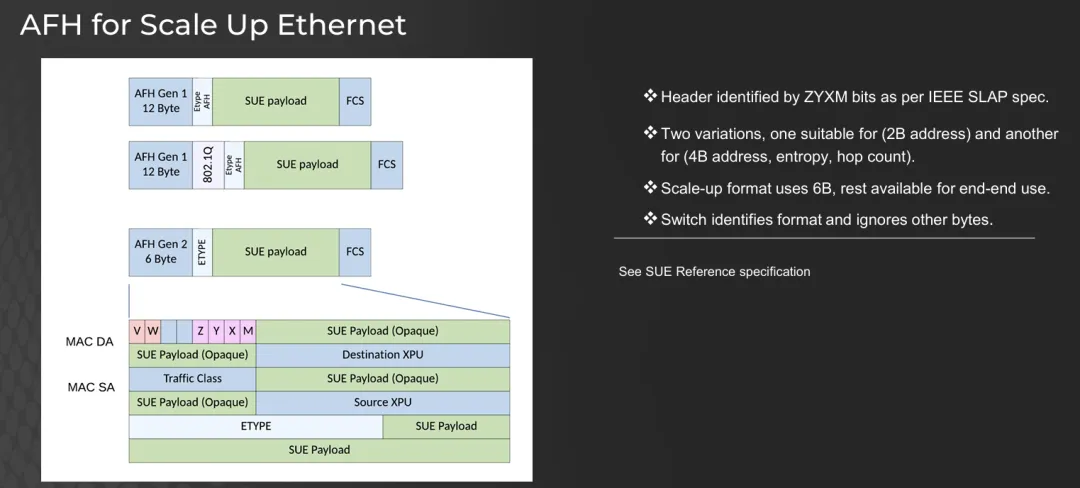
图8:Scale-Up Ethernet报头格式,显示针对不同寻址方案优化的两种AFH变体及与标准Ethernet帧的关系
06
网络内集合操作
现代AI和机器学习工作负载严重依赖于集合通信模式,如all-reduce、广播和聚集操作。Tomahawk Ultra通过网络内集合(INC)功能为这些操作提供专用硬件支持。这种方法将集合处理从端点卸载到网络基础设施,显著减少通信延迟并提高整体系统效率。
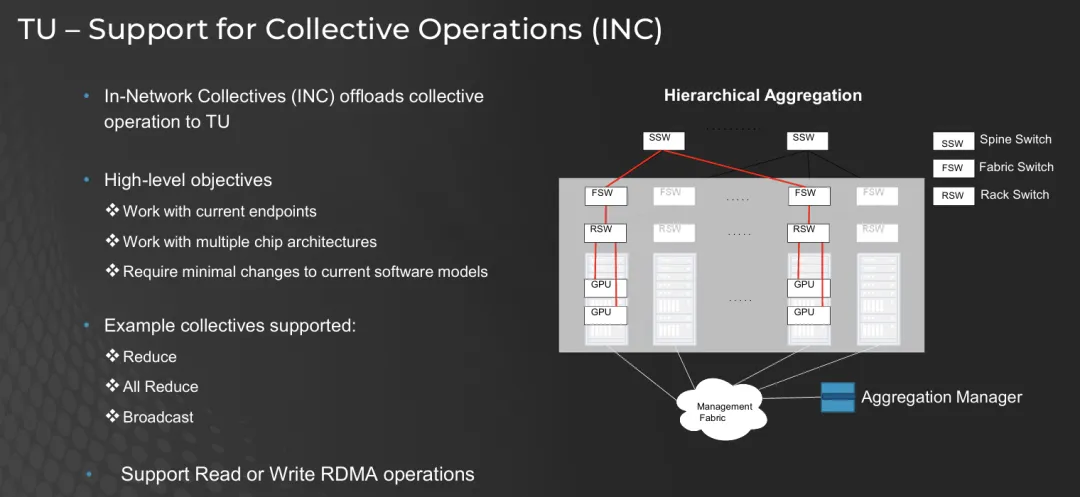
图9:分层聚合架构,显示网络内集合如何在不同网络层次支持各种通信模式
INC实现支持读写RDMA操作,同时与现有端点和软件栈无缝协作。通过在网络Fabric内执行聚合操作,系统减少了必须穿越网络的消息数量,同时加速常见的AI训练和推理工作流程。这种能力代表了向更智能网络基础设施的根本转变,使网络基础设施能够主动参与计算工作负载。
07
拓扑感知自适应路由
复杂的HPC和AI系统通常采用复杂的网络拓扑来优化通信模式和系统可扩展性。Tomahawk Ultra包含先进的自适应路由功能,理解并优化这些特定拓扑需求。路由引擎支持分层、树状和网格拓扑,包括DragonFly+、CLOS和3D环形配置。
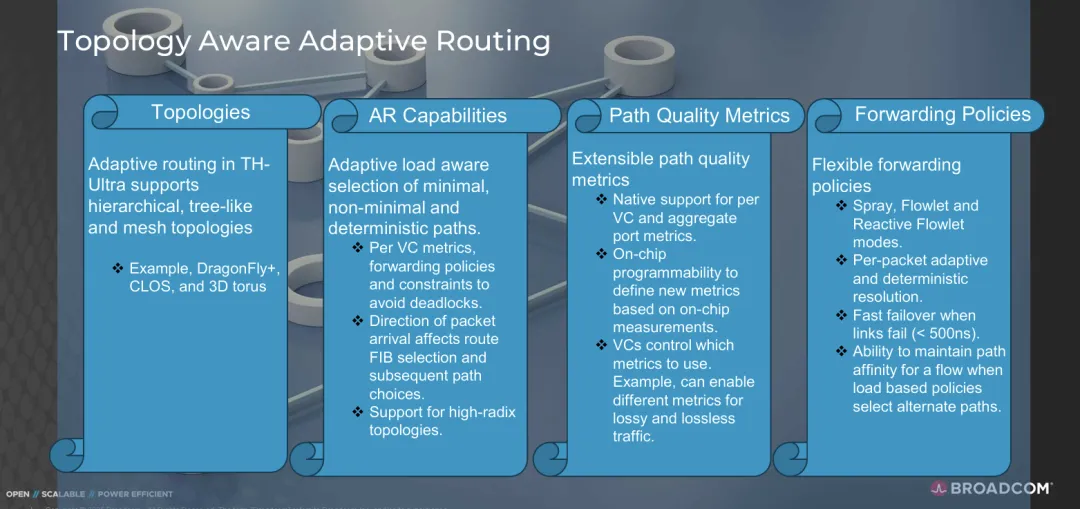
图10:拓扑感知自适应路由功能的全面概览,包括对各种网络架构和转发策略的支持
自适应路由系统持续监控网络状况,并基于实时指标动态选择最优路径。支持多种转发策略,包括喷洒、流单元和反应式流单元模式,能够进行逐包自适应决策,同时在需要时保持流亲和性。快速故障转移功能确保在链路故障时500纳秒以下的恢复,即使在组件故障期间也能保持系统可用性。
08
性能验证和实际结果
全面测试证明Tomahawk Ultra在多个关键指标上兑现了性能承诺。实验室测量确认在所有端口上实现64字节数据包的线速性能,验证了交换机处理HPC应用典型的高要求小数据包工作负载的能力。
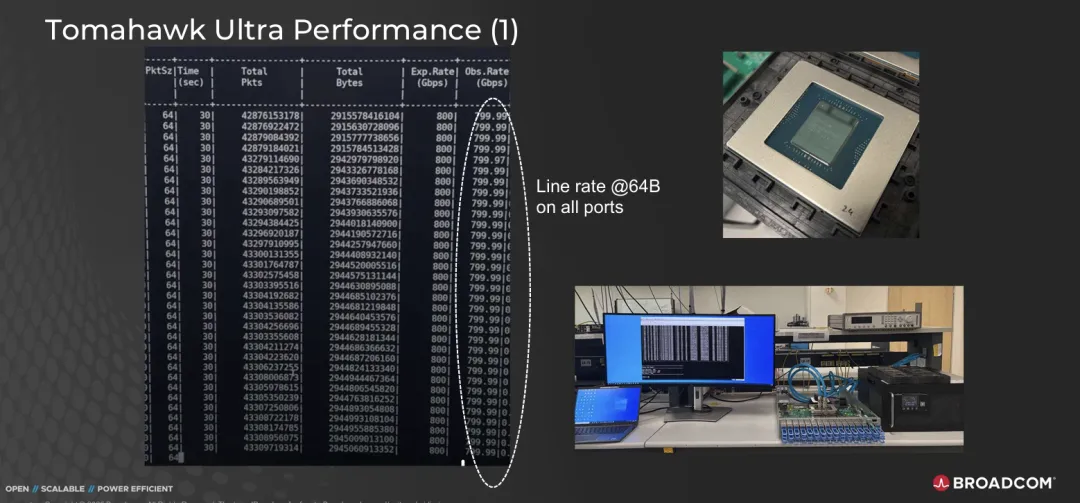
图11:性能测量数据,显示所有端口在64字节数据包条件下实现线速吞吐量
延迟测量显示在所有流量场景中保持一致的250纳秒以下交换性能。这种卓越的延迟性能结合高吞吐量能力,使Tomahawk Ultra成为传统上需要专用互连技术的延迟敏感HPC和AI工作负载的有力解决方案。
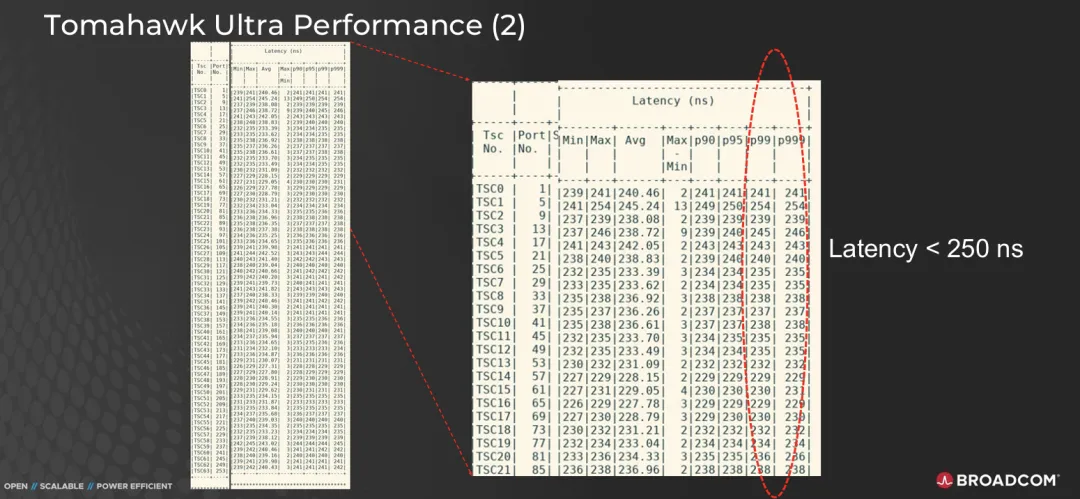
图12:详细的延迟测量,确认在多个测试场景和流量模式中的250纳秒以下性能
09
战略市场定位
博通的交换机产品组合现在为整个高性能计算和AI应用范围提供全面覆盖。Tomahawk Ultra专门针对HPC和AI scale-up市场,补充了用于AI scale-out应用的更高带宽Tomahawk 6和用于区域规模部署的Jericho4。
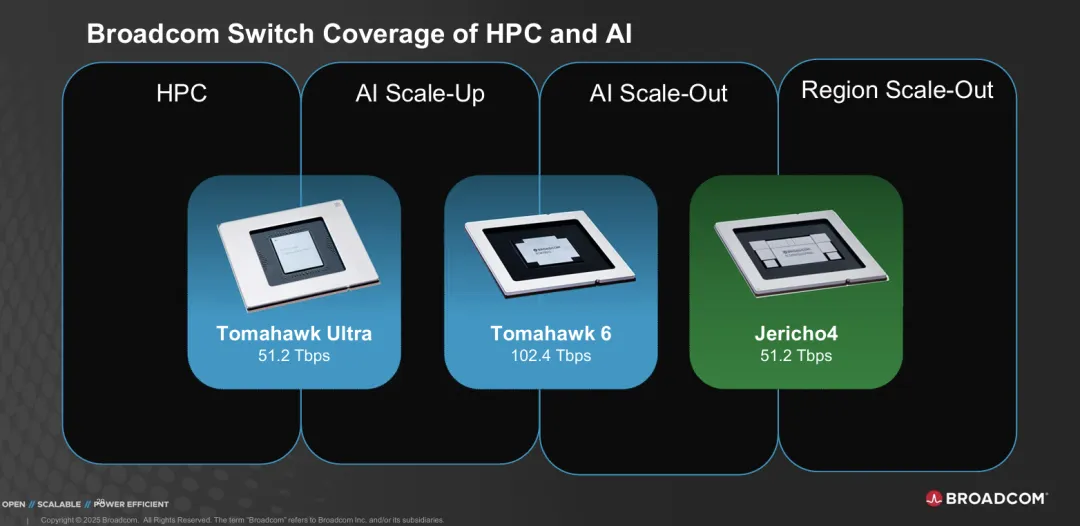
图13:博通完整的交换机产品组合,显示不同产品如何满足HPC和AI市场格局的各个细分领域
这种战略定位使组织能够在不同计算环境中部署一致的基于Ethernet的解决方案,同时针对特定性能和规模需求优化每个部署。Tomahawk Ultra与之前Tomahawk世代的封装和功耗兼容性有助于快速部署,减少系统集成商和最终用户的产品上市时间。
Tomahawk Ultra代表了网络技术的基础演进,证明Ethernet能够成功满足现代HPC和AI应用的最苛刻要求。通过链路层重传、优化报头、网络内集合和先进自适应路由等创新功能,实现了以往仅能通过专用互连技术达到的性能水平。这一进步为高性能计算环境中基于标准的经济高效网络解决方案提供了新的选择,同时保持了使Ethernet在大规模部署中具有吸引力的操作优势和生态系统成熟度。
参考来源
[1] M. Kalkunte and A. Khamisy, "Tomahawk Ultra – Ultra Low Latency, High Bandwidth Ethernet Switch for HPC & AI/ML applications," Broadcom Inc., Aug. 2025.
 微信公众号
 bilibili
 微信视频号