


01
数据中心环境下的Scale-Up架构
现代人工智能集群需要复杂的网络架构来处理大型模型训练的巨大计算需求。这些系统的基础在于理解scale-up fabric如何与传统scale-out方法不同,以及如何在更广泛的数据中心生态系统中进行集成[1]。
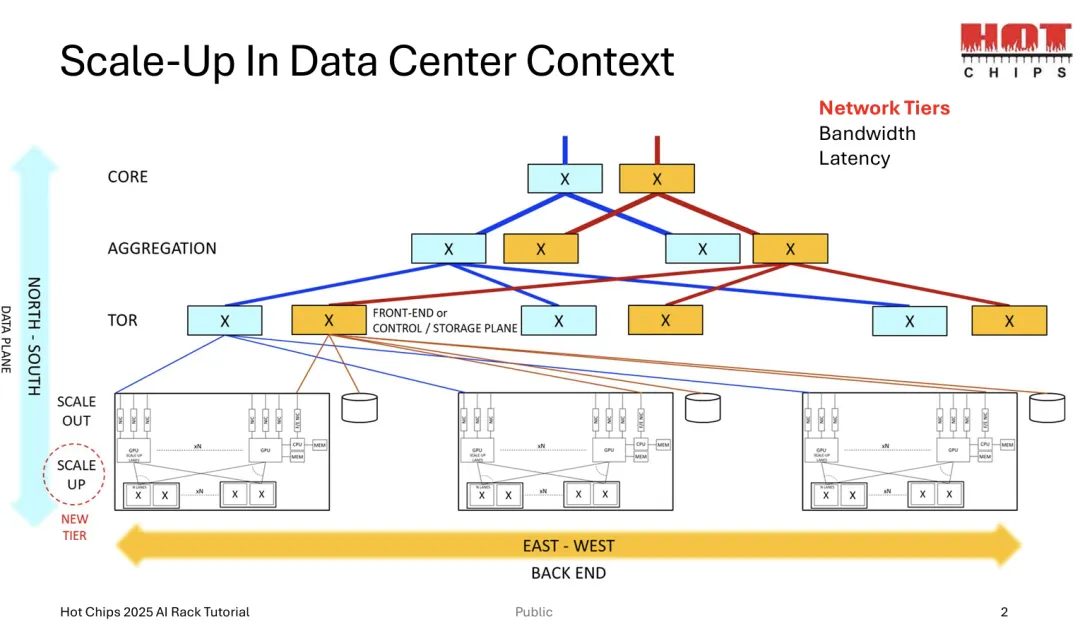
图1:数据中心的分层网络结构,说明scale-up fabric如何适配更广泛的网络生态系统,包括从核心层到汇聚层和TOR层的带宽和延迟考虑因素。
Scale-up架构代表着从传统分布式计算模型的根本转变。Scale-up系统创建紧密耦合的高性能处理器集群,更直接地共享内存和计算资源,而不是通过网络fabric连接许多较小的计算单元。在训练大型语言模型或其他需要处理单元之间频繁通信的AI系统时,这种方法变得必要。
数据中心环境揭示了多个网络层级,每个层级服务于不同目的。Scale-up fabric在最底层运行,连接单个计算域内的GPU。在此之上是scale-out网络,将不同的scale-up域连接在一起。理解这种层级结构有助于解释为什么scale-up fabric面临与传统网络方法相比独特的工程挑战。
02
Scale-Up与Scale-Out网络方法对比
Scale-up和scale-out网络之间的区别从根本上塑造了AI集群的设计和部署方式。Scale-out网络通常遵循已建立的模式,如Clos架构、叶脊拓扑或各种mesh配置。这些方法适用于分布式应用程序,其中各个节点可以在某种程度上独立运行,偶尔的网络延迟是可以接受的。
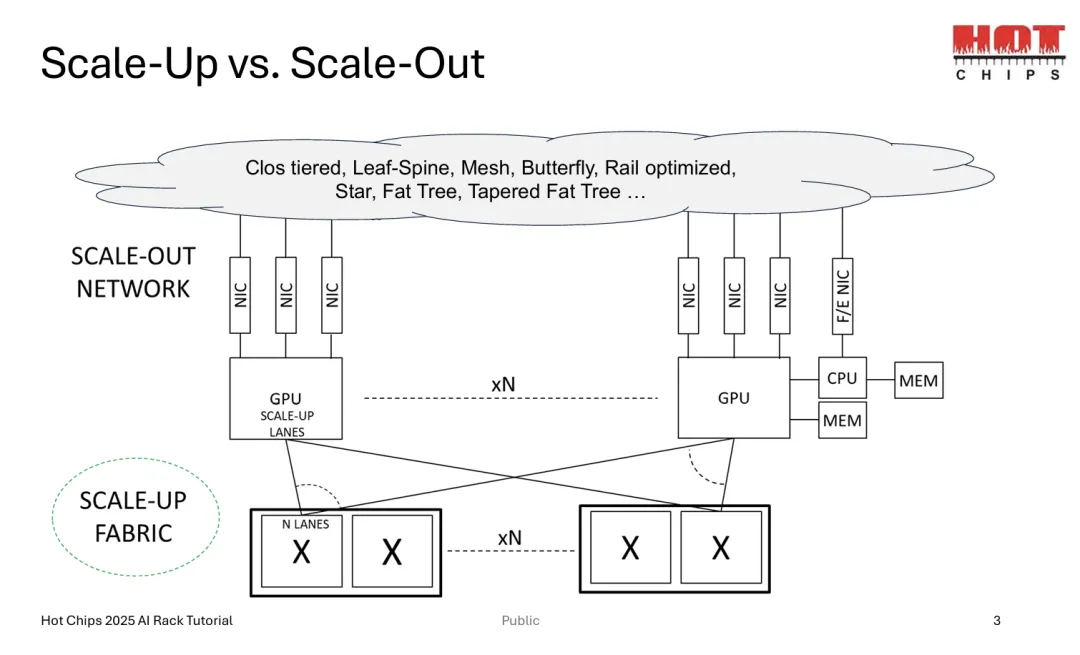
图2:说明scale-up和scale-out方法之间的根本区别,展示scale-up fabric如何在处理器之间创建直接、高带宽连接,而scale-out网络使用传统的交换层次结构。
然而,scale-up fabric必须在处理元素之间提供更紧密的耦合。在训练大型AI模型时,处理器需要频繁同步,在整个集群中共享梯度和模型参数。这种通信中的任何延迟都直接影响训练性能,使得低延迟、高带宽连接变得必要。
图中显示的scale-up fabric使用处理单元之间的直接连接,最小化网络跳数并减少延迟。这创建了看起来像单个大型计算系统的效果,而不是网络计算机的集合。挑战在于将这种方法扩展到更多数量的处理器,同时保持使scale-up架构有价值的性能特性。
03
当前Scale-Up Fabric技术
几种竞争技术已经出现来解决scale-up网络挑战,每种技术都采用不同方法来解决带宽、延迟和规模的基本问题。
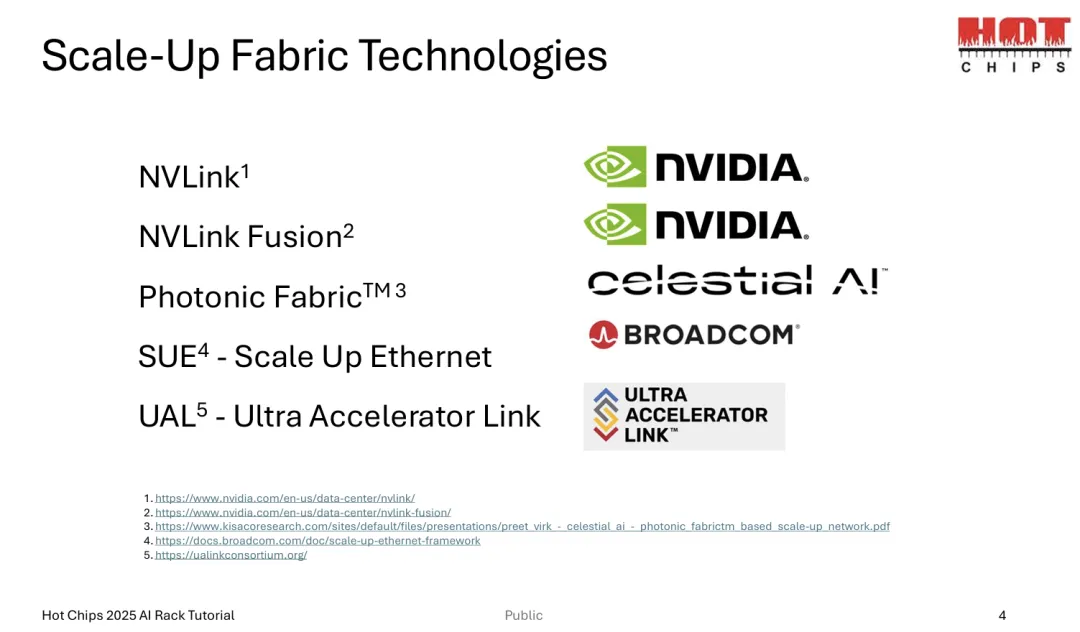
图3:目前可用的主要scale-up fabric技术,包括NVIDIA的NVLink和NVLink Fusion、Celestial AI的Photonic Fabric、Broadcom的Scale Up Ethernet以及Ultra Accelerator Link联盟。
NVIDIA的NVLink代表目前部署的最成熟的scale-up技术。NVLink提供处理器到处理器的直接连接,具有极高带宽和低延迟。较新的NVLink Fusion通过允许NVLink域在更长距离上连接来扩展这一概念,可能跨越多个机架甚至数据中心行。
Celestial AI的Photonic Fabric采用不同方法,使用光互连来实现scale-up系统的带宽和延迟要求。光子技术解决方案在带宽密度和功率效率方面提供理论优势,尽管目前在成本和复杂性方面面临挑战。
Broadcom的Scale Up Ethernet(SUE)试图利用以太网技术的庞大生态系统,同时添加scale-up应用所需的性能特性。这种方法可能提供成本优势和更广泛的行业支持,尽管需要仔细工程设计来匹配专用解决方案的性能。
Ultra Accelerator Link(UAL)联盟代表行业标准化scale-up互连的努力,可能允许不同供应商的处理器在scale-up配置中协同工作。这种标准化对于scale-up架构的更广泛采用可能是关键的。
04
基本Scale-Up拓扑设计
理解scale-up拓扑如何工作需要检查处理器、交换机和驱动系统设计的带宽需求之间的关系。最简单的scale-up配置通过交换fabric连接处理器,为任意一对处理器之间提供全带宽。
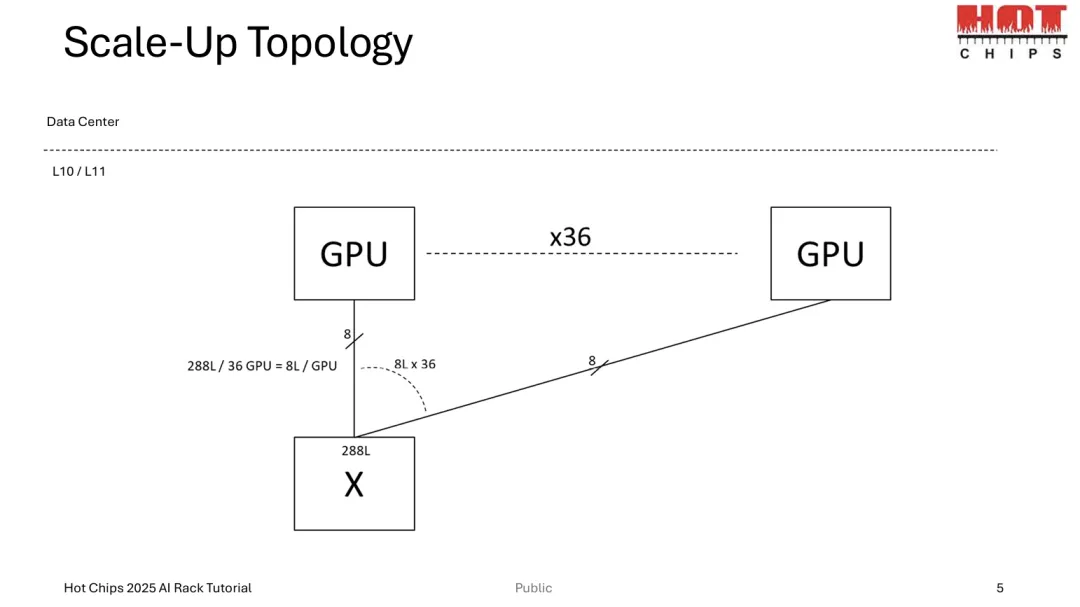
图4:基本的scale-up拓扑,其中GPU通过交换fabric连接,演示36个GPU如何通过特定的每连接带宽分配进行互连。
在这种基本配置中,每个GPU维护到交换fabric的多个高速连接。每个连接的带宽和连接数量决定任意两个处理器之间可以流动多少数据。对于AI训练工作负载,这种带宽直接影响系统在所有处理器之间同步模型参数和梯度的速度。
检查带宽需求时,scale-up系统的数学变得明显。36个GPU每个需要8个连接通道,交换fabric必须处理总共288个通道。交换机基数或每个交换机的端口数量,决定这种连接性如何分布在多个交换元素上。
05
GPU数量与交换机基数关系
GPU数量与交换机基数之间的关系代表scale-up系统中最关键的设计决策之一。更高基数的交换机可以直接连接更多处理器,减少网络跳数并提高性能。然而,更高基数的交换机更昂贵且在技术上更难实现。
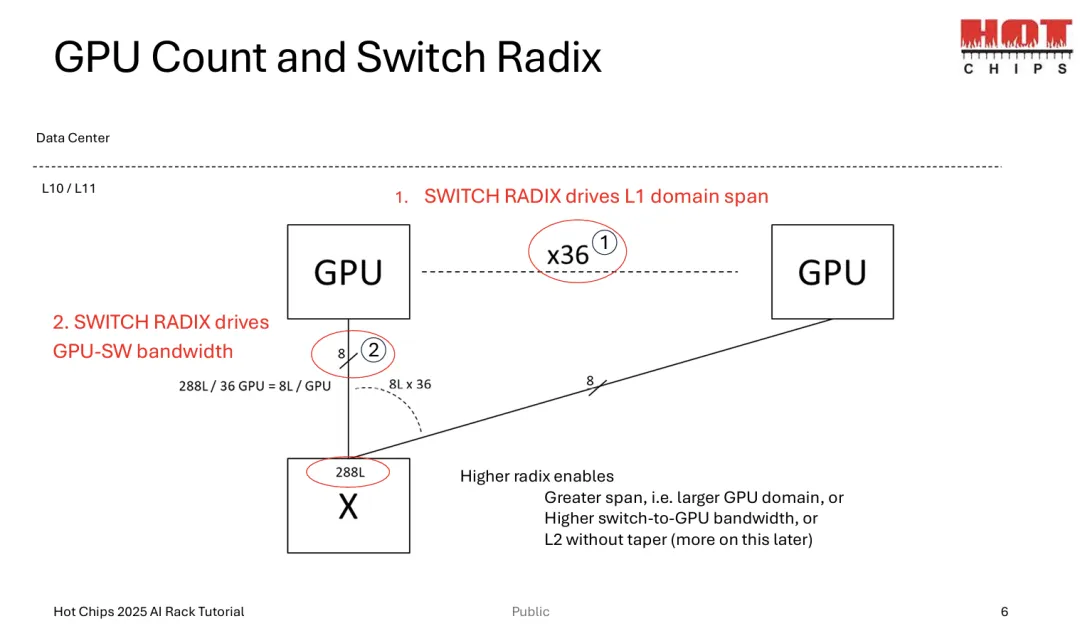
图5:交换机基数如何驱动L1域跨度和GPU到交换机带宽,展示域大小与连接密度之间的权衡。
交换机基数主要通过两种方式影响系统。首先,决定多少处理器可以连接在单个交换域中。更高基数的交换机可以支持更多处理器而不需要额外的交换层,这提高了性能并简化了系统设计。
其次,交换机基数影响每个处理器与交换fabric之间的可用带宽。在固定数量的交换机端口下,添加更多处理器意味着每个处理器获得更少到交换机的连接,减少可用带宽。这在规模和每处理器性能之间创建了基本权衡。
图表说明了这些关系在实践中如何发挥作用。有36个GPU和支持特定基数计数的交换机,系统设计师必须在所需交换机数量与每个处理器可用带宽之间进行平衡。更高基数的交换机能够实现更大的域或更高的每处理器带宽,但也增加了成本和复杂性。
06
GPU Scale-Up带宽和交换机数量分析
Scale-up系统的带宽需求驱动所需交换机数量和整体系统复杂性。随着处理器数量增加,总带宽需求呈二次方增长,因为每个处理器可能需要与其他每个处理器通信。
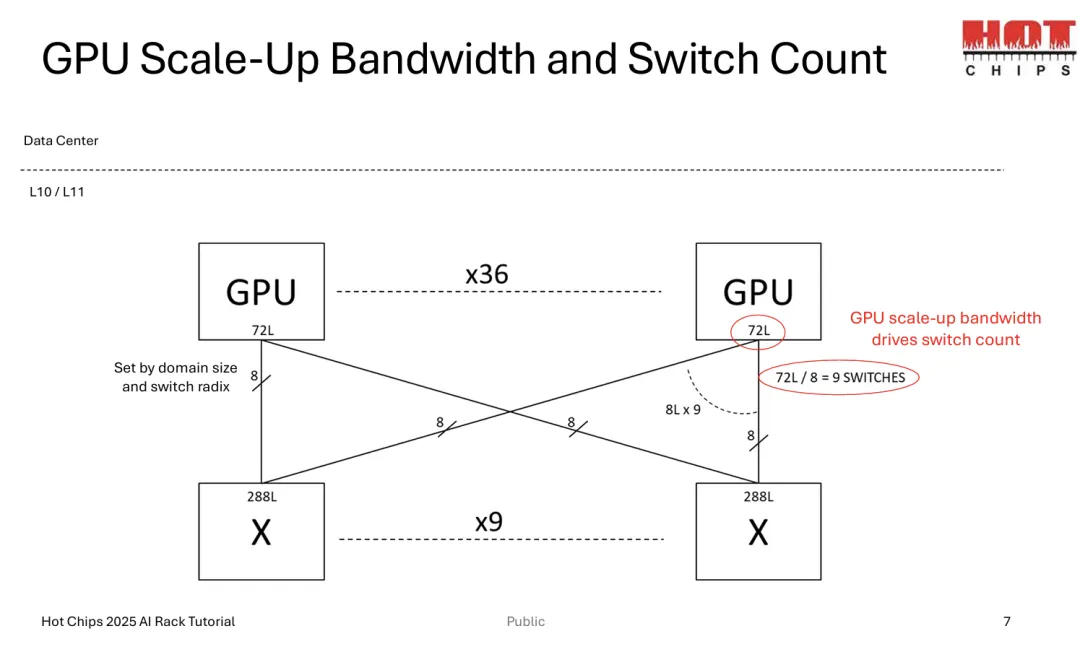
图6:GPU scale-up带宽需求如何驱动交换机数量,说明域大小、交换机基数与所需交换机数量之间的关系。
在显示的示例中,36个GPU每个需要72个连接通道,创建总共2592个通道的总带宽需求。这必须根据交换机的基数能力分布在多个交换机上。计算显示,对于支持每个288通道的交换机,需要九个交换机来提供必要的连接性。
这种分析揭示了为什么scale-up系统在更大规模下变得具有挑战性。交换机数量随着处理器计数的平方增长,导致成本、功耗和复杂性的指数增长。每个额外的处理器不仅需要自己的连接,还增加了所有现有处理器的带宽需求。
带宽计算还有助于解释为什么scale-up系统通常在特定大小处达到平台期。超过某个点,交换fabric的成本和复杂性开始超过紧密耦合架构的性能优势。
07
L10/L11分区挑战
实际scale-up系统必须跨物理基础设施进行分区,在机械设计、信号完整性和系统封装方面创建复杂挑战。分区决策影响从机架布局到线缆管理的所有方面,并最终决定scale-up设计是否实用于部署。
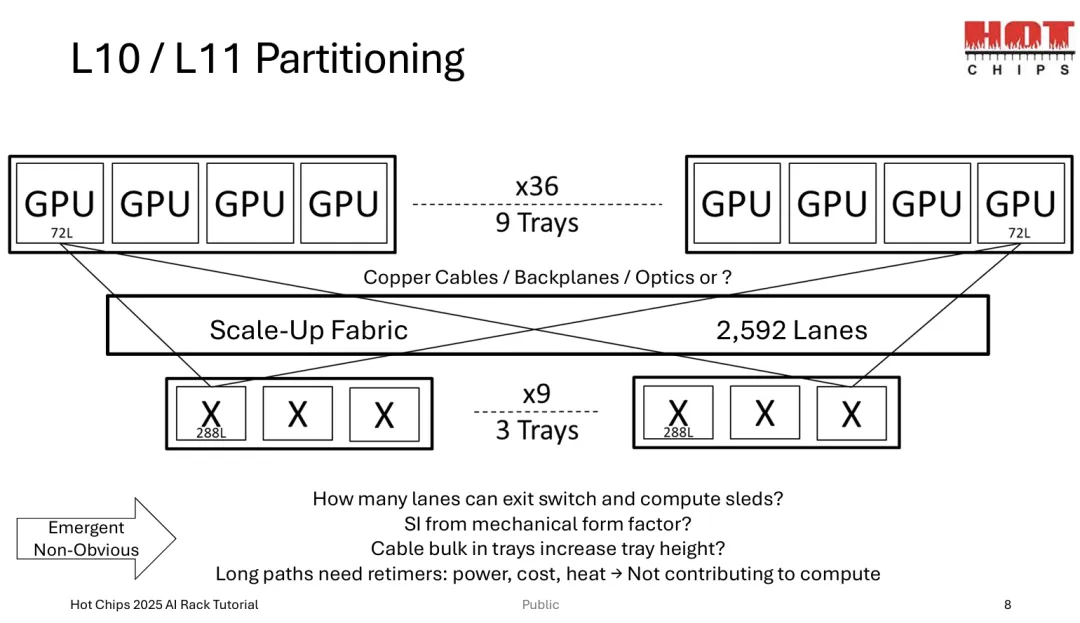
图7:说明scale-up系统中的物理分区挑战,显示GPU和交换机托盘如何在多个托盘中组织,具有数千个连接通道。
Scale-up系统的物理现实涉及在多个托盘和机架上分布2592个通道。每个连接需要物理电缆、连接器和路由路径。图表显示GPU托盘和交换机托盘如何组织以提供必要的连接性,同时适应标准数据中心基础设施。
随着连接数量增加,线缆体积成为重要关注点。每个通道需要物理铜缆或光缆,这些电缆必须通过机架线缆托盘中的有限空间进行路由。数千条电缆的体积实际上可以增加机架的高度要求,影响数据中心布局和冷却。
信号完整性挑战随着距离和连接数量增长。处理器和交换机之间的较长路径可能需要重定时器来维持信号质量,增加成本、功耗和复杂性。这些重定时器不为计算能力做贡献,但对于维持系统功能是必要的。
分区还影响可维护性和可靠性。数千个连接分布在多个机架上,连接故障的概率增加,故障排除变得更复杂。
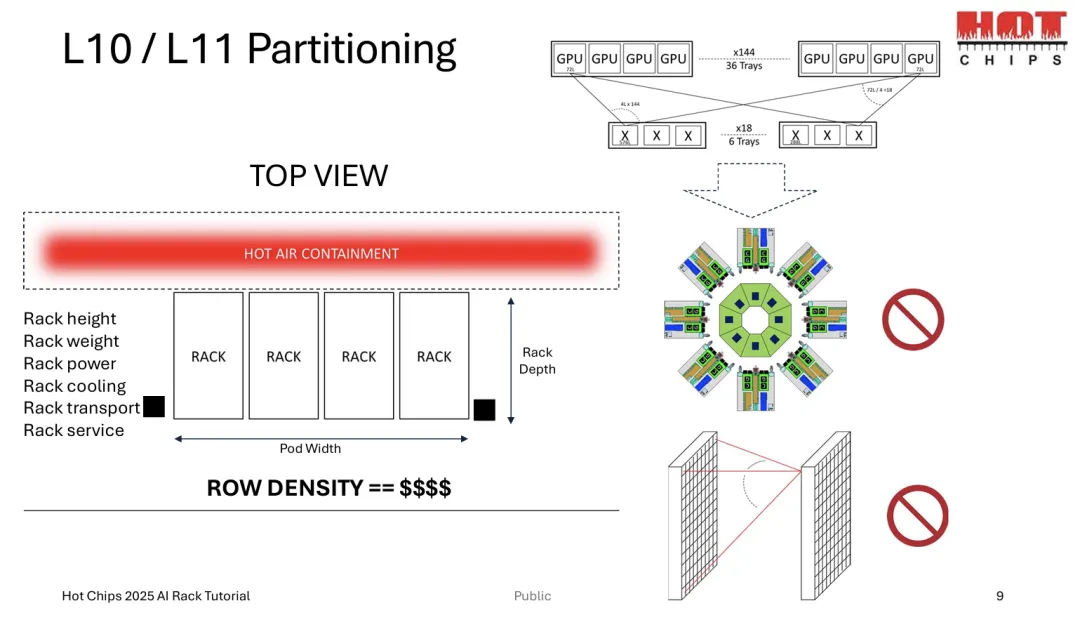
图8:分区挑战的俯视透视图,说明机架组织、机柜宽度考虑以及影响scale-up系统设计的各种物理约束,包括功率、冷却和行密度要求。
俯视透视图揭示了影响scale-up系统设计的额外约束。机柜宽度、机架深度和行间距都限制了系统如何物理组织。在考虑功率分配、冷却容量和服务访问时,计算密度与基础设施要求之间的关系变得明显。
行密度直接影响scale-up系统的经济可行性。数据中心基于地板空间、功耗和冷却要求收费。Scale-up系统必须提供足够的计算优势来证明与替代方法相比的基础设施要求是合理的。
08
更大规模下的Scale-Up Fabric复杂性
从基本配置迁移到更大的scale-up系统揭示了真正的复杂性挑战。当扩展到144个GPU时,fabric复杂性大幅增加,为更大的AI训练系统创建技术和实际挑战。
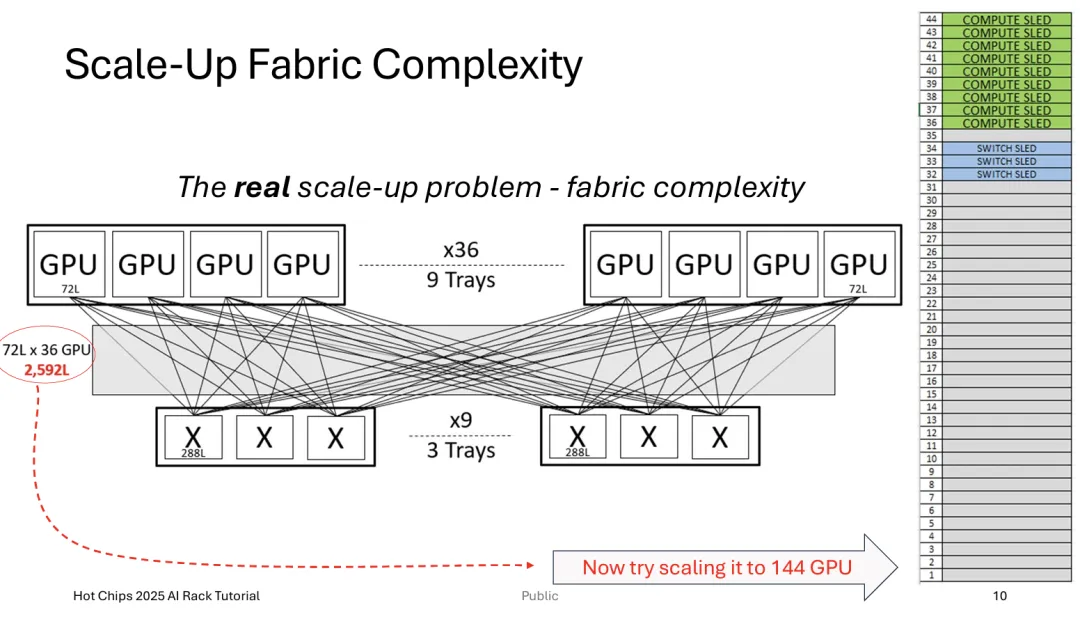
图9:扩展到144个GPU时fabric复杂性的显著增加,显示连接数量如何从2592个通道增长到超过10000个通道,系统复杂性相应增加。
从36到144个GPU的转变说明了复杂性的二次方增长。总通道计数增加到10368个通道,需要交换机、电缆和支撑基础设施数量的显著增加。图表显示相对可管理的36-GPU配置如何爆炸成更复杂的系统。
这种复杂性影响系统设计的每个方面。潜在故障点的数量大幅增加,需要更复杂的监控和管理系统。线缆路由成为影响机械设计和气流模式的三维拼图。
随着系统规模扩大,计算托盘和交换机托盘之间的关系变得更复杂。需要更多交换机,物理组织必须在连接需求与功率分配和冷却容量等实际约束之间进行平衡。
09
使用更高基数交换机扩展到更大域
管理scale-up复杂性的一种方法涉及使用更高基数交换机来减少所需交换元素的总数。这种方法可以简化系统设计的某些方面,同时引入新的挑战。
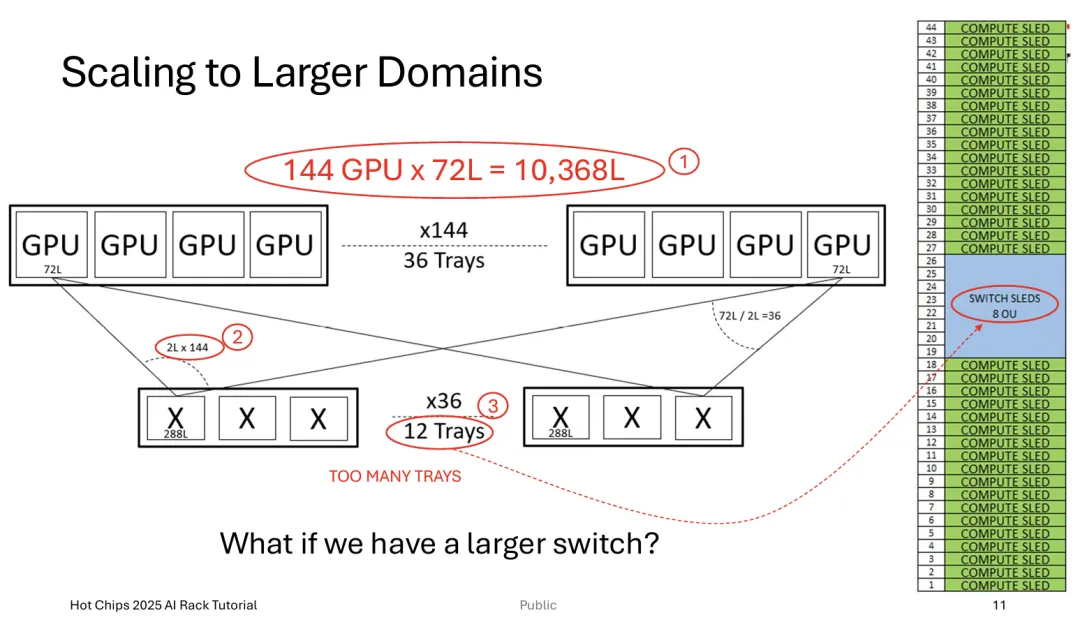
图10:更大的交换机基数如何帮助管理144-GPU系统的复杂性,将交换机托盘数量从12减少到6,尽管这仍然代表系统复杂性的显著增加。
更高基数的交换机将交换元素数量从12个托盘中的36个交换机减少到6个托盘中的18个交换机。这种减少简化了线缆路由并减少了潜在故障点的数量。然而,系统仍然需要比较小配置显著更多的基础设施。
更高基数交换机的优势伴随着权衡。这些交换机更昂贵且在技术上更难实现。同时消耗更多功率并产生更多热量,可能需要额外的冷却基础设施。
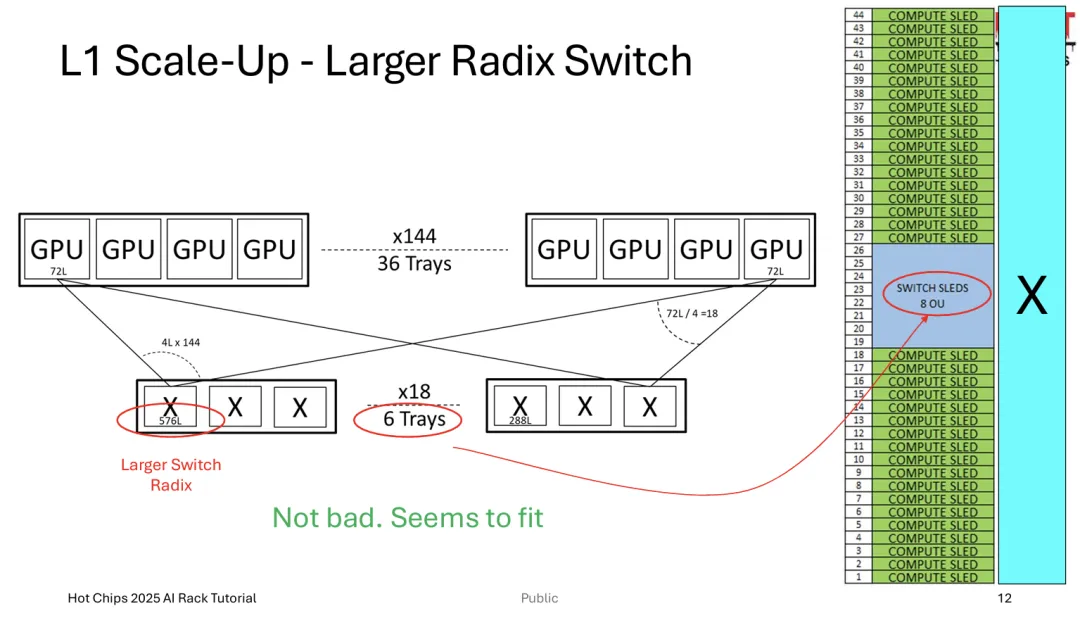
图11:使用更大基数交换机的实际实现,显示减少的交换机数量如何能更合理地适应机架约束,尽管仍然存在显著复杂性。
实际实现显示更大基数的交换机如何使系统更易管理。减少的交换机数量允许fabric适应更合理的机架占用空间,尽管系统仍然需要仔细工程设计来管理数千个连接。
即使有更高基数的交换机,系统仍面临显著的工程挑战。机械设计必须容纳高通道计数,同时在更长距离上保持信号完整性。结果是一个在技术上可行但代表重大工程承诺的系统。
10
Fabric设计复杂性的现实检验
理解大规模fabric系统的真正复杂性需要检查简单连接计数之外的所有工程挑战。实际系统必须解决机械设计、信号完整性、制造、可靠性和运营关注点。
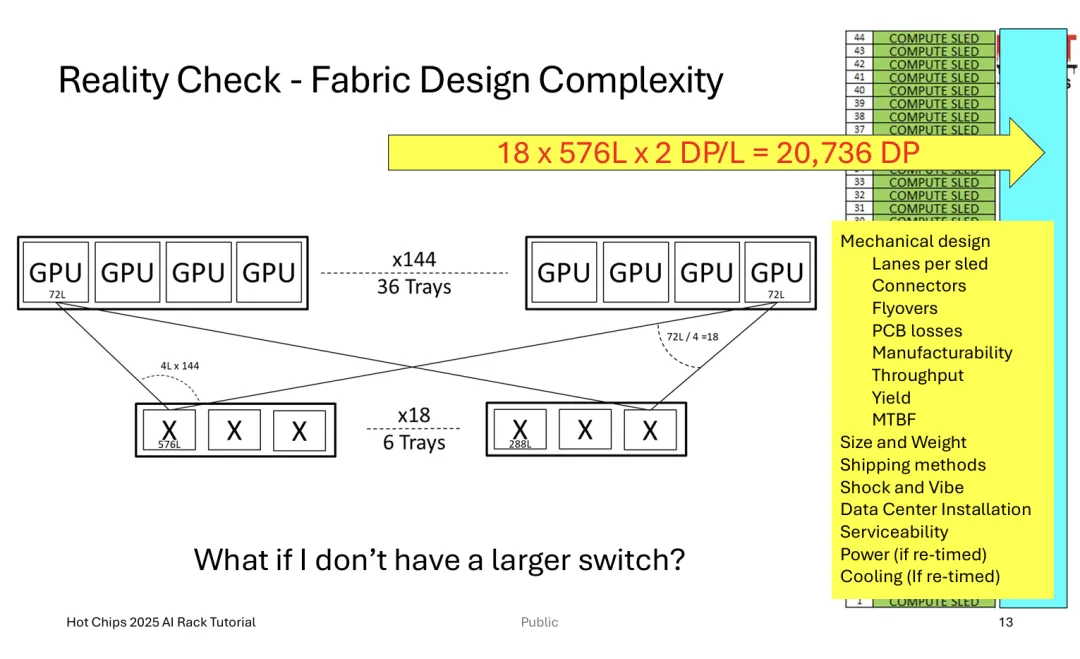
图12:大规模fabric设计中工程挑战的全面视图,突出显示20736个差分对以及必须解决的机械、电气和运营考虑的广泛清单。
18个交换机每个576个通道的现实创建了20736个差分对,必须正确设计、制造和维护。每个差分对需要仔细的阻抗控制、长度匹配和信号完整性管理。机械设计必须容纳连接器放置、线缆路由和热管理。
制造考虑包括复杂组件的良率、数千个连接的测试程序和质量控制流程。系统必须为可制造性而设计,这通常与最优电气或热设计冲突。
运营关注点包括可维护性、诊断和现场更换程序。有数千个连接,系统必须包括全面的监控和诊断能力,以快速识别和隔离故障。
对于大规模系统,运输和安装挑战特别显著。组装的fabric可能太大或太脆弱而无法作为完整单元运输,需要现场组装程序来维持高速信号传输所需的精度。
11
L2 Scale-Up实现的含义
当单层scale-up fabric变得过于复杂或昂贵时,设计师经常考虑添加额外交换层的分层方法。这些L2 scale-up实现在性能和复杂性之间引入新的权衡。
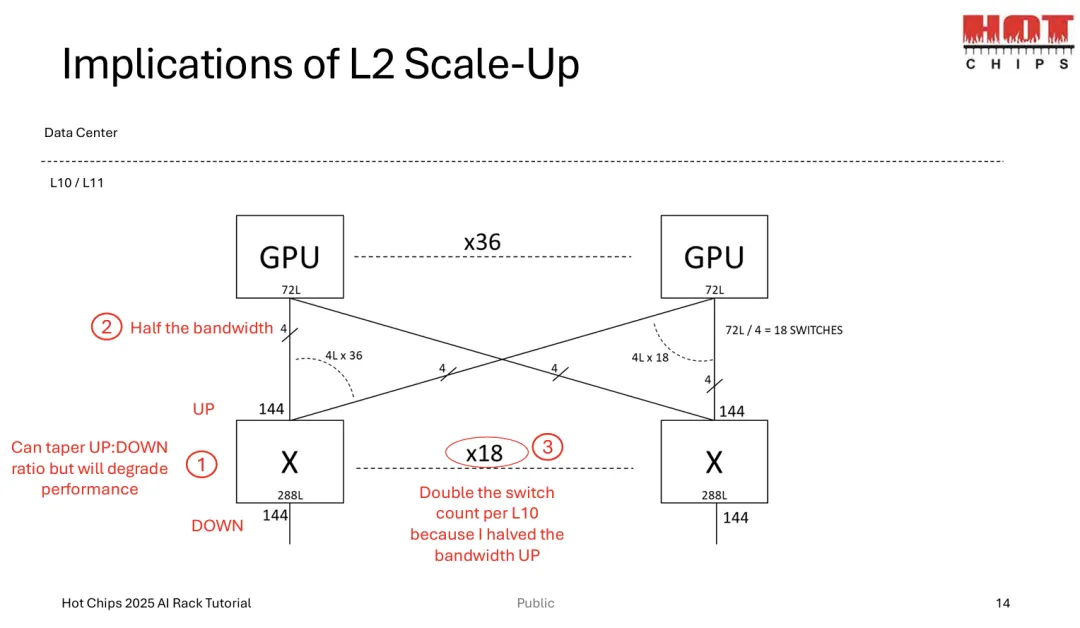
图13:添加第二交换层的含义,显示带宽如何减半而交换机数量增加,可以选择降低上下行带宽比,但会牺牲性能。
L2 scale-up系统通过额外的交换层连接多个L1域。这种方法可以将总处理器计数扩展到单个交换层实际范围之外,但引入带宽和延迟损失。
不同L1域中处理器之间的带宽通常是同一L1域内处理器带宽的一半。这种带宽不对称影响算法性能,需要仔细考虑计算任务如何在系统中分布。
L2系统中交换机数量显著增加。原始L1交换机保留,需要额外的L2交换机来互连L1域。这增加了成本、功耗和复杂性,同时降低了整体系统的性能密度。
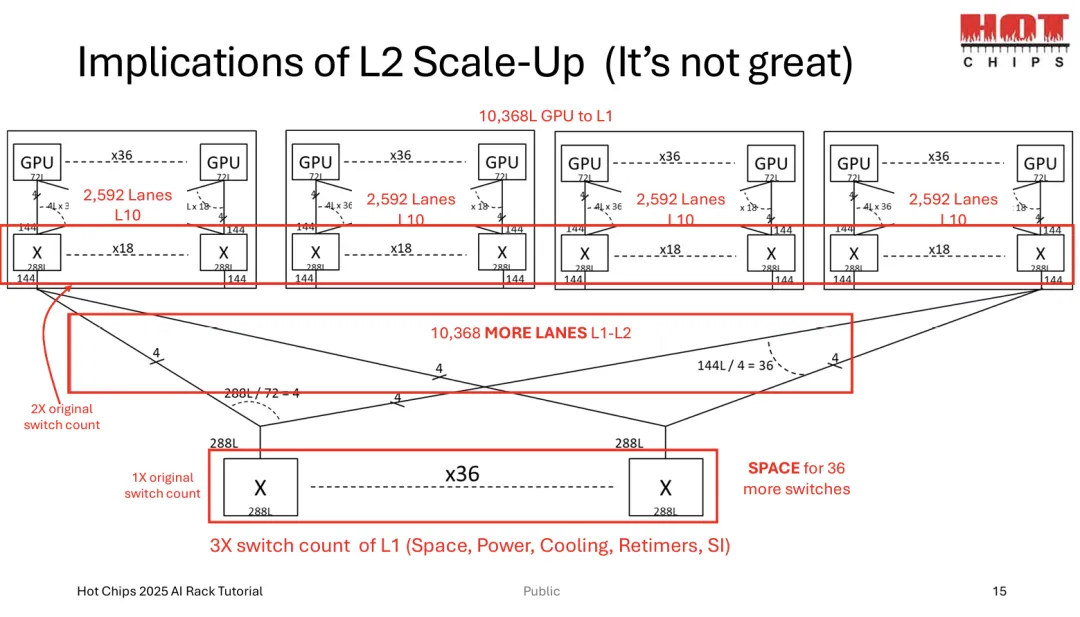
图14:L2 scale-up系统的全部复杂性,显示交换机数量如何比L1系统增加三倍,同时为L1-L2连接添加10368个更多通道,显著增加空间、功率、冷却和信号完整性要求。
完整的L2系统需要原始L1系统三倍的交换机数量。L1-L2连接的额外10368个通道必须添加到现有L1连接中,创建总计超过20000个通道的系统。
空间要求大幅增加,需要交换机和线缆路由的额外机架空间。功率和冷却要求随着增加的组件数量扩展,可能需要升级数据中心基础设施。
L2系统中信号完整性挑战复合。额外的交换层引入额外的延迟和潜在信号退化点。L1和L2交换机之间的较长线缆运行可能需要重定时器,进一步增加功耗和复杂性。
12
替代拓扑方法
鉴于传统分层扩展的挑战,已开发替代拓扑来提供性能和复杂性之间更好的权衡。L1.5拓扑代表一种试图找到中间地带的方法。
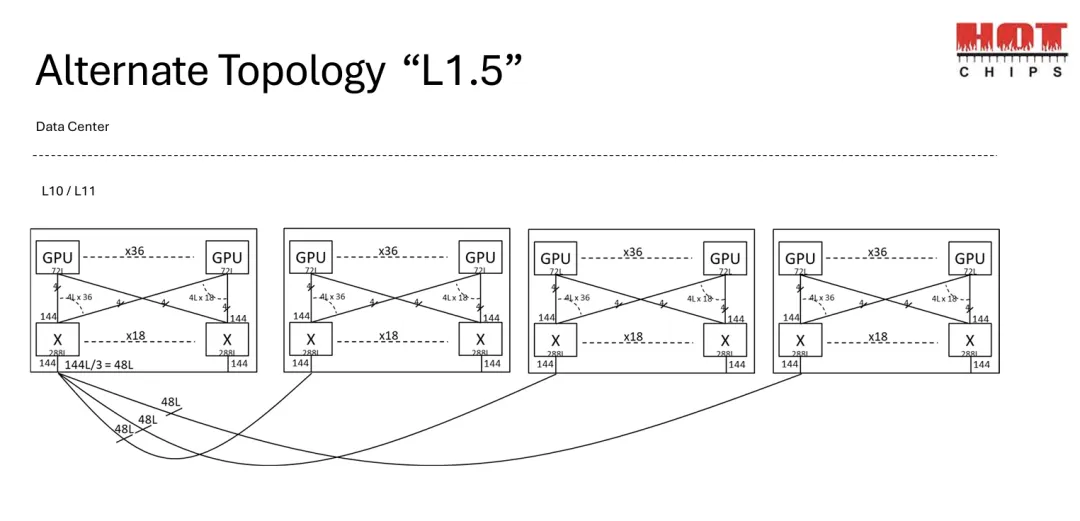
图15:L1.5拓扑作为替代方法呈现,创建较小域的mesh,在L1系统性能和L2实现的扩展性挑战之间提供妥协。
L1.5拓扑创建L1域的mesh,每个域连接到多个其他域。这种方法避免了L2系统的严格层次结构,同时提供比纯L1方法更多的扩展性。
在此配置中,每个域内的处理器保持完整的L1性能,而域之间的连接提供减少但仍然实质性的带宽。Mesh结构在任意两个处理器之间提供多个路径,改善可靠性和负载分布。
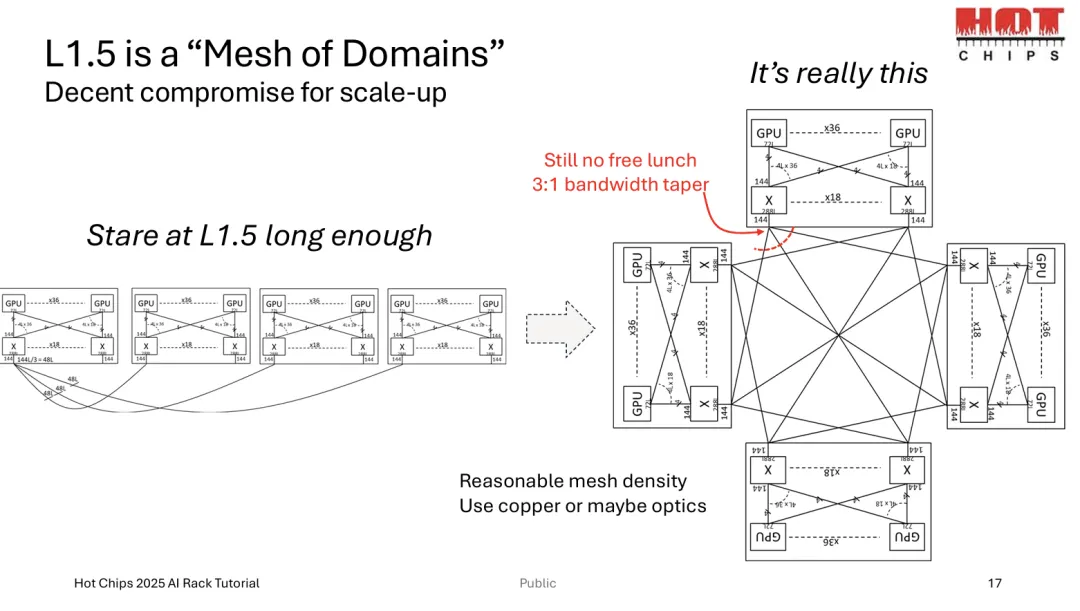
图16:L1.5拓扑如何作为域的mesh功能,显示可以使用铜缆或光连接的合理mesh密度,尽管仍涉及3:1带宽锥形并代表妥协解决方案。
L1.5的详细分析显示如何代表scale-up系统的实用妥协。Mesh密度对于当前技术的实现是合理的,无论是使用铜缆还是光连接。域内和域间连接之间的3:1带宽锥形为许多AI训练工作负载提供可接受的性能。
然而,L1.5不是完美解决方案。带宽不对称仍然影响性能,mesh连接与简单L1系统相比增加了复杂性。该方法需要仔细的算法设计来利用带宽特性。
13
Scale-Up通道信号完整性考虑
Scale-up通道的电气特性从根本上限制了这些系统的可实现性能和规模。理解信号完整性要求有助于解释为什么scale-up系统面临固有的扩展限制。
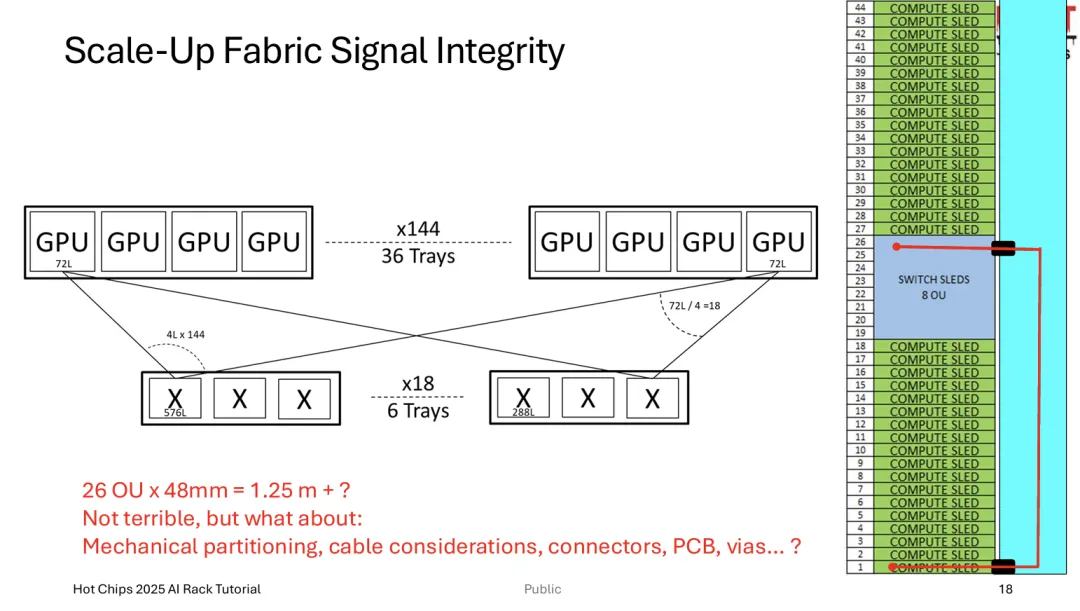
图17:说明scale-up fabric中的信号完整性挑战,显示跨越26个机架单元1.25米的物理距离,并质疑机械分区、线缆管理和信号完整性的实际限制。
跨越26个机架单元1.25米的物理距离对高速数字信号代表显著的信号完整性挑战。这个距离必须通过多个连接器、线缆段和可能的重定时器来穿越以保持信号质量。
虽然1.25米对于信号完整性似乎是可管理的,但完整通道包括的不仅仅是简单距离。PCB路由、过孔转换、连接器接口和线缆特性都对信号退化有贡献。
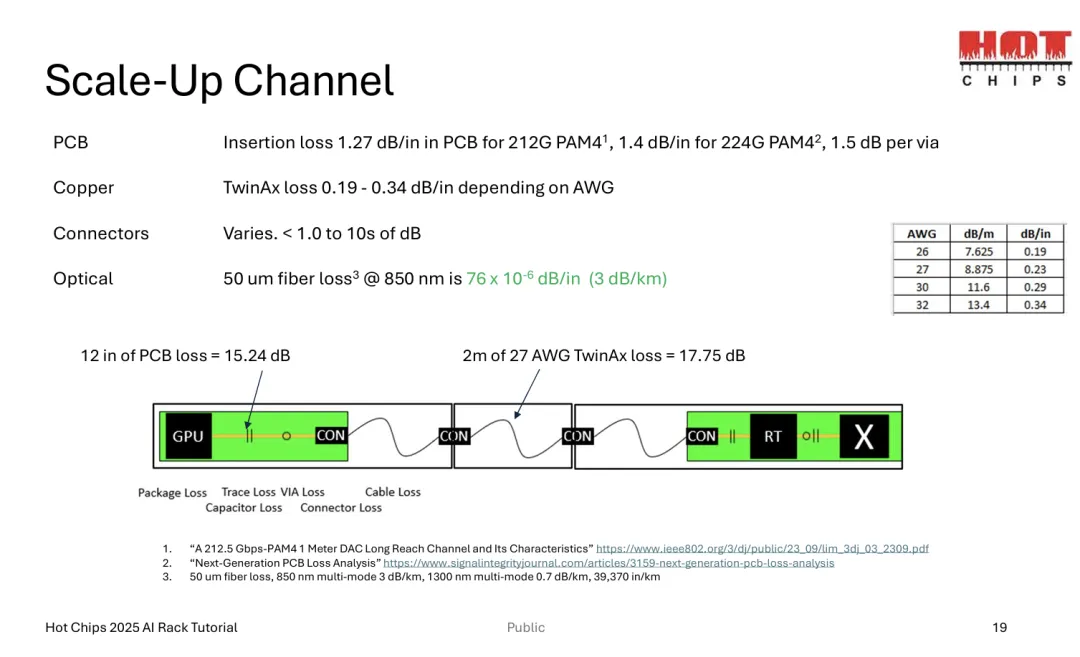
图18:提供scale-up通道中信号损失的详细分解,比较PCB插入损失、铜缆损失、连接器损失和光纤损失,演示为什么长铜通道需要重定时器。
详细的损失分析揭示为什么scale-up通道实现具有挑战性。212G PAM4信号的PCB插入损失为每英寸1.27 dB,结合连接器损失和线缆损失,快速累积到需要信号再生的水平。
示例显示12英寸PCB创建15.24 dB损失,而2米27 AWG铜缆添加17.75 dB。结合连接器损失,总通道损失超过大多数收发器在无重定时情况下的能力。
光连接在每英寸76 × 10⁻⁶ dB处提供显著更低的损失,但需要昂贵的光收发器和额外功耗。铜缆配重定时器和光连接之间的选择涉及成本、功率和复杂性之间的复杂权衡。
14
Scale-Up的光互连挑战
虽然光互连为scale-up系统提供理论优势,但实际实现揭示了限制其当前对大规模系统适用性的显著挑战。
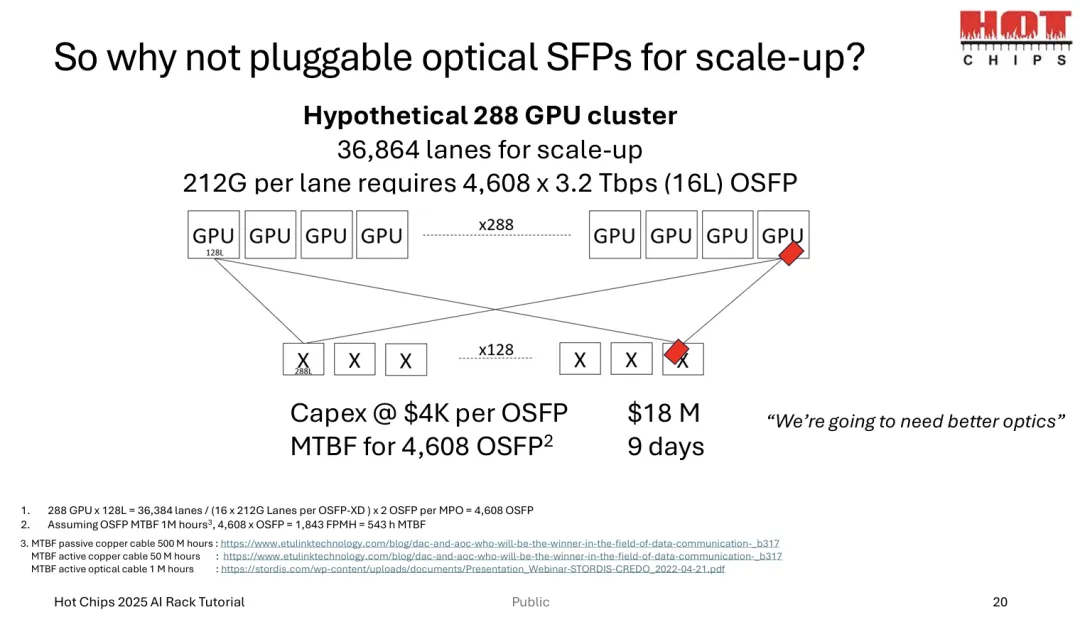
图19:将光互连用于scale-up系统的实际挑战,显示假设的288 GPU集群将需要4608个OSFP模块,成本1800万美元,MTBF仅9天。
288 GPU集群的分析揭示了光学挑战的规模。有36864个需要光连接的通道,系统将需要4608个OSFP光模块。按每个OSFP 4000美元的当前价格,仅光互连成本就达到1800万美元。
可靠性成为比成本更严重的关注点。假设每个OSFP模块100万小时的MTBF,系统MTBF下降到仅9天。这意味着系统每隔几天就会经历光模块故障,需要持续维护并可能影响训练作业完成。
这些数字说明为什么当前光学技术对大规模scale-up系统不实用。在光互连对最大AI训练系统可行之前,成本和可靠性特性必须大幅改善。
"我们需要更好的光学器件"的结论抓住了行业挑战。光学技术提供大规模系统所需的理论性能,但实际实现需要在成本降低和可靠性改善方面取得显著进展。
15
未来方向和结论
Scale-up fabric技术代表最大AI训练系统的关键使能器,但面临限制其实际扩展的基本挑战。理解这些限制有助于解释当前系统设计,并指出需要技术进步的领域。
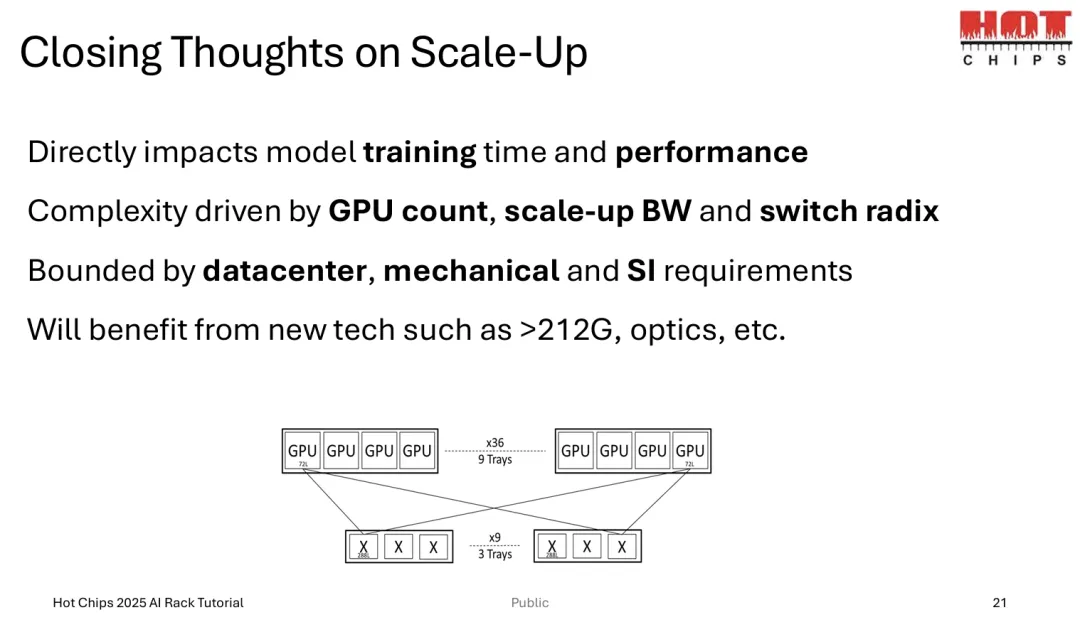
图20:影响scale-up fabric设计的关键因素,强调对模型训练性能的直接影响以及约束实际实现的各种限制。
对模型训练时间和性能的直接影响使scale-up fabric对竞争性AI开发必不可少。然而,由GPU数量、scale-up带宽需求和交换机基数驱动的复杂性对系统大小和成本创建实际限制。
数据中心、机械和信号完整性要求施加无法通过软件或算法改进解决的基本物理约束。这些约束解释为什么当前系统通常在特定规模处达到平台期,以及为什么需要突破性技术来进一步扩展。
技术的未来改进,包括超过212G的更高速度信号传输、改进的光互连和新的交换架构,对于AI训练系统的持续扩展将是必需的。行业需要跨多个技术领域的协调进展来实现下一代scale-up系统。
本文演示scale-up fabric设计涉及性能、成本、复杂性和可靠性之间的复杂权衡。成功需要理解这些权衡,并基于特定应用要求和技术约束做出明智决策。随着AI模型大小继续增长,scale-up fabric技术将继续是训练系统设计中的关键限制因素。
参考文献
[1] D. Vallis, "Scaling Fabric Technologies for AI Clusters," presented at Hot Chips 2025 AI Rack Tutorial, 2025.
END
 微信公众号
 bilibili
 微信视频号