


引言
人工智能革命创造了计算资源需求的巨大增长,从根本上改变了数据中心网络的设计思路。Google已经率先实现了被称为"第五代"分布式计算的网络技术,这些创新可能要到2028年才会在主流市场普及。要理解这一转变的意义,需要深入分析我们是如何走到这个关键节点,以及Google开发的创新解决方案。
分布式计算时代的演进历程
通向今日AI网络挑战的道路始于摩尔定律的根本局限性。虽然晶体管数量每两年翻一番,每年提供大约40%的性能改进,但当单台机器无法处理Web 2.0时代的大规模工作负载时,这种扩展最终遇到了瓶颈。解决方案是跨数百或数千个节点的分布式计算集群,网络真正成为了计算机。
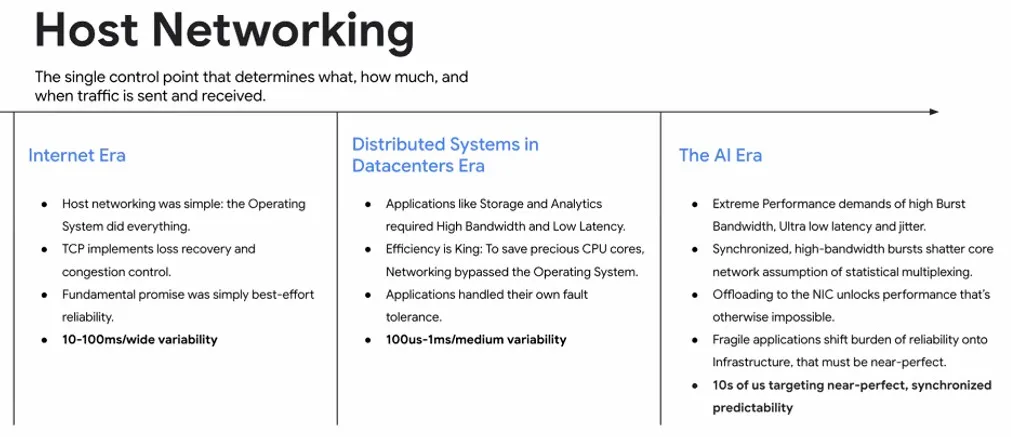
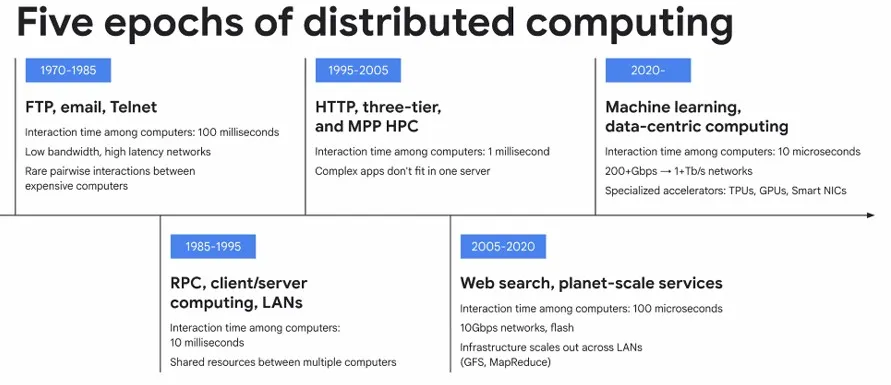
Google基础设施和AI副总裁兼总经理Amin Vahdat概述了分布式计算的五个不同时代。每个时代都大幅降低了计算机之间的交互时间,从早期FTP和电子邮件时代的100毫秒降至今天机器学习环境中的仅10微秒。这种进步既创造了机遇也带来了挑战,因为更强大的计算和存储能力在推动网络发展的同时也创造了日益复杂的瓶颈。
当前的AI时代带来了特别严峻的挑战。虽然之前的时期在二十年间实现了稳定增长,但生成式AI的兴起创造了几乎无限的需求,计算需求年增长率达到10倍。即使通过更大芯片和降低数值精度实现2倍到3倍的性能改进,剩余的缺口也必须通过扩展分布式系统中的端点数量来填补。这一现实解释了为什么AI公司正在构建拥有10万到20万个端点的集群,并计划建设百万节点系统。
AI工作负载的独特特征
现代AI训练带来了与以往任何情况都不同的网络挑战。这些工作负载既可预测又极其苛刻,需要在运行单一应用程序的数万台服务器之间进行同步通信。与传统计算中统计复用帮助管理可变负载不同,AI训练涉及紧密同步的计算阶段,随后是密集的全对全通信期。
AI模型训练期间的流量模式揭示了核心挑战。虽然带宽使用在30秒间隔内看起来平滑,在5秒间隔内呈现中等变化,但检查100毫秒窗口时会发现剧烈波动。加速器经常在等待数据时处于空闲状态,然后突然以最大速率吸收信息。这种可预测但突发的行为打破了指导几十年设计决策的基本网络假设。
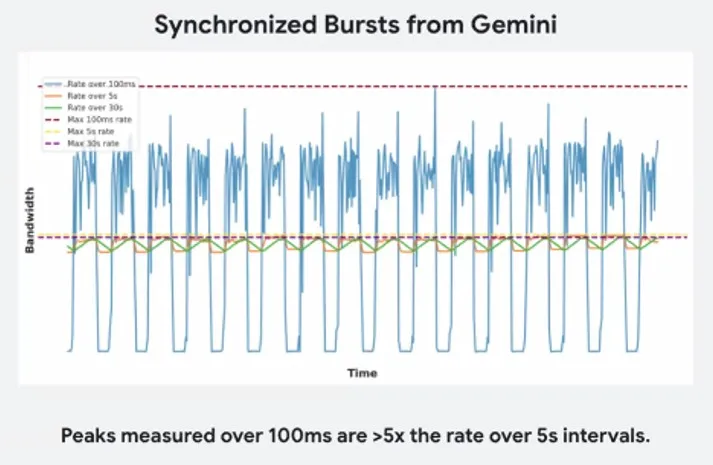
AI工作负载需要在毫秒粒度上同步的周期性线速突发,可持续数十秒。同时对延迟敏感且带宽密集,最坏情况延迟直接决定整体性能而不仅仅是影响性能。任何系统崩溃都会停止整个作业,使超可靠基础设施必不可少。这些要求迫使Google从根本上重新思考网络设计。
Google突破性的Firefly网络时钟系统
Google第五代网络的基石是Firefly,这是一个超精确时钟同步系统,将在SIGCOMM 2025会议上详细介绍。这项技术建立在Google在数据中心使用原子钟的经验基础上,可以追溯到2010年左右测试Spanner全球分布式数据库的时期。
Firefly创建了跨整个数据中心的亚10纳秒时钟同步fabric。驱动这一创新的洞察非常深刻:通过可预测的网络负载,所有数据流的完美调度可以在拥塞发生之前消除拥塞。这将网络从反应式、尽力而为的数据包传输转变为主动、完美调度的通信。
系统在不到10纳秒内同步网络接口卡,并能在不到1毫秒内将NIC与通用时间时钟对齐。这种精度能够在几十纳秒内调度AI集体操作,远快于高端以太网交换机中数据在端口间跳转所需的数百纳秒。通过对每次数据传输进行计时和调度,网络变得确定性和可靠,而不是随机延迟的来源。
Swift拥塞控制和高级流量管理
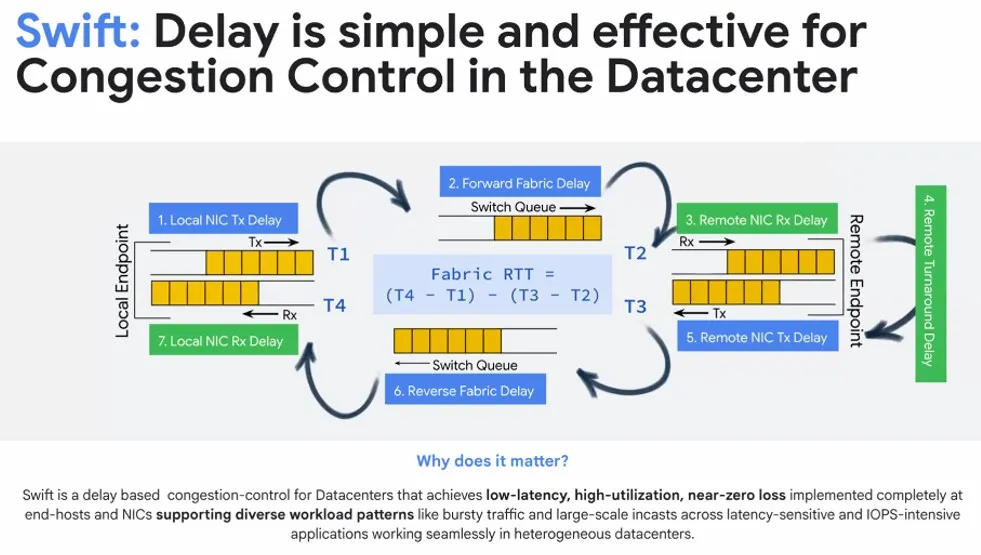
Google的Swift拥塞控制系统在SIGCOMM 2020上公布,通过管理即使在复杂调度下也不可避免的拥塞来补充Firefly。Swift在网络接口卡和主机服务器上运行,维护整个网络中队列的细粒度信息,并调整数据发送速率以维持目标低级队列。
这种方法允许以太网网络处理AI和高性能计算工作负载典型的突发流量模式。Swift以低延迟在高网络利用率下传输数据,同时保持接近零的数据包丢失。系统本质上在必要时告诉以太网"等一下",这是传统以太网协议不愿意做的事情。
Falcon传输协议和Mount Evans的硬件创新
Google第五代网络的硬件基础集中在与Intel联合开发的专用数据处理单元中实现的Falcon传输协议。Mount Evans E2100代表了这一硬件的第一代,配备16个Arm Neoverse N1核心、48 GB内存和两个100 Gb/秒端口。
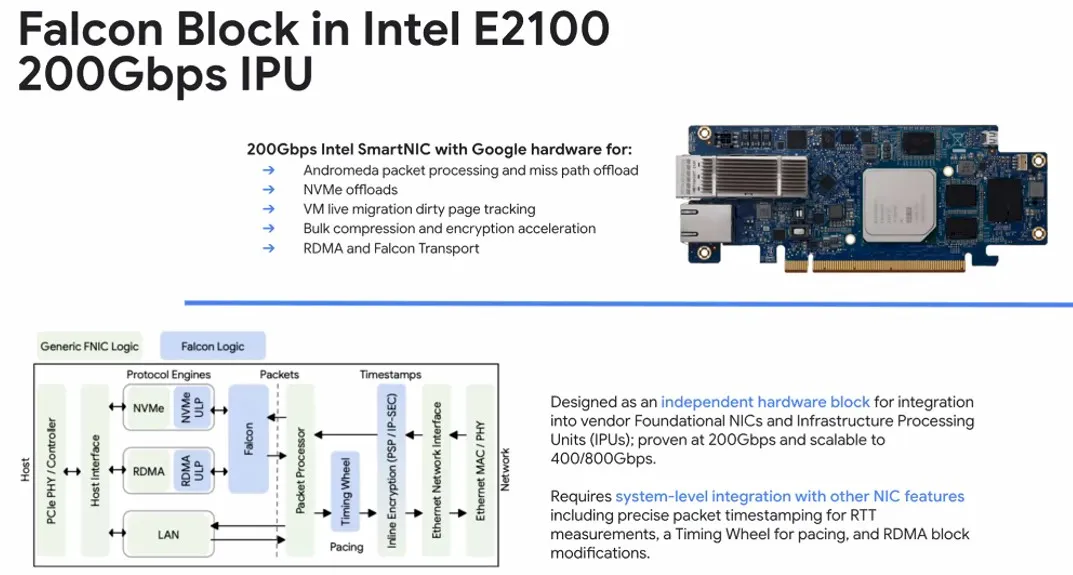
Falcon相较于前几代实现了显著的性能改进,提供了比Google早期Pony Express传输10倍的每秒操作数,同时尾部延迟降低了十分之一。Google版本包括专门用于Andromeda网络虚拟化栈的硬件、定制RDMA实现,以及支持VM实时迁移、闪存虚拟化和数据加密的线路。
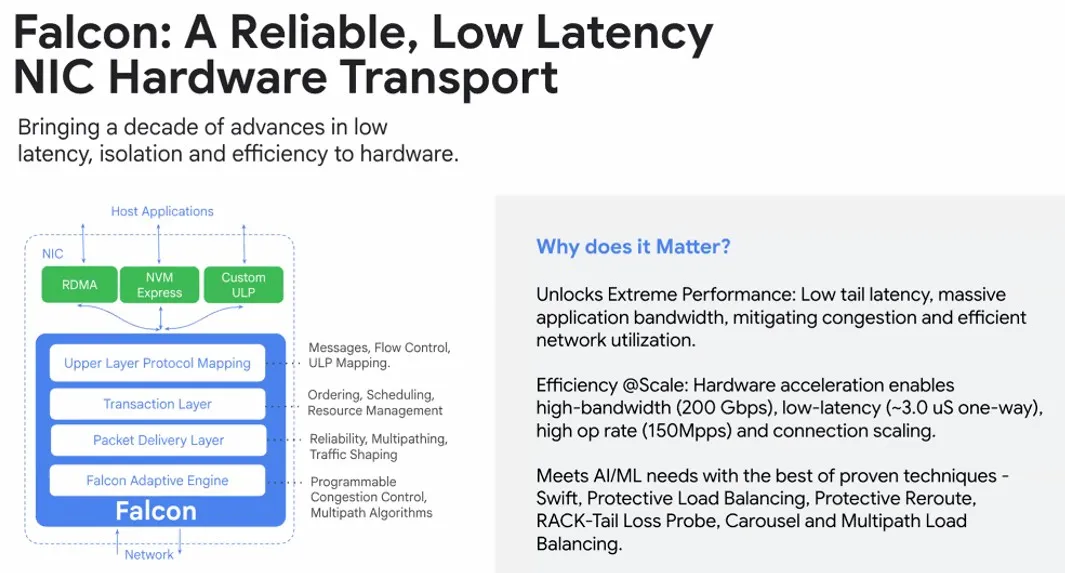
性能优势是显著的。虽然Falcon在较低队列对数量时与Nvidia的ConnectX-7延迟相匹配,但随着负载增加保持一致性能。当ConnectX-7在大约3000到4000队列对时经历接近3倍的延迟峰值时,Mount Evans设备保持稳定的性能水平。
智能故障检测和系统弹性
Google高级网络系统的最后一个组件是Straggler Detection,这是一个用于识别和隔离大规模集群中硬故障和软故障的自动化系统。在AI工作负载中,当一个节点故障或性能不佳时,整个训练运行可能停止或慢到无法使用的程度,使快速故障检测变得关键。
传统的集群问题调试可能需要专家工程师数天的手工工作。Google系统通过创建所有网络设备的实时通信图将此减少到几分钟的自动化分析。当问题发生时,系统识别受影响的组件并向上游追踪以自动找到根本原因。
这种能力代表了管理大规模AI基础设施的根本转变,其中数万个节点中的单个慢速节点就可能严重影响性能。系统快速隔离问题和维持集群健康的能力直接影响全球每年部署的数千亿美元GPU系统的利用率。
面向未来的网络架构设计
Google第五代网络技术展示了AI工作负载如何推动数据中心设计的根本变化。这些创新解决了同步、可预测但苛刻工作负载的独特挑战,这些工作负载将定义下一代计算基础设施。通过Firefly的精确时钟同步、Swift的智能拥塞控制、Falcon的硬件加速传输和Straggler Detection的自动故障处理,Google构建了一个能够满足AI时代极端性能要求的网络系统。
这些技术的整合创造了一个从根本上不同的网络模型,其中预测性和确定性取代了传统的尽力而为方法。随着AI工作负载继续增长和演进,这种网络架构方法可能成为支持下一代人工智能系统的标准。虽然这些技术目前主要在Google内部使用,但预计在未来几年内会逐渐向更广泛的市场开放,为整个行业的AI基础设施发展提供指导。
参考来源
[1] T. P. Morgan, "Google Is Already Using The Future AI Network You Might Get In 2028," The Next Platform, Aug. 21, 2025. [Online]. Available: https://www.nextplatform.com/2025/08/21/google-is-already-using-the-future-ai-network-you-might-get-in-2028/. [Accessed Aug. 23, 2025].
END
 微信公众号
 bilibili
 微信视频号