


引言
Google最新发布的Ironwood张量处理单元(TPU)代表了人工智能计算基础设施的重要进展。这款先进处理器在保持卓越能效的同时实现了突出的性能指标,为训练和服务下一代AI模型奠定了坚实的技术基础[1]。

02
性能突破与计算能力
Ironwood TPU系统通过几项关键创新实现了卓越的计算性能。系统核心采用9,216颗Ironwood芯片,通过光线路交换机实现内存共享,构建了Google称为"共享内存超级节点"的架构。这种架构使系统能够实现42.5 exaflops的机器学习计算能力,使用FP8精度,相比之前的TPU代数实现了3,600倍的性能提升。
系统的内存架构设计令人印象深刻,具备1.77 PB的直接可寻址共享高带宽内存(HBM)容量。这个庞大的共享内存池能够在整个系统范围内实现低开销、高带宽的数据共享,加速细粒度并行处理并支持更高程度的并行度,从而获得优异的性能总拥有成本比。
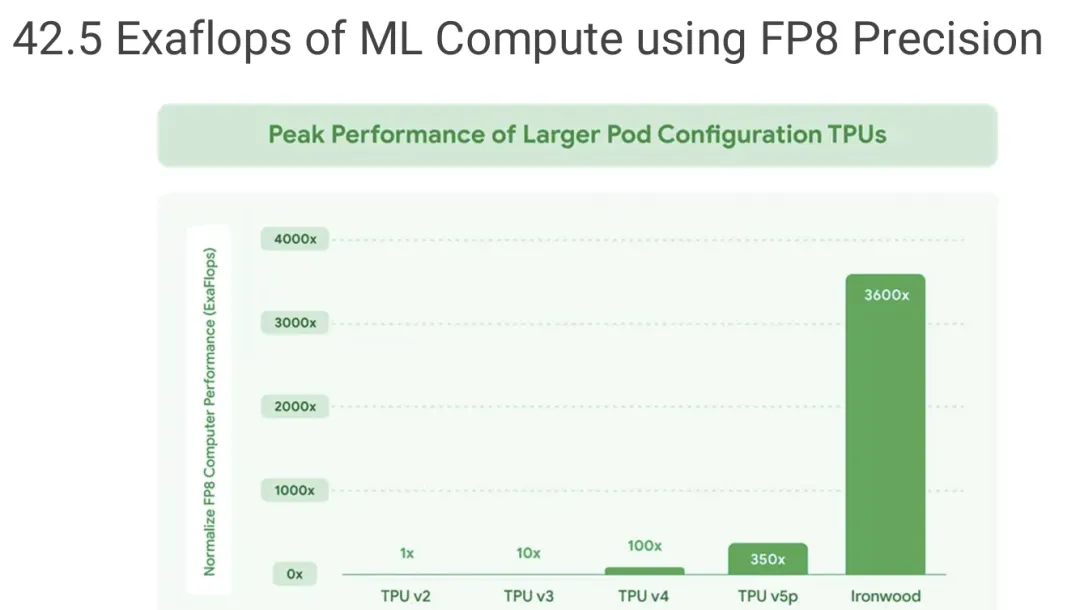
图1:跨TPU代数的机器学习计算性能对比图表,显示Ironwood相比基准TPU v2实现了3,600倍的性能提升
03
光线路交换创新技术
Ironwood架构的突破性特点在于使用光线路交换机连接机架并在数千颗芯片间实现内存共享。不同等级的光线路交换机连接不同的维度和索引,创建了灵活的互连拓扑,允许芯片池中的任意块组装成不同大小和形状的计算切片。

图2:详细图表展示TPUv4的4,096颗芯片如何使用光线路交换机共享内存,说明了构建块池和特定切片大小作业配置
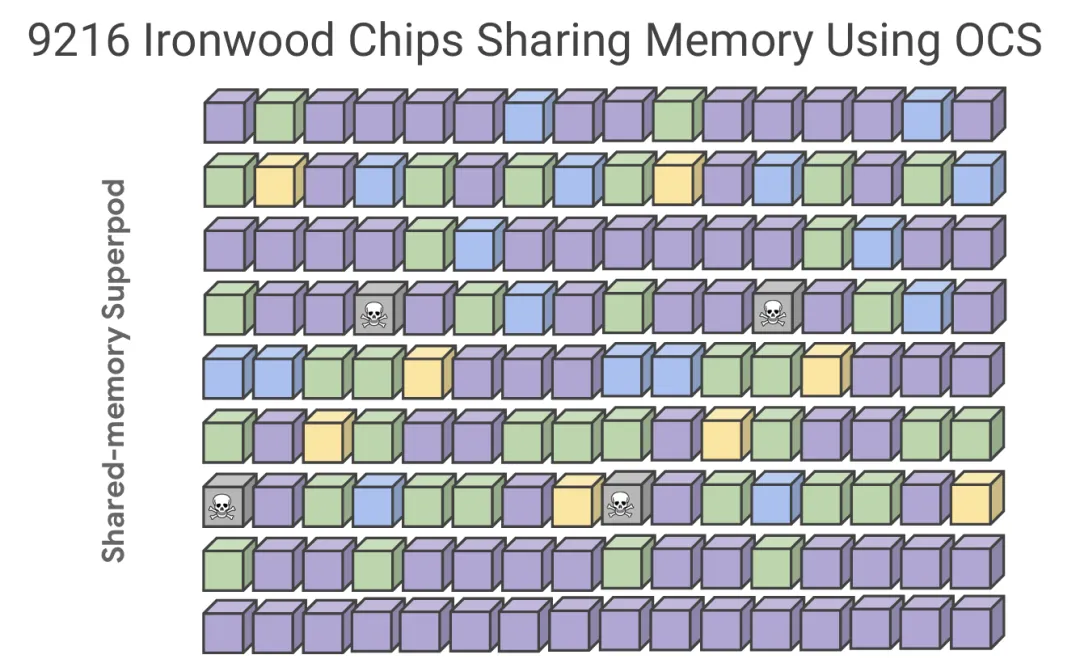
图3:共享内存超级节点的扩展视图,显示9,216颗Ironwood芯片使用光线路交换机在综合网格布局中共享内存
这种创新的互连设计提供了几个重要优势。故障节点的影响范围很小,意味着硬件故障不会显著影响整体系统运行。资源可以按作业分配,可以创建任何切片大小或形状,仅受总池大小限制。这种灵活性对于高效运行具有不同计算需求的多样化AI工作负载非常重要。
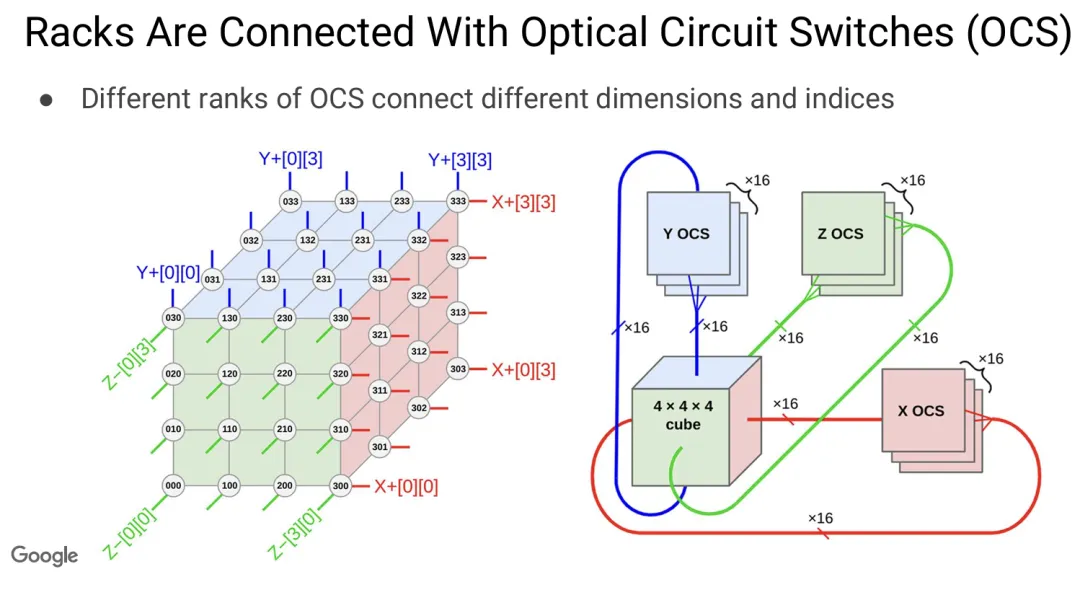
图4:技术图表说明机架如何通过光线路交换机连接,显示不同OCS等级连接的不同维度和索引,包括X、Y、Z光线路交换机配置
04
芯片架构与设计
每颗Ironwood芯片都代表了半导体工程的精湛技艺。作为Google首颗双计算die TPU,每颗芯片提供4,614 teraflops的FP8性能,计算能力比TPU v5p提升超过十倍。芯片集成了8层HBM3E内存,峰值带宽达7.3 TB/s,容量为192 GiB,专门针对服务最新一代思维模型进行了优化。

图5:Ironwood芯片详细规格概览,展示双计算die设计、HBM3E内存配置和关键技术规格
芯片架构包括多个协调工作的专用组件。TensorCore提供高性能向量和矩阵计算,而第四代SparseCore处理嵌入和集合卸载操作。芯片具备1.2 TB/s的输入/输出能力,支持无瓶颈地扩展到9,216颗芯片。

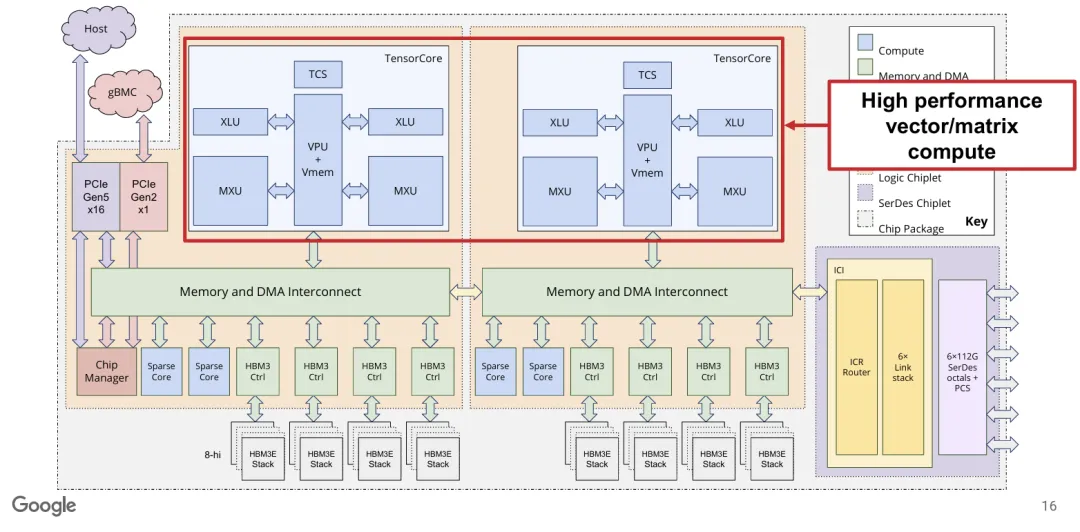
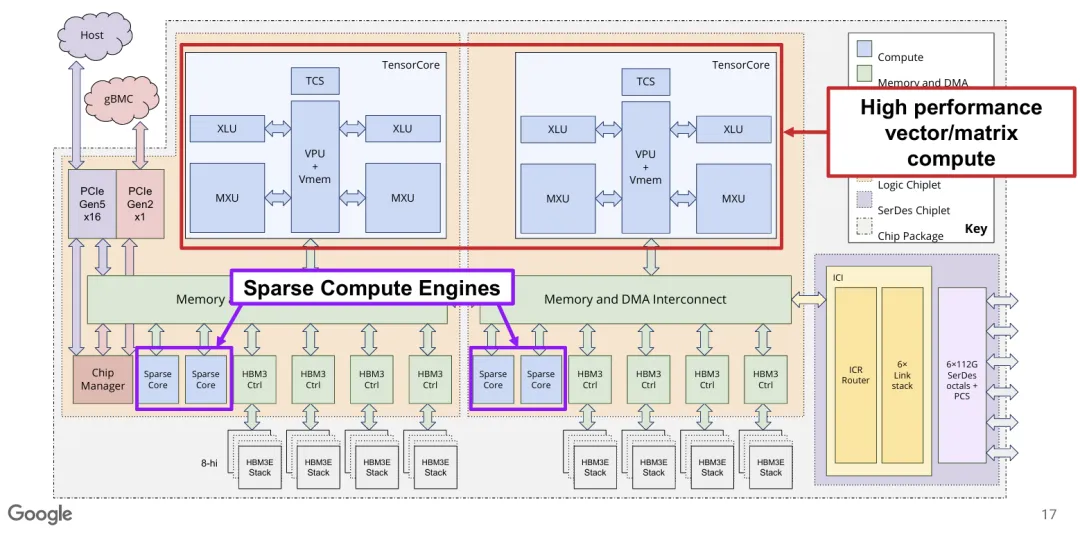
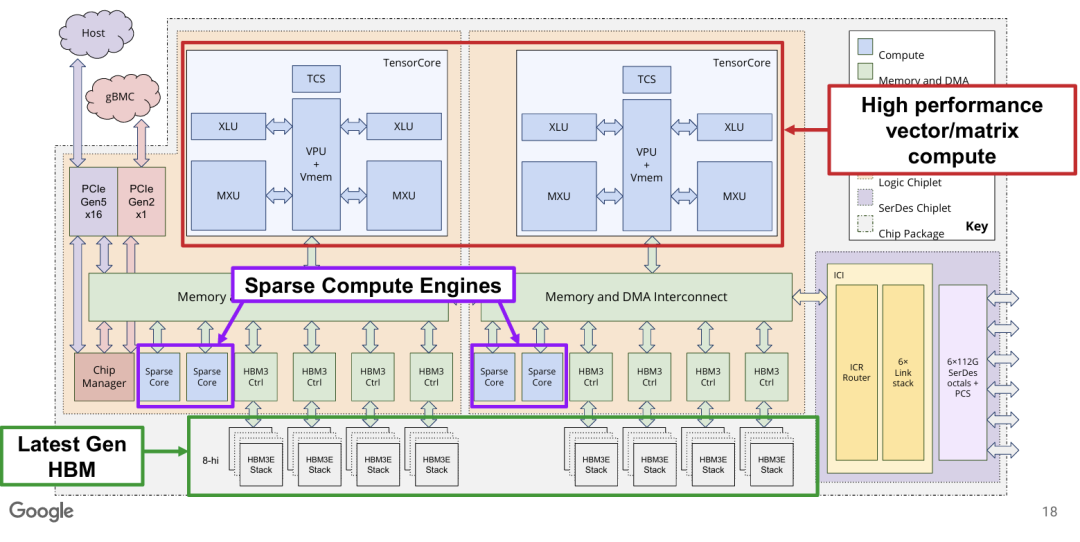
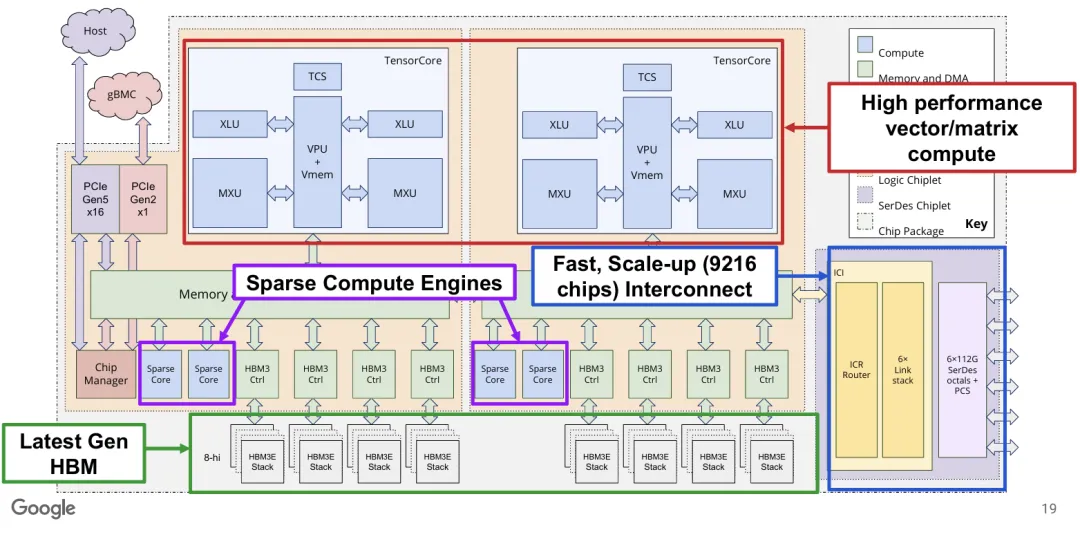
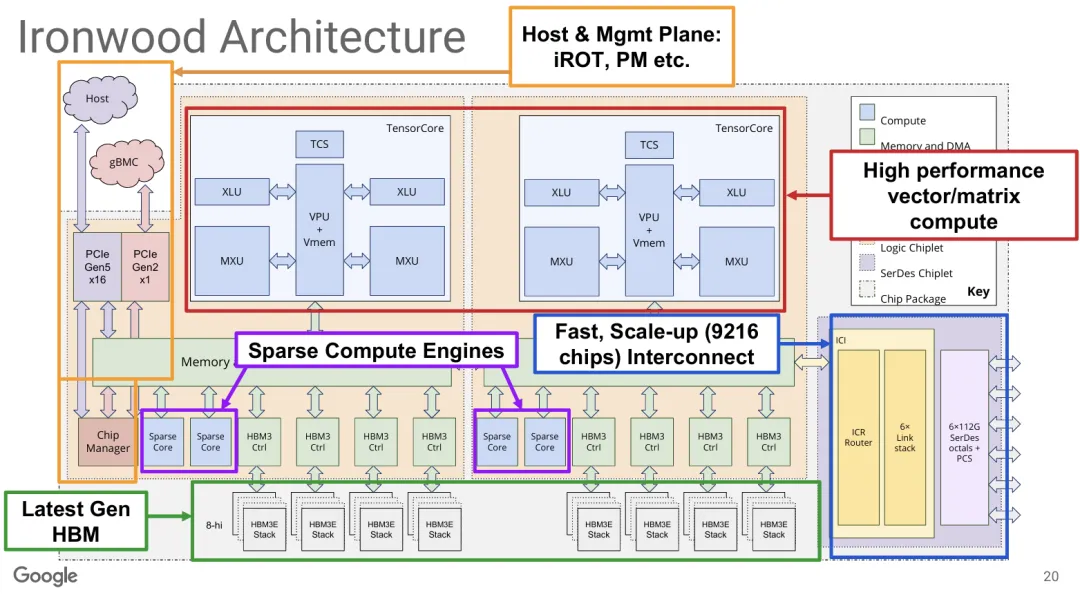
图6:全面的架构图表展示Ironwood芯片内部结构,突出显示计算元素、内存子系统、互连基础设施和管理组件
05
能效优化与热管理
Ironwood实现了行业领先的计算功耗效率,达到29.3 teraflops/瓦特,相比上一代产品功耗性能比提升约两倍。这种卓越的能效对于大规模部署环境至关重要,因为功耗直接影响运营成本和环境可持续性。
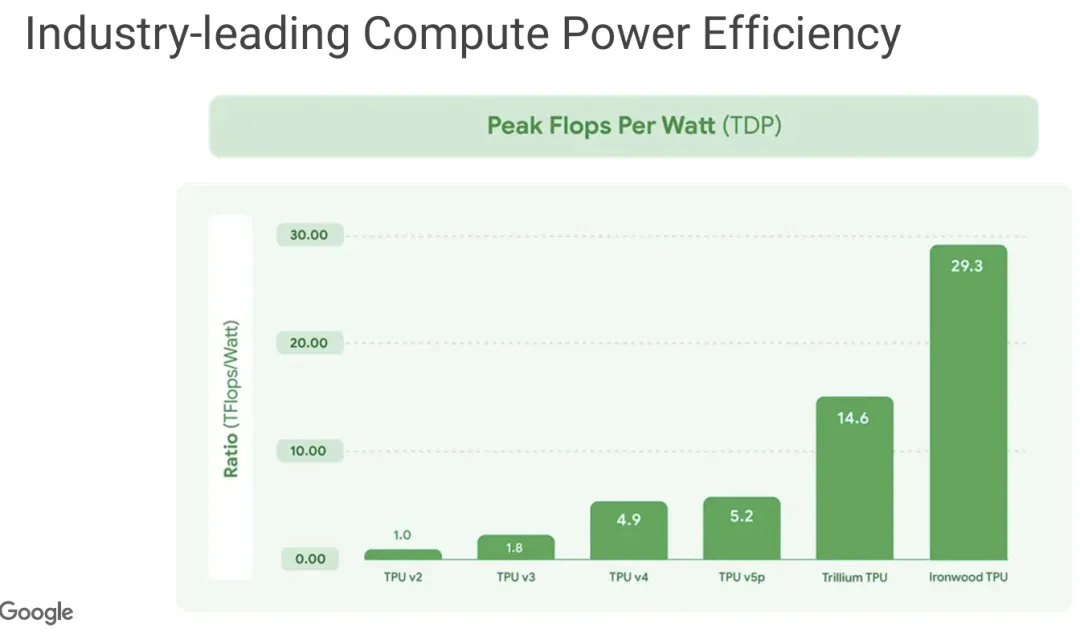
图7:不同TPU代数的功耗效率对比图表,显示峰值flops/瓦特,Ironwood达到29.3 TFlops/瓦特,相比之前代数有显著提升
系统采用了经过完善的第三代液体冷却基础设施,通过八年的生产经验和超过1吉瓦的实际环境部署得到了不断改进。液体冷却系统使用受控流量,类似于空气冷却中的可变风扇速度,为高密度计算环境提供更高效的热管理。
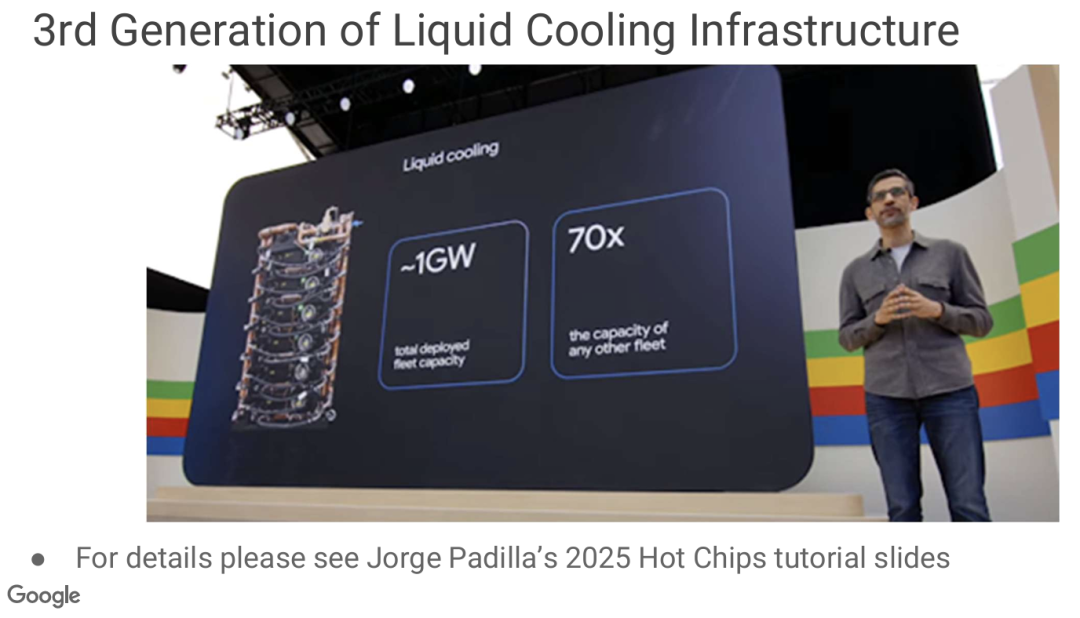
图8:展示第三代液体冷却基础设施的演示幻灯片,包含技术规格,包括1吉瓦总部署容量和70倍容量改进
06
系统集成与部署
Ironwood的物理实现展示了Google在大规模系统集成方面的专业能力。每个托盘包含四颗Ironwood TPU,采用液体冷却系统为芯片和电压调节器提供并行水流冷却。流量通过阀门控制,类似于空气冷却的可变风扇速度,实现更高效的水冷性能。
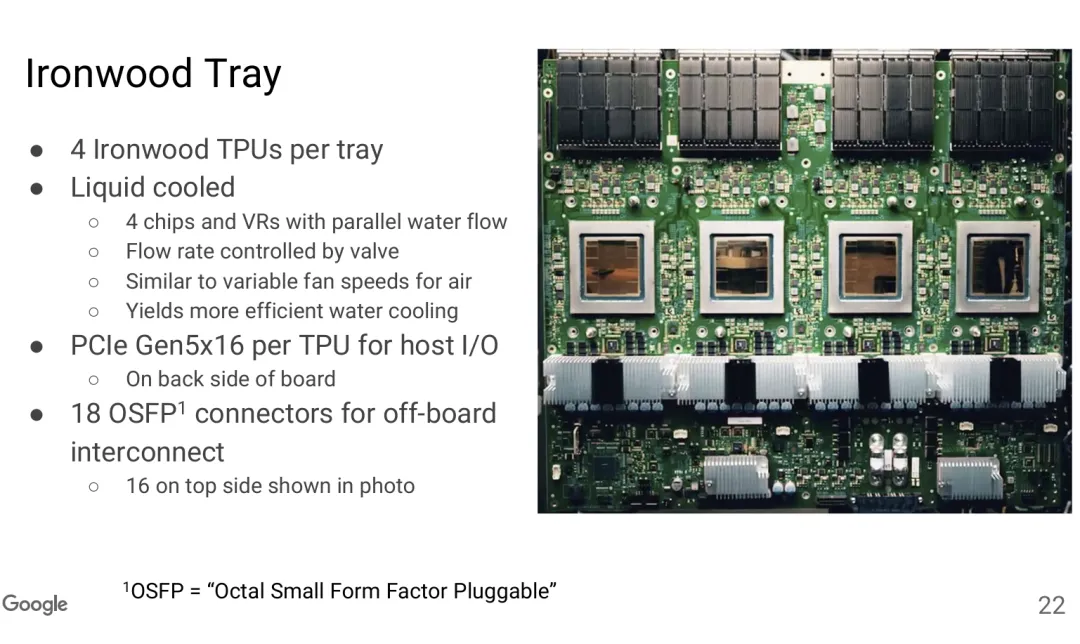
图9:Ironwood托盘详细照片和规格,显示四颗TPU芯片、液体冷却系统、PCIe连接和用于板外互连的OSFP连接器
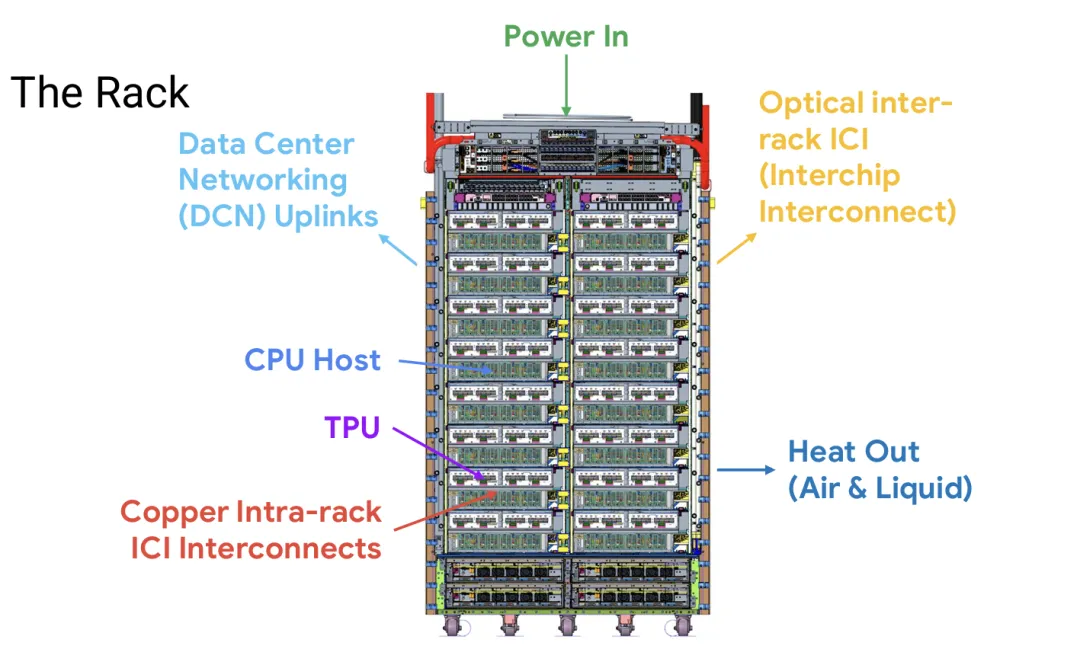
图10:完整机架架构图表,显示电力输入、数据中心网络上行链路、光学机架间互连、铜质机架内互连,以及空气和液体冷却的热量输出管理
完整系统包括从单个芯片到整个数据中心的全面功耗管理能力。Google的方法目标是在相同功耗预算内实现每个数据中心30%的额外吞吐量,通过智能功耗感知和控制系统在遵守功耗约束的同时优化性能。
07
RAS特性与可靠性
Ironwood系统高度重视可靠性、可用性和可维护性(RAS)特性,这对于支持极大规模的生产性扩展至关重要。系统集成了根信任(iROT)控制器,提供硬件级安全启动支持和安全测试调试功能。此外,Ironwood还增加了对PCIe数据对象交换(DOE)和组件测量与认证(CMA)的硬件支持。
芯片设计包含功能内建自测试(BIST)和静默数据损坏(SDC)缓解机制,以及用于提高良率的逻辑修复功能。动态电压/频率调节确保高效的性能功耗比,而基于AI的ALU线路和布局优化进一步提升了整体效率。
08
第四代SparseCore技术
第四代SparseCore相比第三代实现了2.4倍的FLOPS提升,专门用于加速嵌入处理和集合运算卸载。这些专用计算单元可以与主要TensorCore计算并行执行预训练和基于强化学习的微调中的集合操作,同时处理大型推荐模型的嵌入处理任务。

图11:第四代SparseCore详细架构图,展示tile结构、处理单元配置和与主计算核心的协作机制
SparseCore利用节点间的非一致性共享内存,通过多线程技术实现大规模内存并行性,在节点间支持数百万个未完成的内存引用操作,充分发挥了分布式内存架构的优势。
09
功耗管理与优化
大规模预训练工作负载会产生MW级别的功耗波动,这种波动可能在秒级或毫秒级时间内发生。Ironwood支持硬件和软件特性来平滑这些功耗波动,部署了全栈主动功耗整形方法,Google将此项目称为"Project Smoothie"。
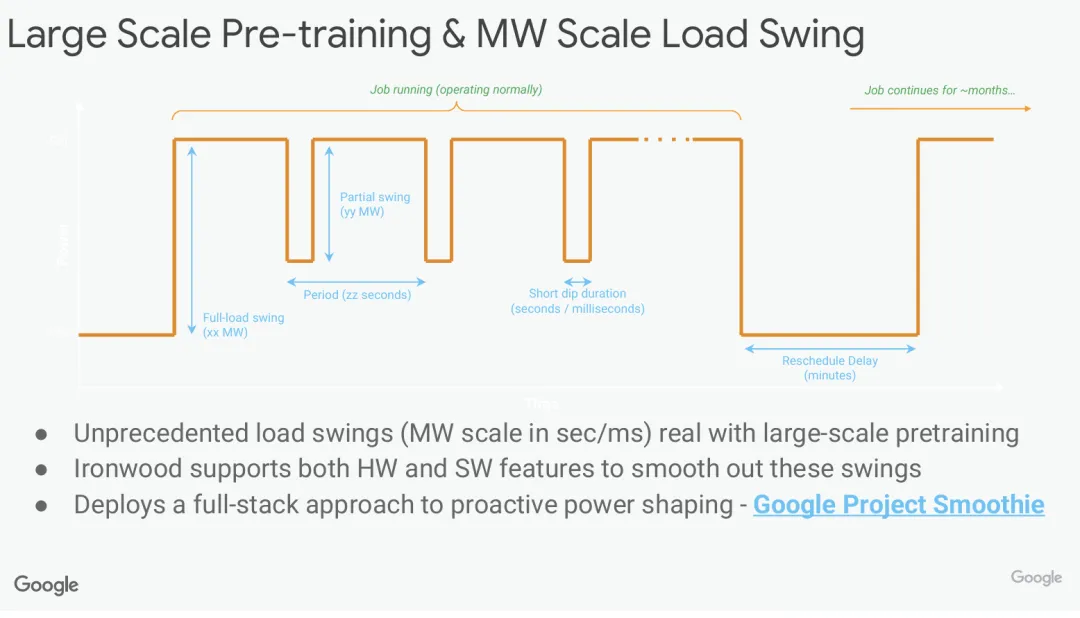
图12:大规模预训练和MW级负载波动功耗图表,显示功耗波动模式、重新调度延迟和系统响应特性
这种综合功耗管理方法包括芯片/系统/机架级功耗管理能力和数据中心功耗感知控制,目标是在数据中心功耗容量范围内实现最优性能功耗比。
10
部署现状与应用
Ironwood系统目前正在进行超大规模部署,代表了Google在AI计算基础设施领域的最新成果。系统专门优化用于训练和服务最新一代思维模型,其大容量HBM3E内存配置特别适合处理需要大量内存带宽的复杂推理任务。
系统的光学互连技术和共享内存架构为运行超大规模AI模型提供了必要的基础设施支持,而其出色的能效表现使得在实际生产环境中经济高效地运行这些计算密集型工作负载成为现实。
Ironwood TPU通过在光学互连、先进芯片架构和精密热管理方面的创新,为训练和服务日益复杂的AI模型提供了计算基础,同时保持了经济可行性。随着人工智能技术的持续发展,像Ironwood这样的系统为支持下一代AI应用和研究提供了必要的计算基础。
参考文献
[1] N. P. Jouppi and S. Lakshmanamurthy, "Ironwood: Delivering Best in Class perf, perf/TCO and perf/Watt for Reasoning Model Training and Serving," presented at Hot Chips, Aug. 26, 2025.
END
 微信公众号
 bilibili
 微信视频号