


01
AI数据中心网络面临的挑战
现代人工智能系统需要极大的计算能力,因此产生了包含数千个专用处理器的大规模AI集群。这些AI数据中心在各组件之间的通信方式上面临基础性挑战。当我们分析这些系统的架构时,发现有两种关键的网络类型使AI处理器能够有效协作[1]。
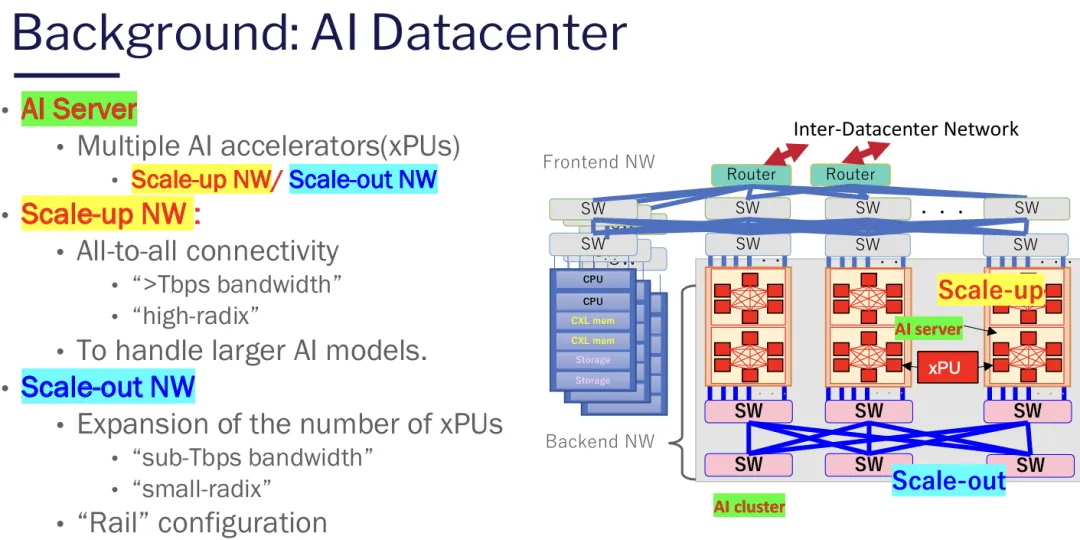
图1:AI数据中心的层次结构,显示了scale-up和scale-out网络、后端和前端网络,以及AI服务器与传统基础设施之间的关系。
AI服务器包含多个AI加速器,通常称为xPU,必须通过复杂的网络系统相互连接。scale-up网络在单个服务器或小型集群内的处理器之间提供全对全连接,需要以太字节每秒计量的巨大带宽和高基数连接来处理最大的AI模型。同时,scale-out网络通过连接多个AI服务器来扩展处理能力,运行在相对较低的带宽需求下,但仍需要亚太字节速度,并采用"轨道"配置来实现高效的数据分发。
02
不断增长的网络容量挑战
AI系统的网络需求正在经历爆炸性增长,造成重大的技术和经济挑战。目前的预测表明,到2030年将需要PB级的交换容量,相比今天的系统增长了一千倍。AI模型规模和复杂性的不断增加推动了网络能力的大幅扩展,需要处理元件之间更复杂的通信模式。
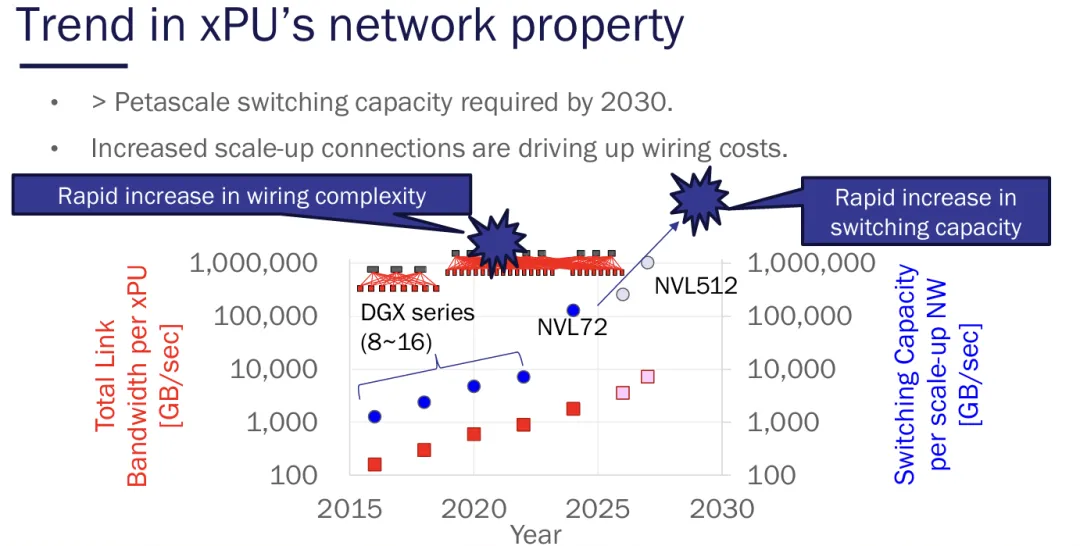
图2:双轴图表展示了从2015年到2030年每个xPU带宽和总交换容量的快速增长,突出了AI系统网络需求的指数级增长。
网络需求的指数级增长产生两个主要问题。首先,scale-up网络内所需的交换容量以不可持续的速度增长,像NVIDIA的NVL72和预计的NVL512架构这样的系统需要大量的互连带宽。其次,连接这些高带宽线路的复杂性正成为一个重要的成本因素,因为每个额外连接都需要昂贵的光收发器、电缆和交换基础设施。
03
功耗:网络增长的隐藏成本
传统以太网交换技术在网络容量向上扩展时面临严重的功耗挑战。目前的高容量交换机可能消耗数百千瓦的功率,且这种消耗随交换容量急剧增长。交换容量与功耗之间遵循指数曲线关系,使传统方法对于未来AI集群需求不可持续。
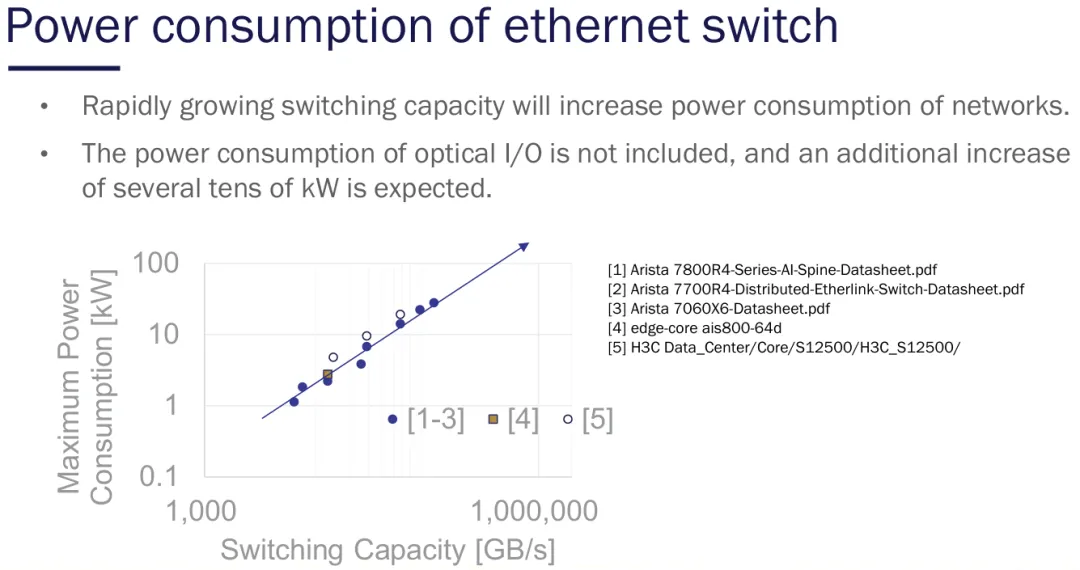
图3:该对数图表显示了各种以太网交换机的交换容量与最大功耗之间的关系,展示了功率需求的指数级增长。
当考虑到光输入/输出组件会为总系统功率预算增加数十千瓦时,功耗危机变得更加严重。这些对于长距离高速数据传输必需的光收发器,占总网络功耗的很大一部分,显著增加了大型AI装置的运营成本。
04
光学线路交换:新的解决方案
光学线路交换(OCS)技术为高带宽网络提供了根本不同的方法,同时解决了AI集群面临的功耗和可扩展性挑战。与需要对每个数据包进行复杂电子处理的传统分组交换不同,光学线路交换在通信器件之间创建直接的光路径,允许光信号以最小损耗通过,几乎不消耗额外功率。
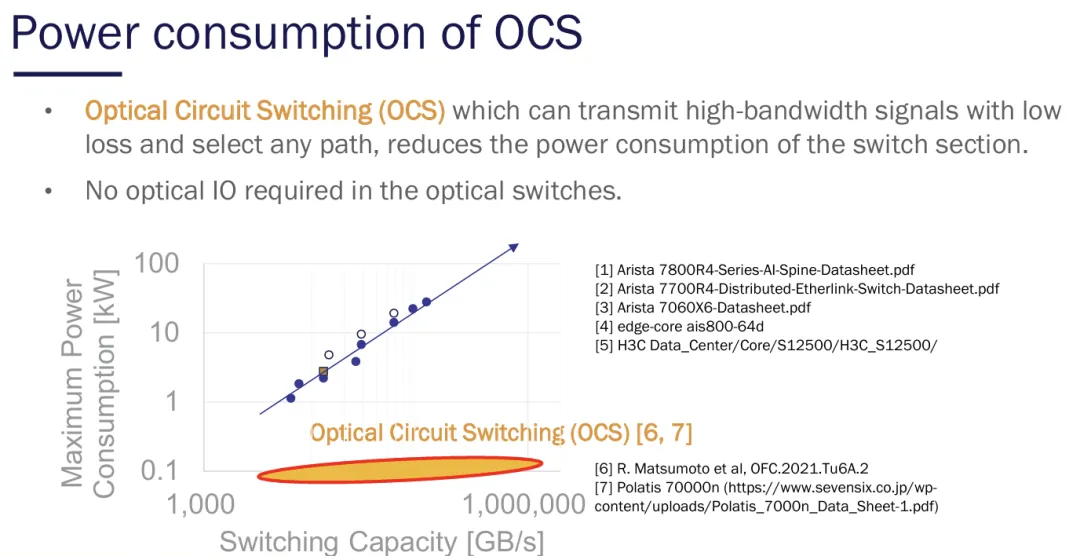
图4:光学线路交换相比传统以太网交换机的显著功率效率优势,显示了OCS即使在高交换容量下也能保持低功耗。
OCS的关键优势在于能够以极低的插入损耗传输高带宽信号,同时提供动态选择任何通信路径的灵活性。最重要的是,光交换机本身不需要光输入/输出转换,消除了传统网络设备中功耗的主要来源之一。这种根本差异使OCS系统能够扩展到更大容量,同时保持合理的功耗水平。
05
行业采用和当前实现
主要技术公司已经认识到光学线路交换在AI应用中的潜力。谷歌、NVIDIA、Lightelligence和Lightmatter等公司已经开始在系统中实现各种形式的OCS技术,尽管采用不同的方法和应用。
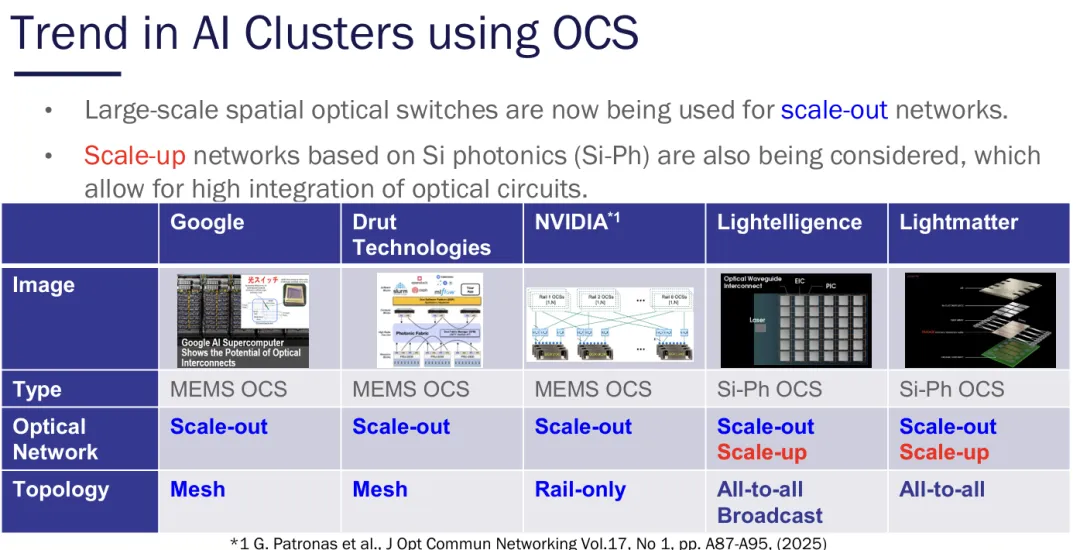
图5:不同技术公司如何实现OCS技术,比较了MEMS OCS和硅基光电子OCS方法在各种网络拓扑和应用中的表现。
目前的实现主要专注于使用基于MEMS(微机电系统)的光交换机的scale-out网络,为连接不同服务器或数据中心部分提供卓越性能。然而,下一代实现正在转向基于硅基光电子(Si-Ph)的OCS系统,这种系统具有更高集成密度的潜力,可以同时满足scale-up和scale-out网络需求。
06
先进的OCS技术和未来发展
光学线路交换的未来在于先进的硅基光电子实现,能够提供高密度光交换能力的板级集成。这些系统能够在数十个处理单元之间实现直接光连接,同时保持低功耗并提供复杂AI工作负载所需的灵活性。
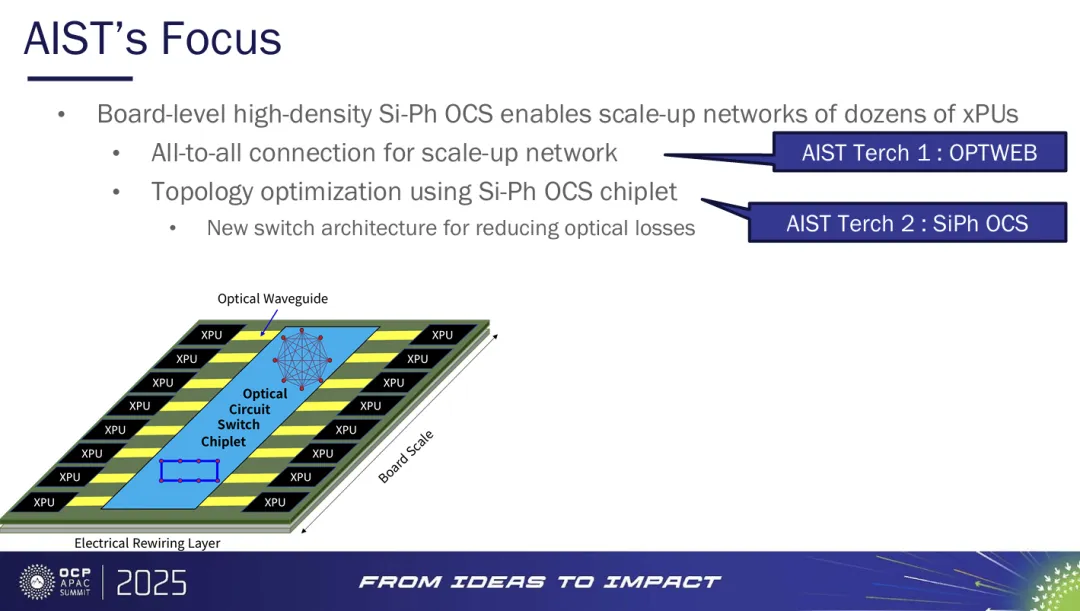
图6:AIST在板级硅基光电子OCS实现方面的方法,显示了光学线路交换Chiplet如何直接集成到处理板中,通过光波导连接多个xPU。
最有前途的发展包括路径无关插入损耗(PiLOSS)光学线路交换机,能够最小化最差情况下的光损耗,新的交换架构减少了光波导路由的复杂性,以及允许将光交换直接嵌入到处理板中的集成技术。这些进展有望使光学线路交换在最苛刻的AI应用中实用,同时保持使该技术具有吸引力的功率效率优势。
07
技术实现的具体案例
从具体技术实现来看,AIST开发的OPTWEB技术展示了硅基光电子技术在AI集群中的应用潜力。该技术利用能够进行多重光连接的硅基光电子收发器,通过使用HBM的多个内存通道,实现xPU之间内存通道的全对全连接。
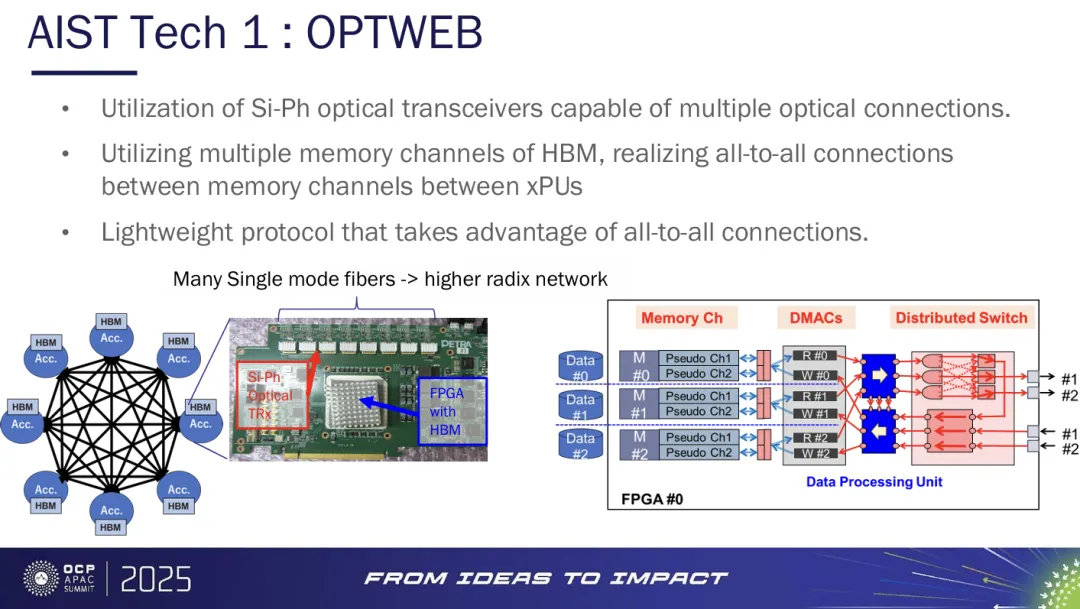
图7:OPTWEB技术如何利用硅基光电子收发器和FPGA实现多个单模光纤连接,形成更高基数的网络架构,并展示了分布式交换的内部结构。
OPTWEB技术的重要创新在于提供了利用全对全连接优势的轻量级协议。通过提供分布式交换机,现在可以进行各种集合通信。即使对于单个集合通信指令,也能够实现1微秒低开销(启动延迟)的数据传输。
性能测试结果显示,在数据大小为1 MiB或更大时,OPTWEB能够实现充分利用网络带宽的高带宽全对全通信。相比InfiniBand EDR树形网络在30%物理带宽时饱和,OPTWEB能够接近物理带宽极限,达到720 Gbps的有效带宽。
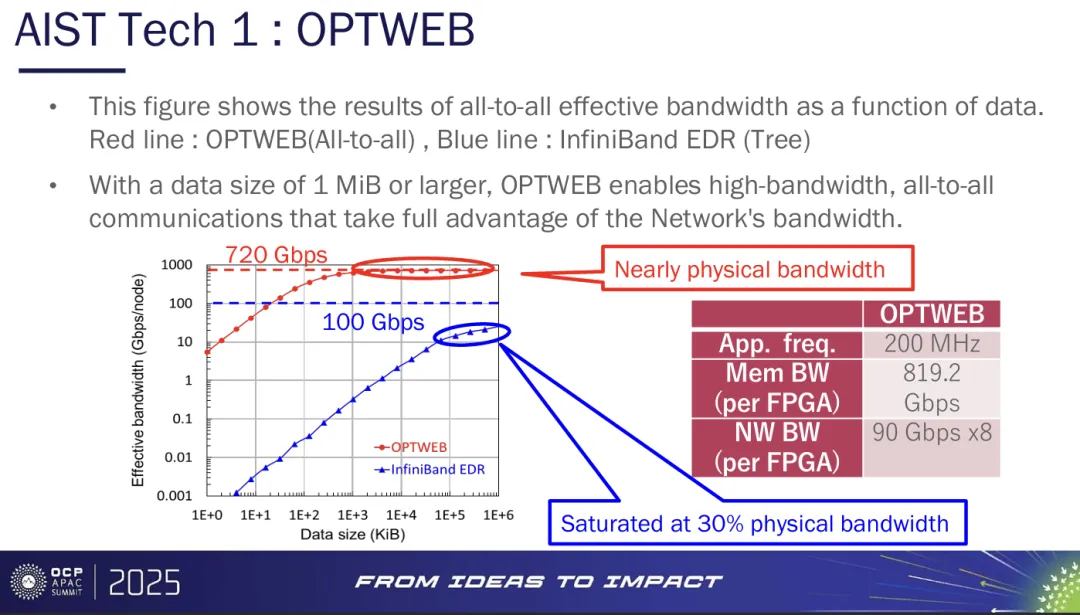
图8:OPTWEB(红线)与InfiniBand EDR(蓝线)在全对全有效带宽方面的对比,显示OPTWEB在大数据量传输时接近物理带宽极限。
08
硅基光电子OCS的技术突破
在硅基光电子OCS技术方面,AIST提出了PiLOSS(路径无关插入损耗)OCS设计,能够最小化最坏情况下的损耗值。这种32×32规格的器件尺寸仅为11毫米×25毫米,展现了硅基光电子技术的集成优势。
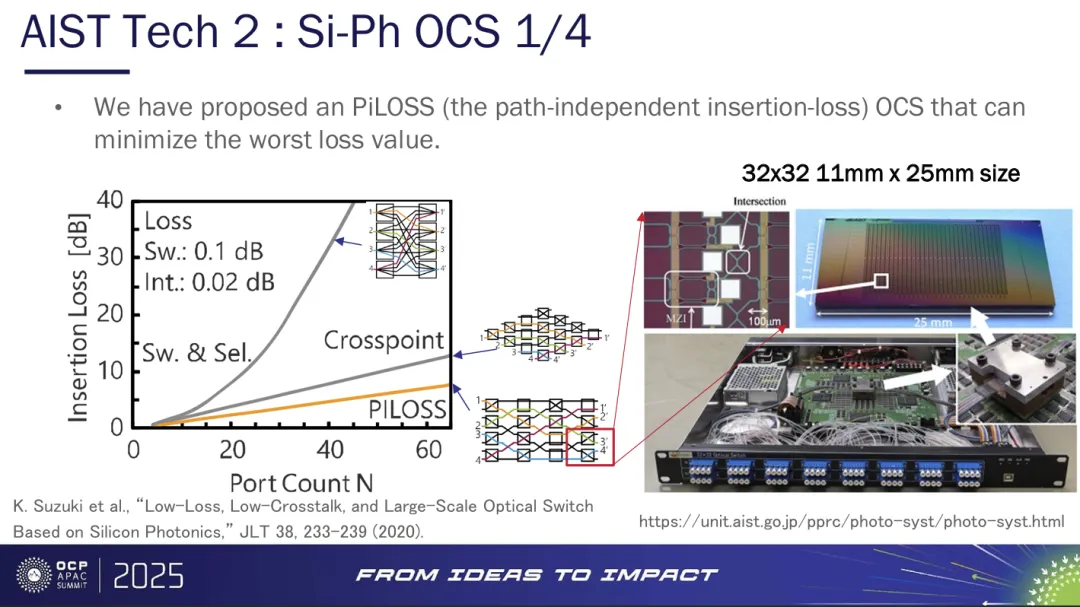
图9:AIST开发的32×32硅基光电子OCS器件的实物照片和结构示意图,展示了PiLOSS架构相比传统交叉点架构在插入损耗方面的优势。
传统光交换机配置在板级集成系统中由于大量波导交叉而导致显著损耗。AIST提出的新光交换机设计大大简化了重新布线光波导的过程,通过新的拓扑结构减少了波导交叉的数量。
实验验证表明,即使采用单级MZ交换机的简单配置,也能获得最差情况串扰为-21.1 dB的良好结果。这种性能水平足以满足高性能AI集群的通信需求。
09
光直连互联技术的应用
AIST与富士通合作开发的光直连互联技术为数据中心间的scale-out网络提供了新的解决方案。该技术提出了适用于数据中心内和数据中心间网络的中间管理控制机制,旨在提高多个数据中心中计算资源的利用效率。
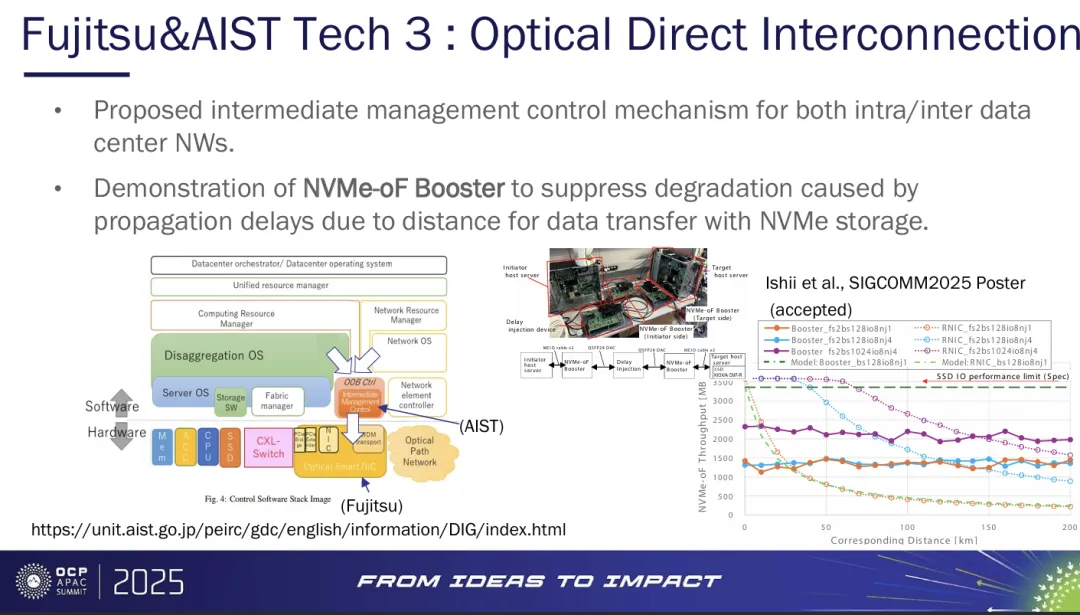
图10:光直连互联技术如何通过NVMe-oF Booster抑制因距离传播延迟引起的NVMe存储数据传输性能下降,包括完整的硬件配置和性能测试结果。
NVMe-oF Booster的演示表明,该技术能够有效抑制因距离传播延迟引起的NVMe存储数据传输性能下降。性能测试结果显示,在不同距离下,Booster技术能够显著改善吞吐量性能,特别是在长距离连接中保持较高的数据传输速率。
这种光直连技术的实现为构建跨数据中心的大规模AI计算集群提供了技术基础,使得分布式AI训练和推理任务能够更高效地利用各个数据中心的计算资源。
研究机构和产业合作伙伴持续推进光学线路交换技术的边界,开发新的拓扑结构,改进制造工艺,创建更复杂的控制系统来管理现代AI工作负载的复杂交换需求。随着这些技术的成熟,将在支持下一代AI系统中发挥越来越重要的作用。
参考文献
[1] K. Mizutani and K. Ikeda, "Optical Circuit Switching Technology for future AI Clusters," in Proc. OCP APAC Summit, Taipei, Taiwan, Aug. 5-6, 2025.
 微信公众号
 bilibili
 微信视频号