


AI驱动的计算需求增长
人工智能技术的快速发展对计算能力和存储容量提出了巨大需求。现代AI应用所需的计算能力每3.4个月翻一倍,远远超过摩尔定律传统的24个月翻倍周期。这种AI工作负载的指数级增长,从拥有数百万参数的图像识别模型发展到拥有数万亿参数的大型语言模型,彻底改变了半导体设计和封装的方法[1]。
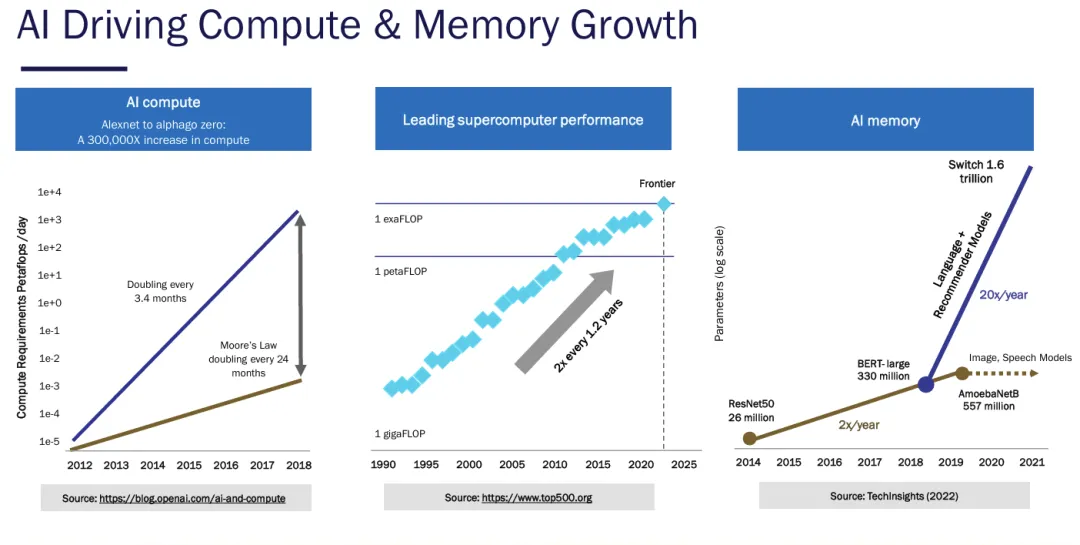
图1:三个图表展示了AI计算需求、超级计算机性能和AI存储需求的爆炸性增长,说明AI工作负载远远超出了传统摩尔定律的扩展速度。
AMD通过开发业界最广泛的AI产品组合来应对这些挑战,涵盖从云端和企业解决方案到边缘设备和终端应用的各个领域。每个市场细分都有不同的需求:云应用需要超过1000万亿次浮点运算的计算能力,重点关注总拥有成本;边缘应用需要数十到数百TOPS的算力,具有实时约束;而终端设备需要1-10 TOPS的算力,对功耗效率有严格要求。
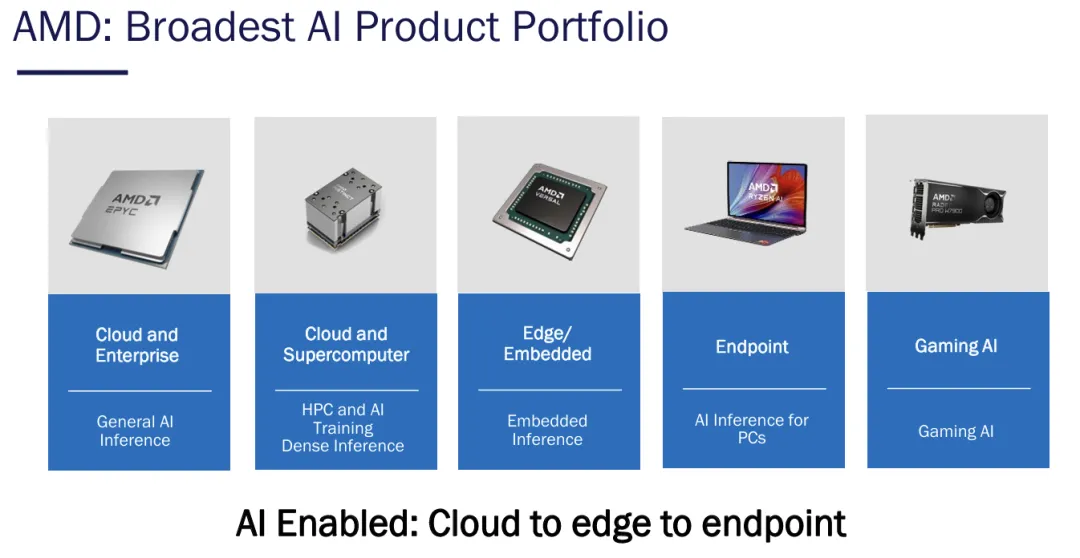
图2:AMD全面的AI产品组合涵盖从云端到游戏的五个市场细分,每个细分都有针对特定AI工作负载优化的专门硬件。
不同应用场景对AI的要求呈现多样化特征。云端和企业应用强调高达千万亿次的浮点运算能力,同时要求优化总拥有成本和支持扩展到数千节点的网络。边缘和嵌入式应用注重数十到数百TOPS的实时处理能力,对低延迟有严格要求,并且需要考虑形态因子和安全性。终端应用则需要1-10 TOPS的低精度支持,优先考虑低功耗和电池效率,并通过设备端AI保护隐私和数据。
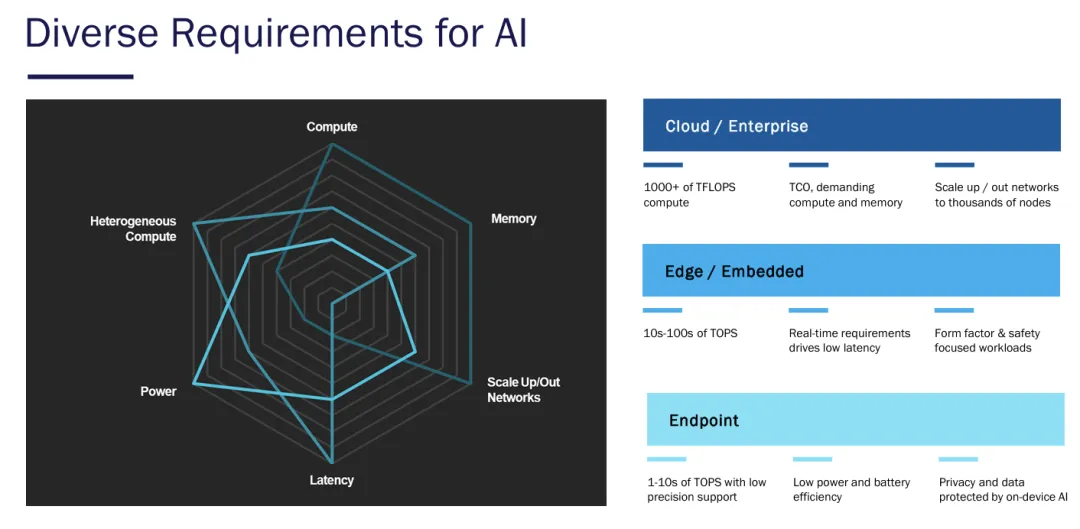
图3:左侧雷达图显示了AI应用在计算、存储、功耗、延迟等多个维度的需求特征,右侧详细说明了云端/企业、边缘/嵌入式和终端三种应用场景的具体要求。
传统扩展挑战与解决方案
半导体行业在摩尔定律放缓的背景下面临重大挑战。传统扩展优势正在减弱,不同芯片功能的扩展速度出现分化。逻辑线路继续有效缩小,但存储和模拟输入输出组件的扩展速度较慢,这创造了集成挑战。与此同时,每平方毫米的制造成本急剧增加,特别是在7纳米和5纳米等先进节点上。
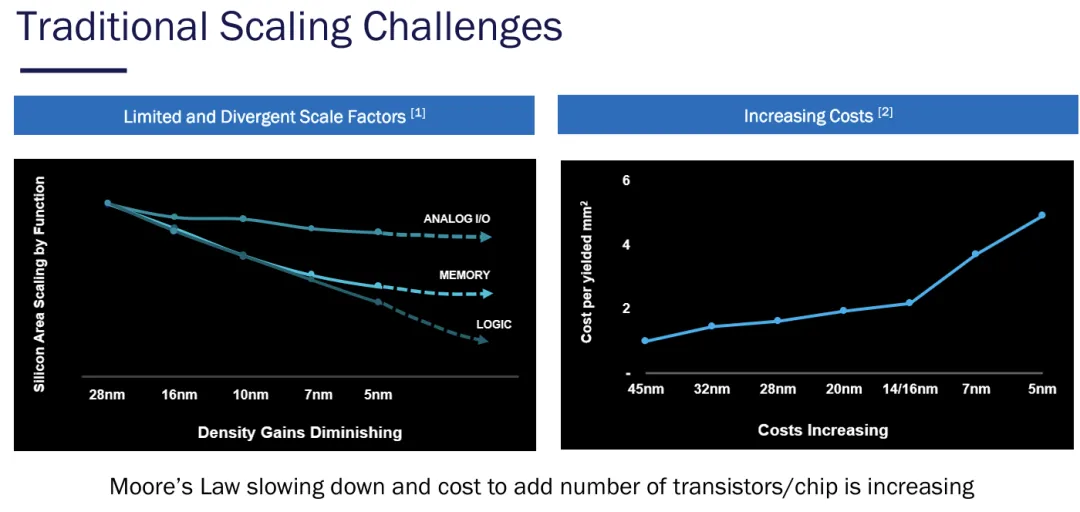
图4:两个图表说明了半导体扩展面临的根本挑战——不同芯片功能的分化扩展因子和先进节点上指数级增长的制造成本。
为了应对这些挑战,行业采用了三种关键创新:硅面积和模块尺寸的爆炸性增长、chiplet集成架构以及异构计算方法。这些策略允许设计师使用最合适的工艺技术优化不同功能,同时通过模块化设计管理成本。
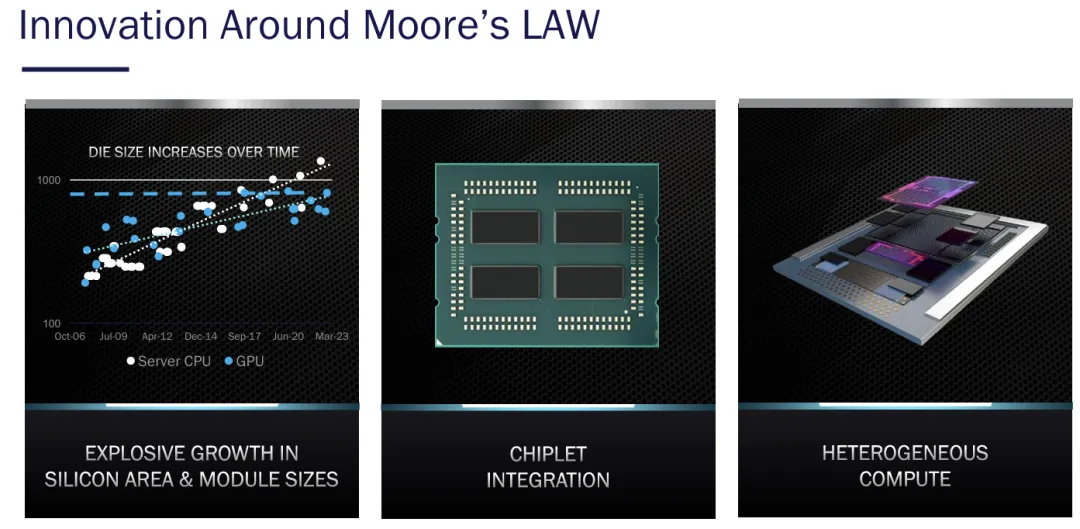
图5:三个面板展示了行业如何通过更大的芯片尺寸、chiplet集成和异构计算架构来围绕摩尔定律限制进行创新。
AMD先进封装技术领先地位
AMD通过系统性的技术演进确立了在先进封装领域的行业领导地位。从2015年的2.5D HBM集成开始,AMD在2017年发展到多芯片模块,2019年推出标准chiplet,2021年实现先进3D chiplet。公司随后在2022年引入了2.5D嵌入式扇出桥接封装,2023年推出2.5D晶圆级扇出技术,最终发展到结合水平和垂直集成优势的3.5D chiplet架构。
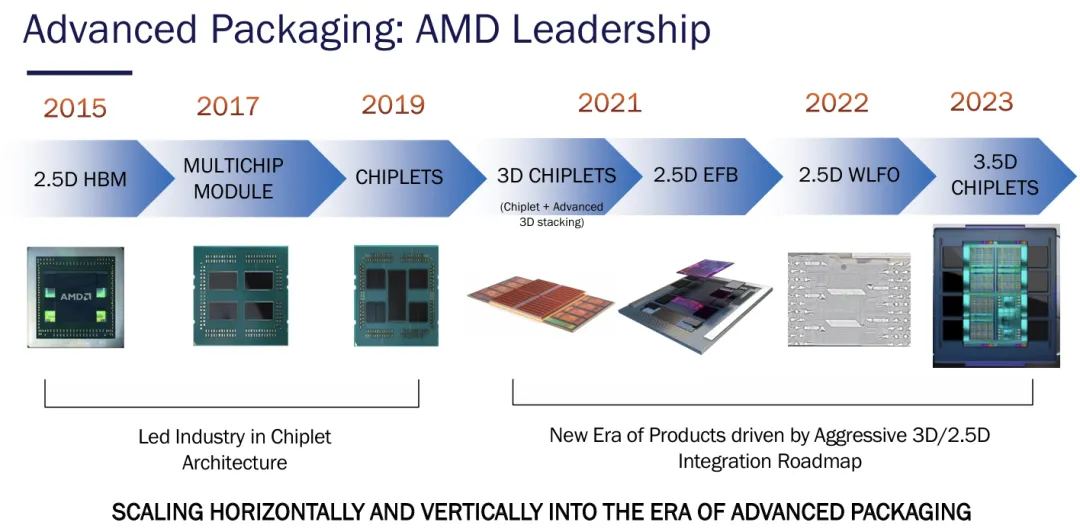
图6:时间线显示了AMD从2015年到2023年的先进封装技术演进,展现了公司从2.5D HBM通过各种chiplet技术发展到3.5D集成的历程。
选择合适的封装技术需要仔细优化多个因素,包括模块化产品的价值、chiplet良率收益、芯片开销成本、封装费用、功耗以及工程复杂性。这形成了一个多学科优化方程式,其中对带宽的架构需求、芯片分割选项和封装技术选择必须与成本和性能要求进行平衡。
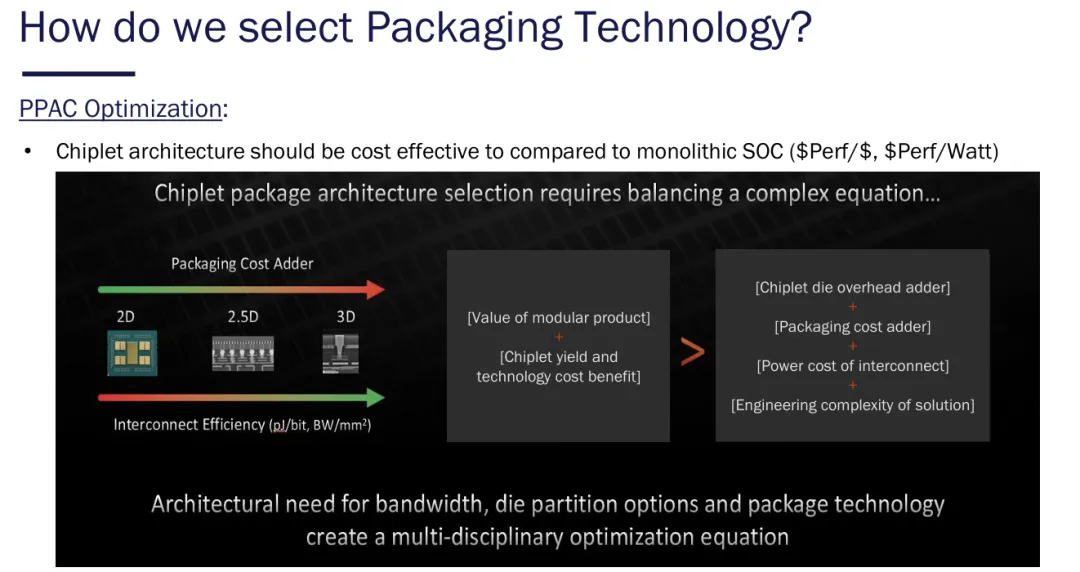
图7:复杂方程式显示了chiplet封装架构选择需要平衡多个因素,包括模块化产品价值、良率收益、开销成本和工程复杂性。
多尺度设计优化需求
先进封装技术需要在多个尺度层面进行设计优化,从最精细的3D结构(小于10微米间距)到最粗糙的LGA/BGA级别(小于1000微米间距)。这种多尺度的设计和工艺优化对管理翘曲和互连可靠性至关重要。每个层级都有特定的技术要求和制造约束,需要综合考虑结构完整性、热管理、功率传输和信号完整性等多个物理因素。
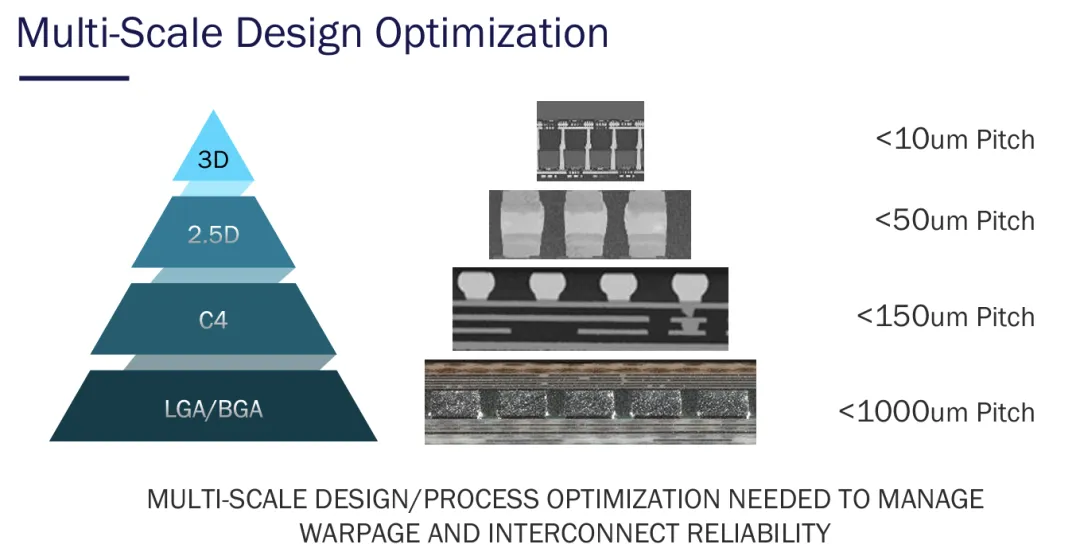
图8:金字塔形结构展示了从3D(小于10微米间距)到LGA/BGA(小于1000微米间距)的多尺度封装层次,以及相应的横截面显微镜图像。
3D CPU+GPU集成技术
AMD通过3D集成技术实现了CPU和GPU的高效整合,从CDNA 2相干存储架构发展到CDNA 3统一存储APU架构。MI250加速器采用了简化编程、低开销的第三代Infinity互连和行业标准模块化设计。而MI300A加速器则消除了冗余存储拷贝,实现了高带宽、低延迟通信,通过统一存储APU封装降低了总拥有成本。
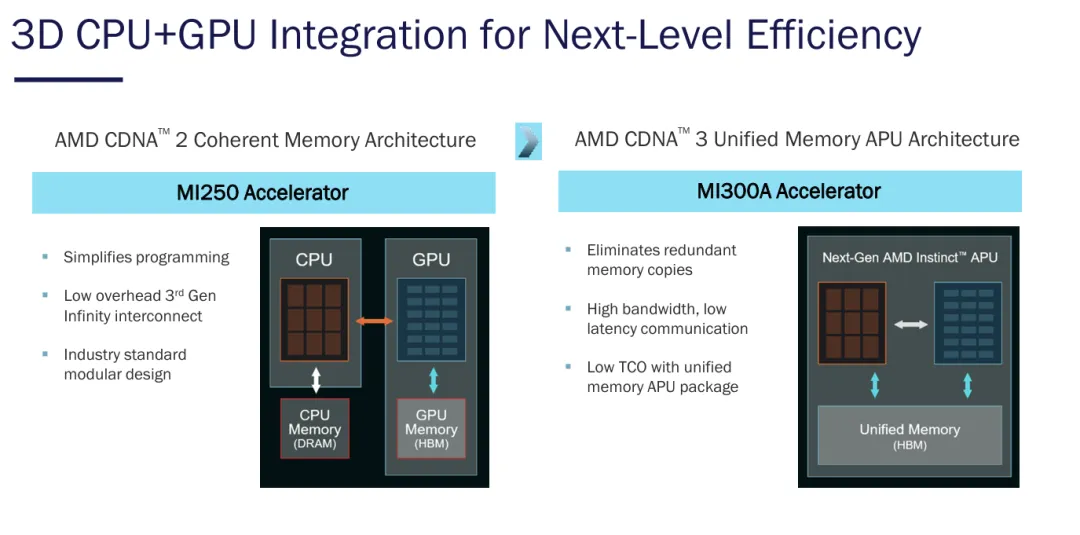
图9:对比展示了AMD CDNA 2相干存储架构(MI250加速器)和CDNA 3统一存储APU架构(MI300A加速器)的技术演进和性能优势。
MI300系列采用了模块化chiplet封装设计,集成了I/O芯片(IOD)、加速器复合芯片(XCD)和CPU复合芯片(CCD)。I/O芯片包含256MB AMD Infinity缓存和Infinity Fabric片上网络,通过AMD Infinity Fabric AP互连连接8个HBM3堆栈。加速器复合芯片包含6个AMD CDNA 3计算芯片,CPU复合芯片则包含3个8核心的Zen 4处理器。整个系统采用3.5D封装技术,结合了3D混合键合和2.5D硅interposer。
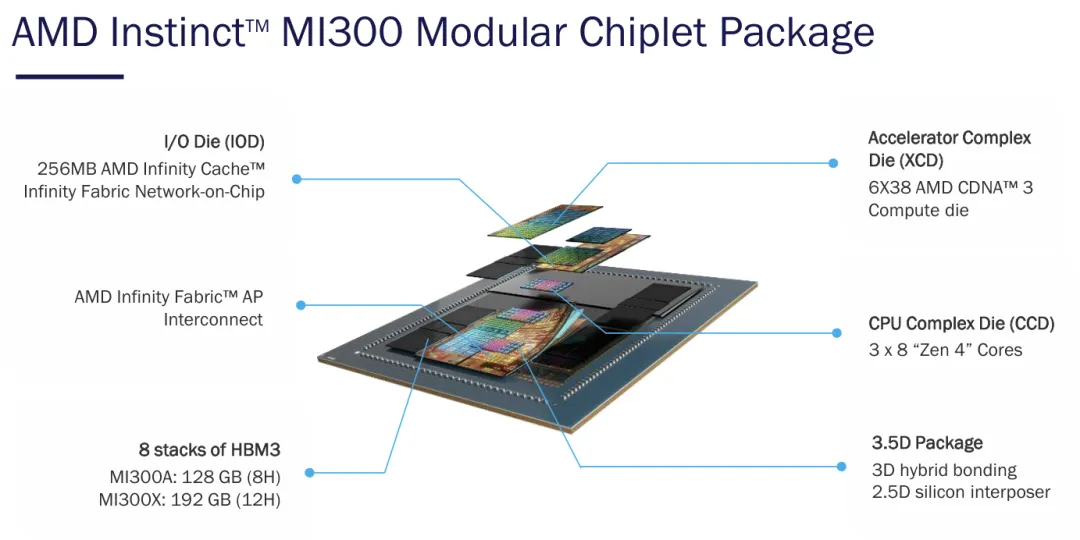
图10:AMD Instinct MI300模块化chiplet封装的详细结构,展示了I/O芯片、加速器复合芯片、CPU复合芯片以及HBM3存储堆栈的3.5D集成配置。
系统集成的未来发展方向
大型芯片模块面临多重机械挑战和机遇,需要在结构完整性、热管理、功率传输、信号完整性和架构设计之间进行权衡。这些相互关联的因素形成了复杂的设计约束,需要多物理仿真工具来进行设计优化。每个方面都会影响其他方面的设计决策,因此需要全面的系统级方法来实现最佳性能。
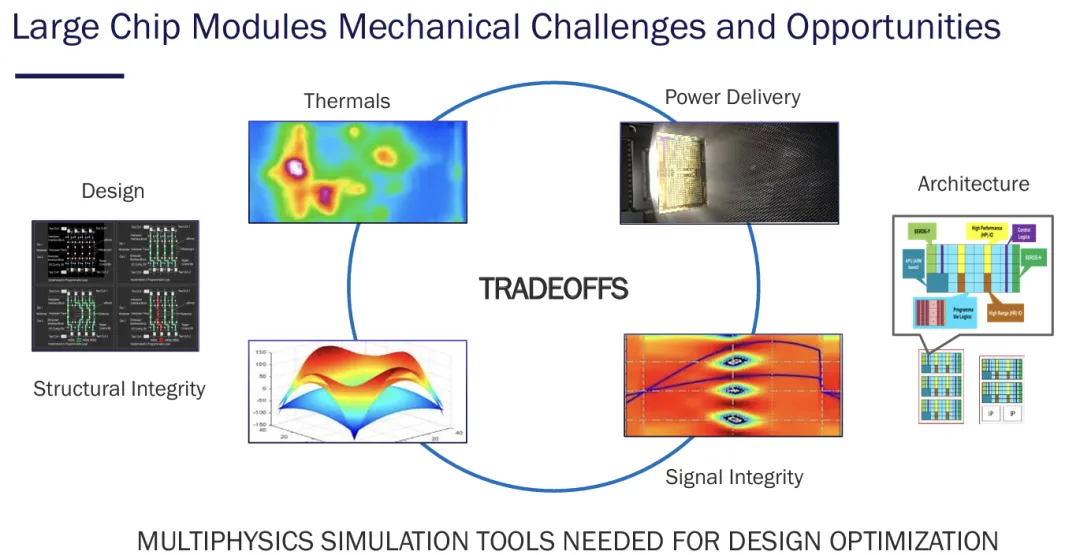
图11:圆形图表展示了大型芯片模块设计中需要平衡的多个因素,包括热管理、功率传输、信号完整性、结构完整性和架构设计之间的相互关系和权衡。
先进封装技术的未来在于计算和存储元件的更紧密集成。当前的发展路径从板载存储通过2.5D微凸点连接发展到3D混合键合,每一步都在功耗效率方面带来显著改善。板载存储每比特消耗约12皮焦耳,而2.5D HBM集成将此降低到每比特3.5皮焦耳,3D混合键合则实现了仅0.2皮焦耳每比特的卓越效率。
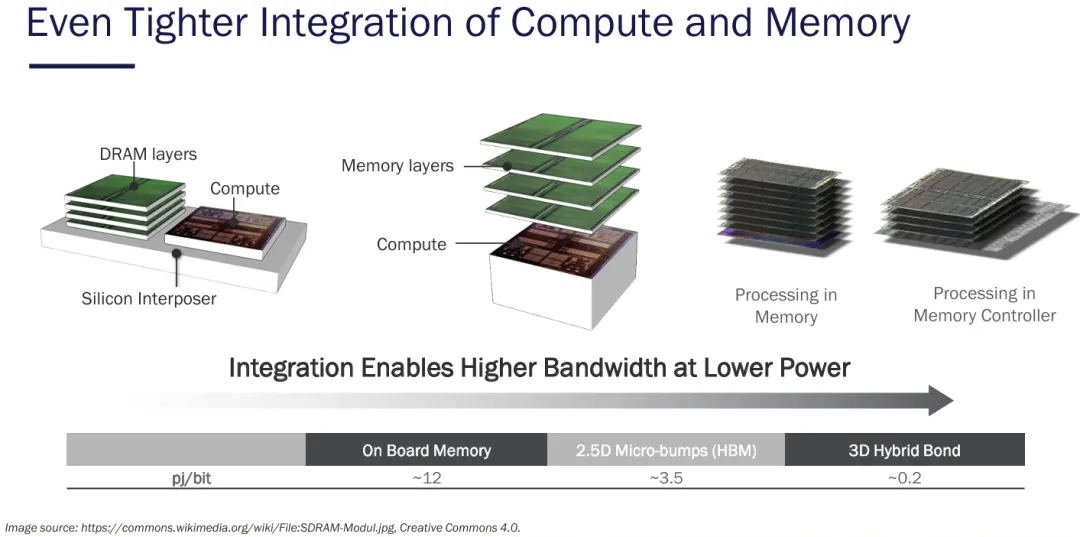
图12:展示了从传统DRAM模块通过2.5D硅interposer到存储内处理架构的日益紧密的计算和存储集成进展,以及相应的功耗效率改善。
为了实现更大规模的系统,面板级2.5D架构变得必要。与传统的晶圆级2.5D相比,面板级2.5D能够在更大的基板上集成更多组件,为持续扩展提供了重要能力。这种方法允许构建超出单个晶圆尺寸限制的大型系统,同时保持先进封装技术的优势。
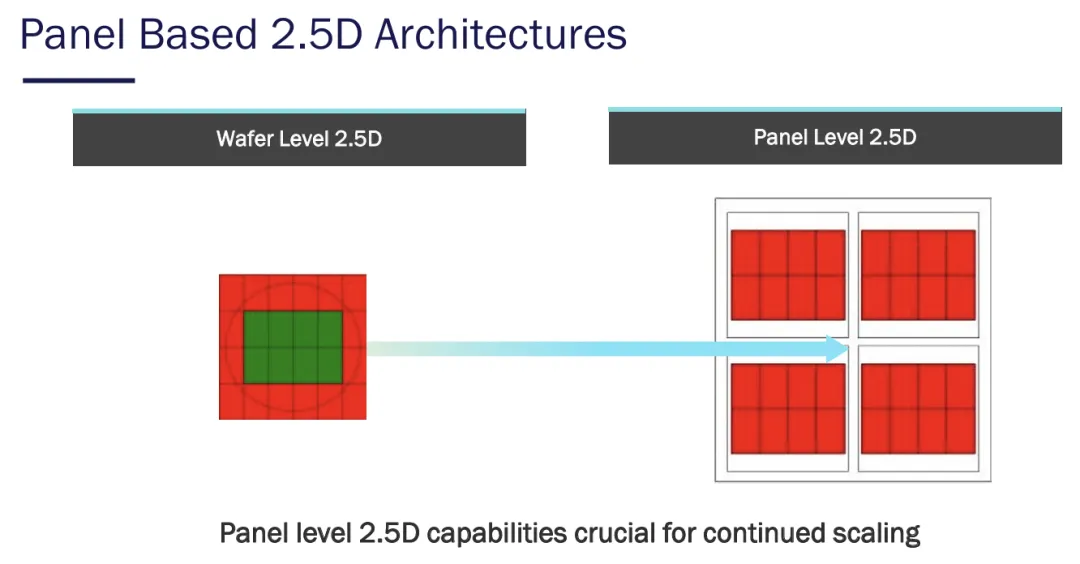
图13:对比展示了晶圆级2.5D和面板级2.5D架构的区别,说明面板级2.5D技术对于持续扩展的重要性。
未来系统封装架构展望
未来的系统封装架构将整合光电共封装技术,实现系统组件之间的高带宽、低功耗通信。这些系统将包含异构计算核心、领域专用加速器以及UCIe等标准化高速芯片间接口,全部通过先进的2D、2.5D和3D封装技术集成。这种综合方法能够实现不同计算元件的最高效集成,同时保持快速技术演进所需的灵活性。
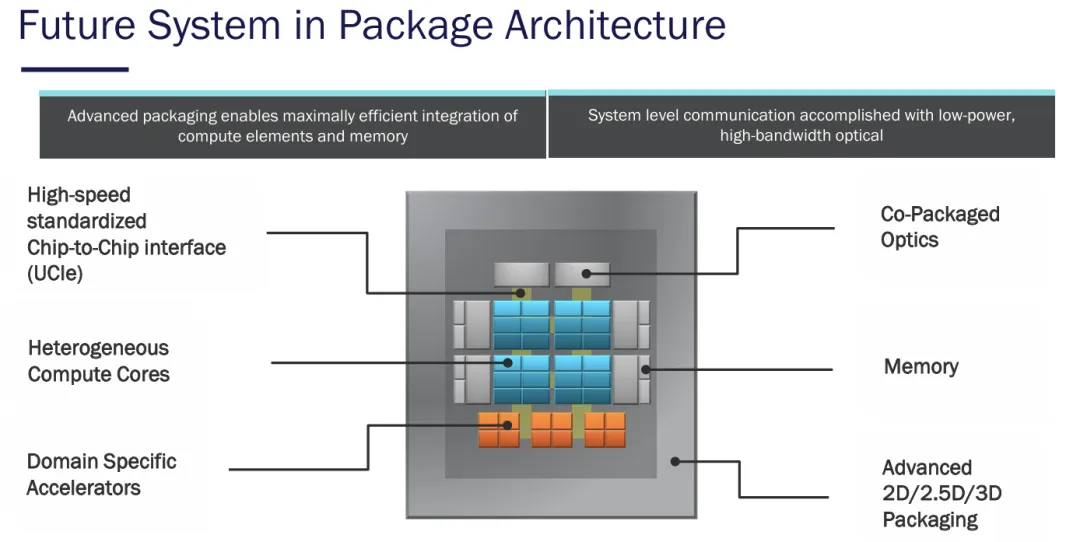
图14:系统封装架构的愿景,包含光电共封装、异构计算核心、领域专用加速器和先进多维封装集成。
这些先进架构的成功依赖于三项关键使能技术:用于高效芯片间通信的高速接口设计、用于物理集成的复杂先进封装技术,以及使用最合适处理元件优化不同工作负载的异构计算架构。这些技术的结合将支撑下一代AI和高性能计算系统的发展。
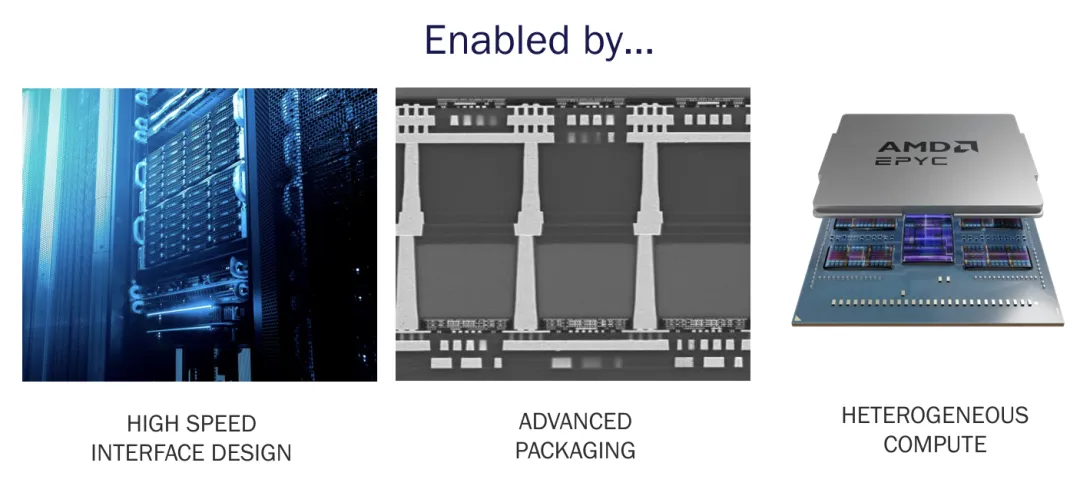
图15:三个关键使能技术的展示:高速接口设计、先进封装和异构计算,这些技术共同支撑未来计算系统的发展。
参考文献
[1] D. Wu, "AMD Advanced Packaging – Past, Present, and Future," presented at the OCP APAC Summit 2025, Taipei, Taiwan, Aug. 5-6, 2025.
END
 微信公众号
 bilibili
 微信视频号